DAQIRI平台详解:高速数据采集与实时AI推理的深度融合

引言:AI的瓶颈不在算法,在数据采集
2020年,AlphaFold2彻底改变了药物发现领域。但很少有人注意到,这一突破性成果的背后,依赖的是科学家自1971年以来积累的约17万个蛋白质结构数据。AlphaFold2由DeepMind团队开发,在2020年的CASP14(蛋白质结构预测关键评估)竞赛中以压倒性优势获胜,其预测精度首次达到实验测定水平。它所依赖的训练数据主要来自蛋白质数据银行(Protein Data Bank, PDB),这是一个自1971年由布鲁克海文国家实验室创建的全球性开放数据库,半个世纪以来由全球结构生物学家通过X射线晶体学、核磁共振和冷冻电镜等技术逐步积累而成。这个案例深刻说明了一个规律:突破性AI成果往往建立在数十年的数据基础设施建设之上。这个事实揭示了一个深刻的行业痛点:AI模型的能力上限,往往不取决于算法本身,而取决于数据采集的质量和速度。
在工业物联网、科学实验、自动驾驶等领域,高速数据采集(DAQ)系统每秒可产生数百万个数据点。DAQ(Data Acquisition)系统是将物理世界的模拟信号转换为数字信号并进行记录的硬件与软件组合,典型系统包含传感器/换能器、信号调理电路、模数转换器(ADC)和数字总线接口。现代高速DAQ系统的采样率可达数GS/s(每秒数十亿次采样),常见于粒子加速器探测器、5G基站信号分析、超声波医学成像等场景。然而,传统的数据处理流程——先采集、再存储、最后离线分析——已经无法满足实时决策的需求。传统DAQ系统的瓶颈在于数据从ADC到主机内存再到存储设备的I/O带宽限制,以及CPU串行处理架构对海量并行数据流的处理能力不足。NVIDIA开发者博客近日介绍的DAQIRI平台,正是为解决这一关键瓶颈而生。
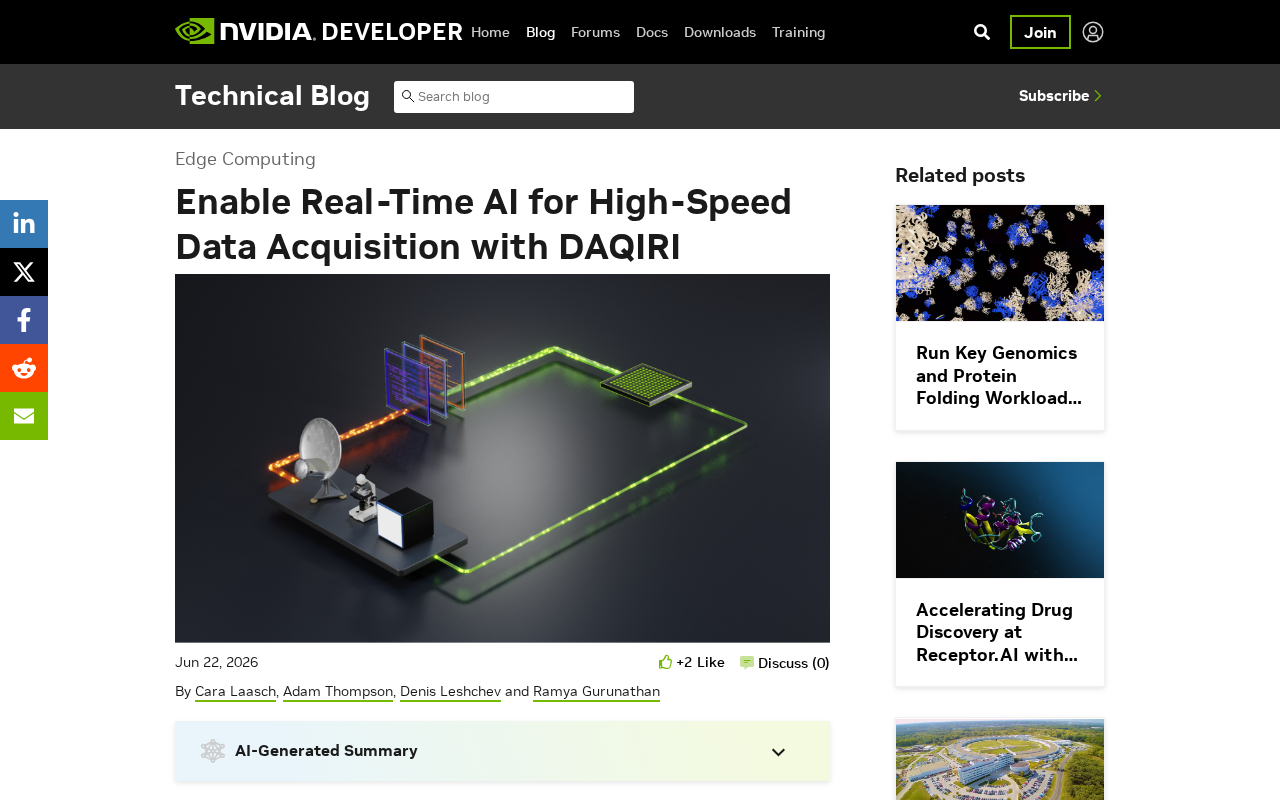
DAQIRI是什么:高速数据采集遇上实时AI推理
DAQIRI是一个将高速数据采集与实时AI推理深度融合的平台。它的核心理念很明确:不再让数据"等待"被分析,而是在数据产生的瞬间就完成AI处理。
传统的高速数据采集系统面临几个核心挑战:
- 数据洪流:现代传感器和仪器每秒可生成GB级别的数据,传统CPU处理架构难以实时消化
- 延迟敏感:在制造质检、医疗监测等场景中,毫秒级的延迟可能意味着产品缺陷或患者风险
- 存储压力:全量存储高速数据流的成本极高,但不存储又可能丢失关键信息
DAQIRI通过将NVIDIA GPU加速计算能力直接嵌入数据采集管道,实现了从"采集-存储-分析"的串行模式到"采集即分析"的并行模式的转变。
DAQIRI的架构设计与技术原理
DAQIRI的架构设计体现了几个关键的工程决策,每一项都直接影响系统的实时处理性能:
GPU直连数据流
数据从采集硬件直接进入GPU内存,避免了传统架构中CPU内存到GPU内存的数据拷贝开销。这一设计大幅降低了数据传输延迟,是实现微秒级响应的基础。
这项技术的基础是NVIDIA的GPUDirect系列技术,特别是GPUDirect RDMA(Remote Direct Memory Access)。在传统架构中,外部设备的数据必须先经过系统内存(CPU RAM),再通过PCIe总线拷贝到GPU显存,这个过程涉及多次内存拷贝和CPU中断,引入了显著的延迟。GPUDirect RDMA允许第三方PCIe设备(如网卡、FPGA采集卡)直接将数据写入GPU显存,绕过CPU和系统内存,将数据传输延迟从数十微秒降低到个位数微秒。这项技术最初为高性能计算集群间的GPU通信设计,现已扩展到数据采集、网络数据包处理等实时场景。
流式推理引擎
基于NVIDIA TensorRT等推理优化工具,DAQIRI支持对连续数据流进行实时模型推理。与批处理模式不同,流式推理引擎能够持续处理不间断的数据输入,确保每个数据点都能被及时分析。
TensorRT是NVIDIA开发的高性能深度学习推理优化器和运行时引擎,它通过层融合(Layer Fusion)、精度校准(支持FP16/INT8量化)、内核自动调优(Kernel Auto-Tuning)和动态张量内存管理等技术,将训练好的模型转换为高度优化的推理引擎。流式推理与传统批处理推理的关键区别在于:批处理需要等待积累足够数据后一次性处理,而流式推理采用滑动窗口或逐样本处理机制,数据到达即触发推理计算。这要求推理引擎具备极低的启动开销和确定性的延迟表现,NVIDIA的CUDA Streams和异步执行机制为此提供了底层支持。
可编程数据管道
用户可以灵活定义数据预处理、特征提取、模型推理和后处理的完整流水线。这种模块化设计让开发者能够根据具体业务需求快速搭建定制化的实时AI处理链路。
这种架构使得系统能够在数据到达的同时完成AI分析,将端到端延迟压缩到微秒至毫秒级别。
DAQIRI的核心应用场景
工业制造与质量检测
在高速生产线上,产品以每秒数十甚至数百件的速度通过检测工位。传统的基于规则的检测系统只能识别预定义的缺陷模式,而DAQIRI支持的实时AI推理可以:
- 对高速相机捕获的图像进行实时缺陷分类
- 对振动传感器数据进行异常检测,提前预判设备故障
- 对多传感器数据进行融合分析,实现更精准的质量判定
传统工业视觉检测系统基于手工编程的规则,如边缘检测算子、模板匹配、阈值分割等,这些方法对光照变化、产品形变和新型缺陷的适应能力有限,且每种新缺陷类型都需要工程师重新编写检测逻辑。深度学习方法(如卷积神经网络)可以从标注数据中自动学习缺陷特征,对未见过的缺陷变体具有泛化能力。然而,将深度学习模型部署到高速产线面临严峻的延迟约束:以每分钟600件产品的产线为例,每件产品的检测时间窗口仅有100毫秒,需要在此时间内完成图像采集、预处理、模型推理和结果输出的全部流程。DAQIRI的GPU直连和流式推理架构正是为满足这一严苛要求而设计。
对于追求零缺陷率的制造企业来说,从抽样检测到全量实时检测的跨越,意味着质量管控能力的质变。
科学研究与实验数据处理
正如AlphaFold2的案例所示,科学发现越来越依赖于大规模数据的实时处理。在粒子物理实验、基因测序、天文观测等领域,DAQIRI的实时AI能力可以帮助研究人员在实验进行过程中就识别出有价值的信号,而不是在实验结束后花费数周进行离线分析。
粒子物理实验是实时数据处理需求最极端的场景之一。以欧洲核子研究中心(CERN)的大型强子对撞机(LHC)为例,质子束每25纳秒交叉碰撞一次,探测器每秒产生约1PB的原始数据。由于存储和处理能力的限制,LHC采用多级触发系统(Trigger System),在硬件层面(Level-1)以微秒级延迟筛选出约1/400的事件,再通过软件层面(High-Level Trigger)进一步筛选。将AI模型嵌入触发系统,可以实现更智能的事件筛选,减少有价值物理信号的丢失率,这正是DAQIRI类技术在基础科学中的潜在应用方向。
这种"边实验边分析"的模式,有望显著缩短科研周期,加速从数据到发现的转化效率。
自动驾驶与机器人感知
自动驾驶车辆的激光雷达、摄像头和雷达每秒产生的数据量以GB计。DAQIRI的低延迟处理能力对于实现安全可靠的实时感知和决策至关重要。
一辆L4级自动驾驶车辆通常配备6-12个摄像头、1-5个激光雷达、5-6个毫米波雷达以及超声波传感器阵列,每秒产生的原始数据量可达4-20GB。激光雷达每秒生成约100万-300万个三维点云数据点,摄像头以30-60fps输出高分辨率图像。感知系统需要在50-100毫秒内完成多传感器数据的时间同步、坐标变换、目标检测、语义分割和多目标跟踪,才能为规划决策模块提供及时的环境理解。任何超过200毫秒的感知延迟在高速行驶场景下都可能导致安全风险,这使得低延迟的实时AI处理成为自动驾驶系统的刚性需求。
在机器人领域,实时处理多模态传感器数据同样是实现精准操控的前提条件。
技术优势:从事后分析到实时数据驱动
过去十年,"数据驱动"已经成为各行业的共识。但大多数组织的"数据驱动"仍然是事后分析型的——数据被采集、存储、清洗,然后在数小时甚至数天后才被分析。DAQIRI代表的实时AI数据采集范式,将"数据驱动"推进到了一个新阶段:决策发生在数据产生的同一时刻。
这一转变的意义不仅仅是速度的提升,更是决策模式的根本变革:
- 从被动响应到主动预防:实时异常检测可以在问题扩大之前就触发干预
- 从抽样分析到全量分析:GPU加速使得对每一个数据点进行AI分析成为可能,不再需要抽样
- 从人工判断到自动决策:低延迟的AI推理可以直接驱动执行器,实现闭环自动化控制
DAQIRI在NVIDIA AI生态中的定位
DAQIRI并非孤立存在,它是NVIDIA从芯片到软件、从训练到推理的完整AI生态系统中的重要一环。结合NVIDIA的GPU硬件、CUDA编程模型、TensorRT推理优化以及各种行业SDK,DAQIRI为开发者提供了一个从数据采集到AI部署的端到端解决方案。
CUDA(Compute Unified Device Architecture)是NVIDIA于2006年推出的并行计算平台和编程模型,它允许开发者使用C/C++等语言直接编写GPU并行程序。CUDA生态经过近20年发展,已形成从底层驱动到上层应用框架的完整技术栈:cuDNN提供深度学习原语加速,cuBLAS提供线性代数运算,NCCL提供多GPU通信,Triton Inference Server提供模型服务化部署。这种垂直整合的生态系统意味着DAQIRI可以无缝调用各层优化能力,而开发者在统一的CUDA生态内工作,避免了跨平台集成的复杂性和性能损失。
这种生态整合的优势在于:开发者无需在不同厂商的工具链之间反复切换,可以在统一的技术栈上完成从模型训练、优化到实时部署的全流程。
未来展望与行业思考
实时AI数据采集技术的成熟,可能会催生一批全新的应用场景——那些过去因为"数据处理太慢"而无法实现的创新。例如:
- 实时个性化医疗:根据患者实时生理数据动态调整治疗方案
- 自适应智能制造:生产线根据实时质量数据自动调整工艺参数
- 实时科学发现:实验过程中AI自动识别新现象并调整实验方向
当然,实时AI也带来了新的挑战:模型的可靠性如何在高速场景下得到保证?实时自动决策出错时的责任如何界定?数据安全与隐私在实时处理链路中如何保障?这些问题需要技术社区和行业共同探索。
数据采集的速度决定了AI的反应速度,而AI的反应速度决定了我们能解决什么样的问题。 DAQIRI所代表的实时AI数据采集范式,正在打开一扇通往更智能、更敏捷世界的大门。
核心要点
相关推荐
AI编程代理持久记忆方案:逆向解析Understand Anything插件
逆向解析Understand Anything插件:它如何为Claude Code、Codex、Cursor等AI编程代理构建本地持久知识库,通过代码地图、业务逻辑连接与增量更新实现项目级记忆,而非依赖更大的上下文窗口。
Cursor、Claude Code、Qwen Code 1.0 三大AI编程Agent横评
对比 Cursor、Claude Code 与 Qwen Code 1.0 三款 AI 编程 Agent 的差异:Qwen Code 开源且无需 Node.js,Claude Code 覆盖终端与 IDE,Cursor 支持多模型并接入 Slack 与 GitHub 评审。从开源、模型绑定和工作流入口三个维度给出选型思路。
AI Agent开发者必知的5个免费GitHub仓库
探索AI Agent开发者必知的5个免费GitHub仓库,涵盖Agent项目模板、代码生成与Claude等大模型集成工具,帮助你快速搭建和优化AI智能体,降低开发门槛。