Databricks Lakebase:为AI速度重构的数据库架构

Databricks发布Lakebase,主打毫秒级启停以适配AI时代碎片化数据库工作负载需求。
Databricks推出新产品Lakebase,将其定位为"从底层重新设计的数据库架构",核心卖点是能够以"AI速度"快速启动和关闭数据库实例,以应对AI Agent、自动化流水线等场景带来的大量短生命周期、碎片化工作负载。Lakebase在命名上延续了Databricks的Lakehouse体系,意在将事务型数据库能力整合进统一数据平台,让AI应用在同一套系统内完成数据存储、处理与模型调用的闭环。该产品已入选《Fast Company》年度科技榜单,反映出业界对"为AI重构基础设施"这一方向的关注。但目前公开信息主要来自官方宣传,缺乏独立性能基准与技术细节,其实际价值仍有待更多技术文档和第三方评测加以验证。
Databricks瞄准AI时代的数据库痛点
Databricks近期在社交平台上宣布,其新产品Lakebase入选了《Fast Company》的"Next Big Things in Tech"(下一个科技大事件)榜单。官方对Lakebase的定位十分清晰——这是一次"从底层重新设计的数据库架构"(a ground-up rearchitecture of databases),目标是让数据库能够跟上AI驱动开发的节奏。
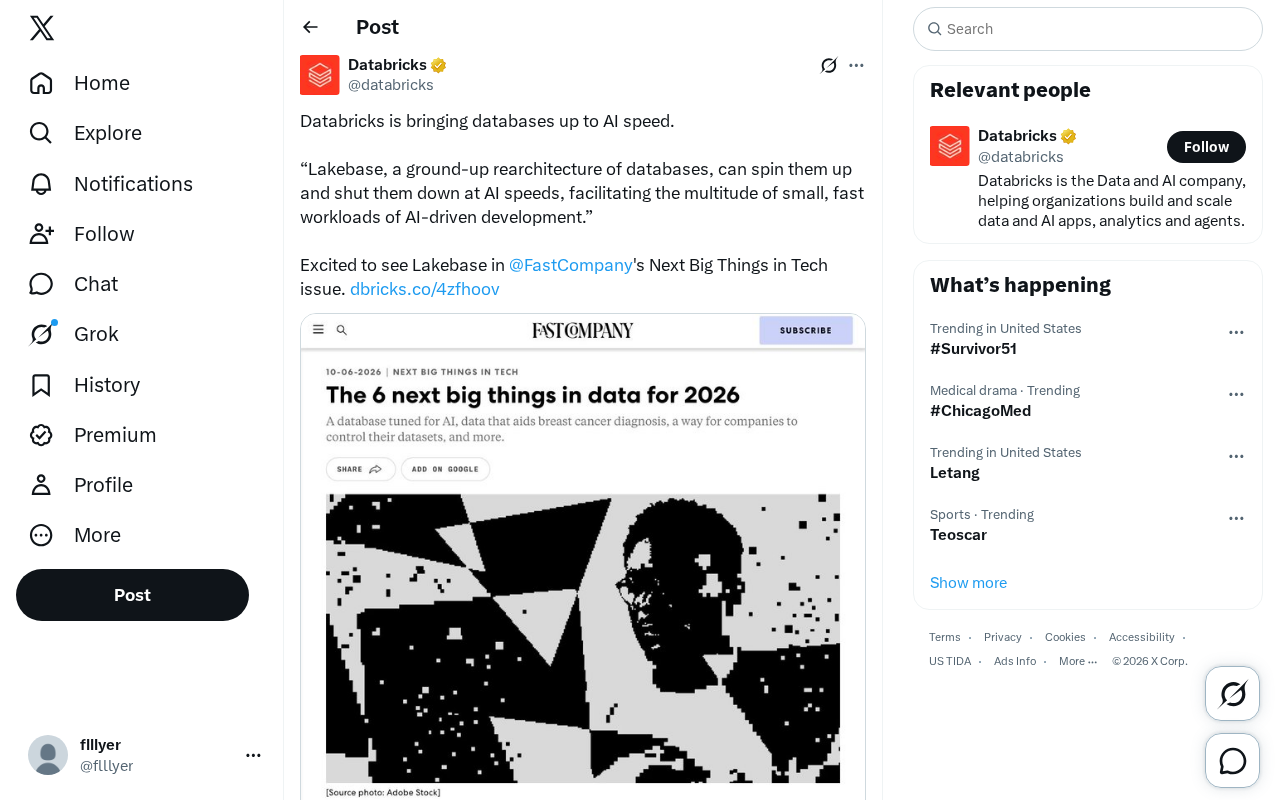
这条消息的核心关键词是"AI speed"(AI速度)。在传统数据库体系中,实例的启动与关闭往往需要分钟级甚至更长时间,这对于按部就班的企业应用或许可以接受,但在AI开发场景下却成了明显的瓶颈。Databricks试图用Lakebase解决的,正是这种节奏不匹配的问题。
为什么AI开发需要"更快"的数据库
根据官方表述,Lakebase能够"以AI速度启动和关闭数据库"(spin them up and shut them down at AI speeds),从而支撑AI驱动开发中"大量的小型、快速工作负载"(the multitude of small, fast workloads)。
这句话点出了AI应用开发的一个典型特征:工作负载碎片化。与过去长期运行、负载相对稳定的数据库使用模式不同,AI Agent、自动化流水线和实验性开发会频繁产生短生命周期的任务。每个任务可能只需要一个临时数据库实例,用完即弃。如果每次都要承担传统数据库漫长的冷启动成本,整体效率将大打折扣。
Lakebase强调的"快速启停"能力,本质上是把数据库资源变成一种可以瞬时调度的弹性单元。这与近年来云计算领域"无服务器"(Serverless)与按需计费的趋势一脉相承,只不过Databricks将这一理念更深度地绑定到了AI工作流的需求上。
AI Agent与自动化流水线对数据库提出的挑战,与微服务化浪潮颇为相似,但节奏更极端。一个典型的AI Agent在执行任务时,可能需要在几秒内完成:检索上下文记忆、写入中间状态、调用工具并记录结果、最终提交或回滚——这类操作要求数据库具备亚秒级甚至毫秒级的冷启动能力。传统关系型数据库(如PostgreSQL、MySQL)在实例初始化阶段需要完成缓冲池预热、WAL恢复等操作,冷启动往往在数十秒以上,容器化部署也难以将其压缩到可接受范围。近年来出现的Neon、PlanetScale等"Serverless Postgres"方向的产品,正是在尝试用存算分离和即时分支(instant branching)等技术突破这一瓶颈。Databricks以自身的大规模云基础设施积累切入这一赛道,Lakebase所标榜的"AI速度启停"能否在架构上拿出差异化答案,是外界最关注的技术问题之一。
从Lakehouse到Lakebase的演进逻辑
熟悉Databricks的人会注意到"Lakebase"这个命名的用意。Databricks长期以"Lakehouse"(湖仓一体)架构著称,主张融合数据湖与数据仓库的优势。而"Lakebase"在名称上延续了这一体系,暗示它要把事务型数据库(database)的能力也纳入到统一的数据平台之中。
对于企业而言,这种整合有其现实吸引力:开发者不必在分析系统与业务数据库之间来回搬运数据,AI应用可以在同一套平台上完成从数据存储、处理到模型调用的闭环。被《Fast Company》选入年度科技榜单,也侧面反映出业界对这类"为AI重新设计基础设施"方向的认可。
Lakehouse架构的核心思路是:以开放格式(如Delta Lake、Apache Iceberg)将数据存储在对象存储(S3、ADLS等)上,同时在其之上提供类似数据仓库的ACID事务、元数据管理和查询优化能力。这样一来,数据科学家需要的原始数据湖灵活性,与BI团队需要的结构化查询性能,理论上可以在同一份数据上共存,无需ETL将数据在两套系统间来回复制。Databricks于2020年正式提出Lakehouse概念,并以Delta Lake开源项目为技术基础推动行业采纳。Lakebase在此基础上试图再向前一步:现有Lakehouse擅长的是分析型(OLAP)查询,而大量AI应用还需要高频读写的在线事务处理(OLTP)能力——例如存储用户会话状态、Agent的记忆与工具调用记录等。如果Lakebase能够在同一平台上同时承载OLAP与OLTP,将进一步减少企业维护多套异构数据库系统的复杂度。
需要理性看待的部分
必须指出的是,目前公开的信息主要来自Databricks的官方宣传口径与一则榜单入选消息,尚缺乏独立的技术细节、性能基准或第三方评测数据。诸如"AI速度"具体指多少毫秒级的启停、底层采用何种存储与计算分离方案、与现有PostgreSQL兼容性如何等关键问题,都还有待官方技术文档进一步披露。
因此,Lakebase目前更像是一个清晰的产品愿景与方向标志,而非已被充分验证的成熟方案。它反映出的真正信号在于:随着AI开发模式的普及,数据库这一看似成熟稳定的基础设施层,正在被重新审视和改造,以适配一个节奏更快、负载更碎片化的新时代。
小结
Databricks Lakebase代表了基础设施厂商对AI时代的一种回应——不只是在模型和算力层面发力,也在数据库底层寻求重构。对于关注AI工程化与数据平台演进的开发者和企业技术决策者来说,这是一个值得持续跟踪的方向。待更多技术细节和实测数据公开后,才能对其真实价值做出更准确的判断。
相关推荐

Claude Code零基础入门:从环境搭建到国产模型对接全流程
Claude Code零基础教程,手把手讲解Node.js与Git Bash环境搭建、npm安装Claude Code,以及国内用户如何用DeepSeek国产模型对接绕过IP封锁,附实战HTML待办软件演示。
Claude Code 零基础入门:非工程师也能配置AI助理
Claude Code(CC)零基础入门教程:非工程师如何从安装注册、配置终端CMUX、建立cloud.md记忆档案,到接入Firecrawl和Playwright等MCP外挂工具,打造真正能帮你做事的AI工作助理。

Claude 完整入门指南:Chat、Cowork、Skills 与 Claude Code 实战
Claude 完整入门实战指南,涵盖账号配置、GCAO 提示词框架、Projects 项目、Artifacts 可视化、Cowork 本地操作、Skills 技能构建、Claude Code 编程与 Netlify 网站部署全流程,帮你把 Claude 用成真正的数字员工。