Databricks如何用Unity Gateway管理万人级AI模型部署

Databricks通过统一AI网关实现新模型当天全员可用,并以真实使用数据驱动模型选型决策。
Databricks公开了其企业级AI落地策略的核心框架:以"新模型发布第一天全员可用"为目标,通过Unity Gateway这一统一入口层,集中管理模型访问权限、调用预算与模型切换,将原本分散、难以治理的模型调用行为收敛到可观测的统一平面。这一架构将接入新模型的操作标准化,使工程团队无需逐一改造下游应用。在此基础上,Databricks采用数据驱动的模型治理方式——先快速铺开使用,再基于真实的使用频率、任务表现与成本回报来决定哪些模型值得长期投入,而非依赖部署前的静态理论评估。这一框架对企业AI落地提供了可复制的范式参考。
让员工第一天就用上最强模型
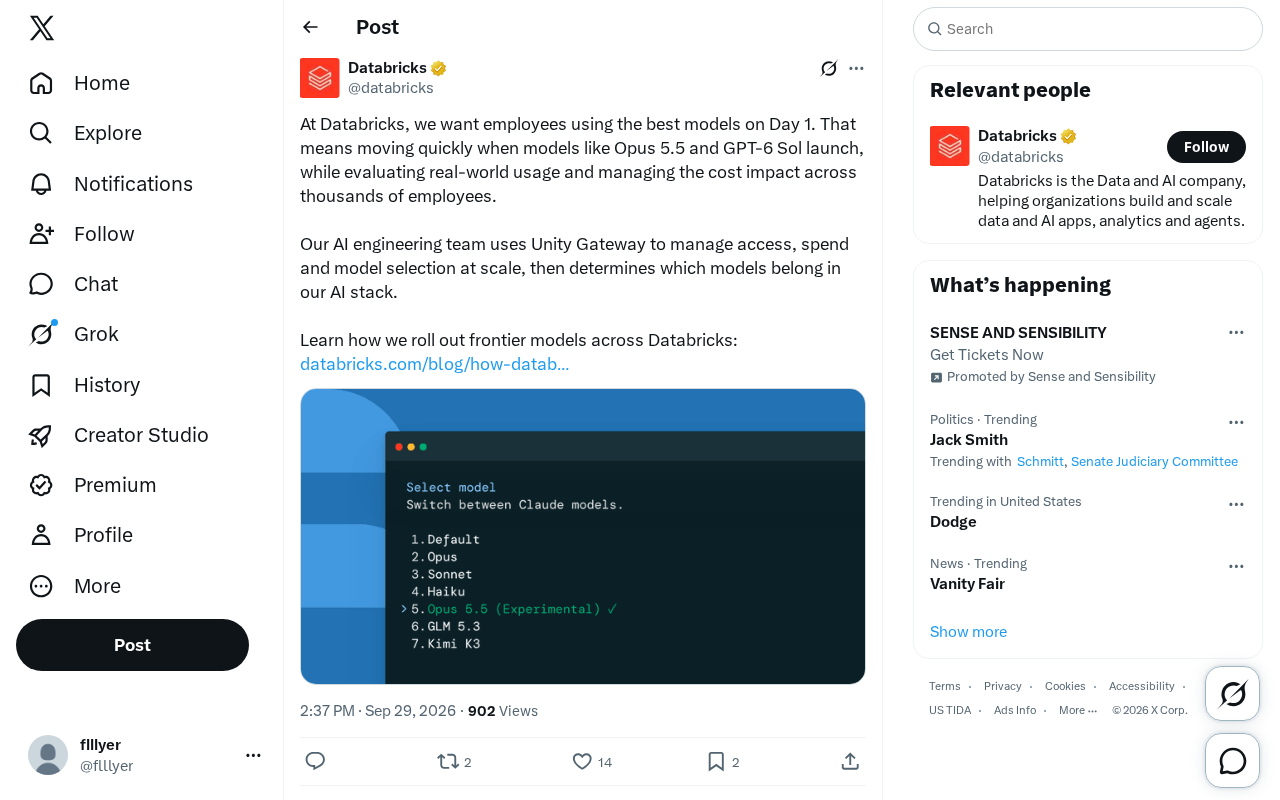
Databricks公开了其内部推进前沿AI模型落地的策略,核心目标只有一句话:让员工在新模型发布的第一天就能用上最好的模型。当业界出现如Opus 5.5、GPT-6 Sol这类新一代前沿模型时,企业面临的不是要不要用,而是如何快速、可控地铺开使用。
对于一家拥有数千名员工的公司来说,这背后隐藏着三个必须同时解决的难题:如何快速接入新模型、如何评估真实场景下的使用效果、以及如何在大规模使用中控制成本。这三点看似简单,却是几乎所有大型组织在采用生成式AI时都会撞上的现实门槛。
三大挑战:速度、评估与成本
Databricks的表述里透露出企业级AI落地的核心矛盾。第一是速度——前沿模型迭代极快,慢一步就意味着员工的生产力和创新能力落后。第二是评估——新模型的宣传指标和实际业务表现往往存在差距,企业需要基于真实使用数据来判断模型是否真正带来价值。第三是成本——当上千名员工同时调用高性能模型,token消耗和API费用会迅速累积,缺乏管控极易失控。
这三者之间存在张力:追求速度可能牺牲评估的严谨性,而严格的成本管控又可能拖慢部署节奏。Databricks的解法,是通过一套统一的网关系统来同时兼顾这三点。
Unity Gateway:统一的模型访问中枢
据Databricks披露,其AI工程团队使用Unity Gateway来在规模化层面管理三件事:访问权限(access)、支出(spend)和模型选择(model selection)。这实际上是一个企业级AI模型的统一入口层。
通过这样一个中枢,企业可以集中管理谁能访问哪些模型、每个团队或个人的调用预算,以及在多个可选模型之间进行灵活切换。这种架构的价值在于把分散的模型调用行为收敛到一个可观测、可治理的平面上——管理员不再需要为每个新模型单独搭建接入流程,也能实时掌握全公司的AI使用与花费情况。
更关键的是,网关层让"快速接入新模型"变成了可复用的标准动作。当Opus 5.5或GPT-6 Sol这样的新模型出现时,工程团队只需在网关中完成配置,就能让全员快速用上,而不必逐一改造下游应用。
从架构设计角度看,Unity Gateway本质上是一个AI模型路由代理层(AI Gateway / LLM Proxy),这类组件在企业AI工程领域近两年迅速成为基础设施标配。其核心原理是在业务应用与底层模型API之间插入一个中间层,统一暴露单一端点给下游调用方。类似理念的开源实现包括LiteLLM、PortKey、Kong AI Gateway等。这类网关通常具备以下能力:API密钥统一管理(避免各团队各自持有供应商密钥带来的安全风险)、按团队或用户的Token配额限制、跨供应商的模型别名路由(即业务代码不需感知背后究竟是Claude还是GPT),以及调用日志的集中聚合。对Databricks而言,Unity Gateway的命名也暗示其与Unity Catalog(该公司的数据与AI资产治理平台)存在整合,意味着模型访问权限可与企业已有的数据权限体系打通,而非另起一套孤立的管控机制。
从使用数据到AI技术栈决策
Databricks的流程还有一个值得关注的闭环:先让员工用起来,再基于真实使用情况来决定哪些模型应该进入公司的正式AI技术栈。
这是一种数据驱动的模型治理思路。与其在部署前做大量理论评估,不如先在受控范围内快速铺开,通过实际的使用频率、任务表现和成本回报来筛选出真正值得长期投入的模型。网关提供的用量与支出数据,正是这类决策的依据。
这套做法对其他希望规模化采用AI的企业颇有借鉴意义:模型选型不应是一次性的静态决定,而应是一个随使用数据不断迭代、优胜劣汰的动态过程。
这种"先部署、后评估"的思路在方法论上对应的是**影子测试(Shadow Testing)与在线评估(Online Evaluation)**范式,与传统软件发布中的金丝雀部署(Canary Release)逻辑类似。区别于离线基准测试(Offline Benchmark)——例如在固定数据集上跑MMLU或HumanEval分数——在线评估直接捕捉真实用户的行为信号:哪些请求被重试了(暗示结果不满意)、哪类任务的完成率更高、特定模型在哪个部门被使用得更频繁。这类信号比实验室指标更能反映业务价值,但需要系统性地收集与分析。网关层的日志基础设施正是让在线评估成为可能的前提:只有调用数据被集中记录,才能做跨模型、跨团队的横向比较,进而形成"哪个模型值得续费/深度集成"的量化判断依据。
对企业AI落地的启示
Databricks这条内容虽然简短,但勾勒出了一个成熟的企业级AI采用框架:以"第一天就用最好模型"为目标,以统一网关为技术底座,以真实使用数据为决策依据,在速度、效果与成本之间取得平衡。
对于正在探索大规模AI部署的团队而言,核心启示有两点。其一,前沿模型的接入需要一层抽象——统一网关能显著降低切换与治理成本。其二,模型评估应当嵌入真实业务流程,而非停留在实验室基准。谁能更快、更省、更聪明地把新模型交到员工手里,谁就能在AI竞争中占据先机。
相关推荐

一场与Grok的对话能否影响重大决策?素材不足的警示
一则关于美国因与Grok对话影响委内瑞拉决策的Hacker News标题引发关注,但缺乏正文与信源。本文探讨此类耸动标题的识别方法与AI在决策中的真实边界。

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。