DataBugBench:主流大模型能否揪出Python数据科学的隐形Bug?

DataBugBench测试5款LLM诊断Python数据科学隐形Bug,Claude 3.5 Sonnet以满分夺冠,数据泄漏类问题是共同软肋。
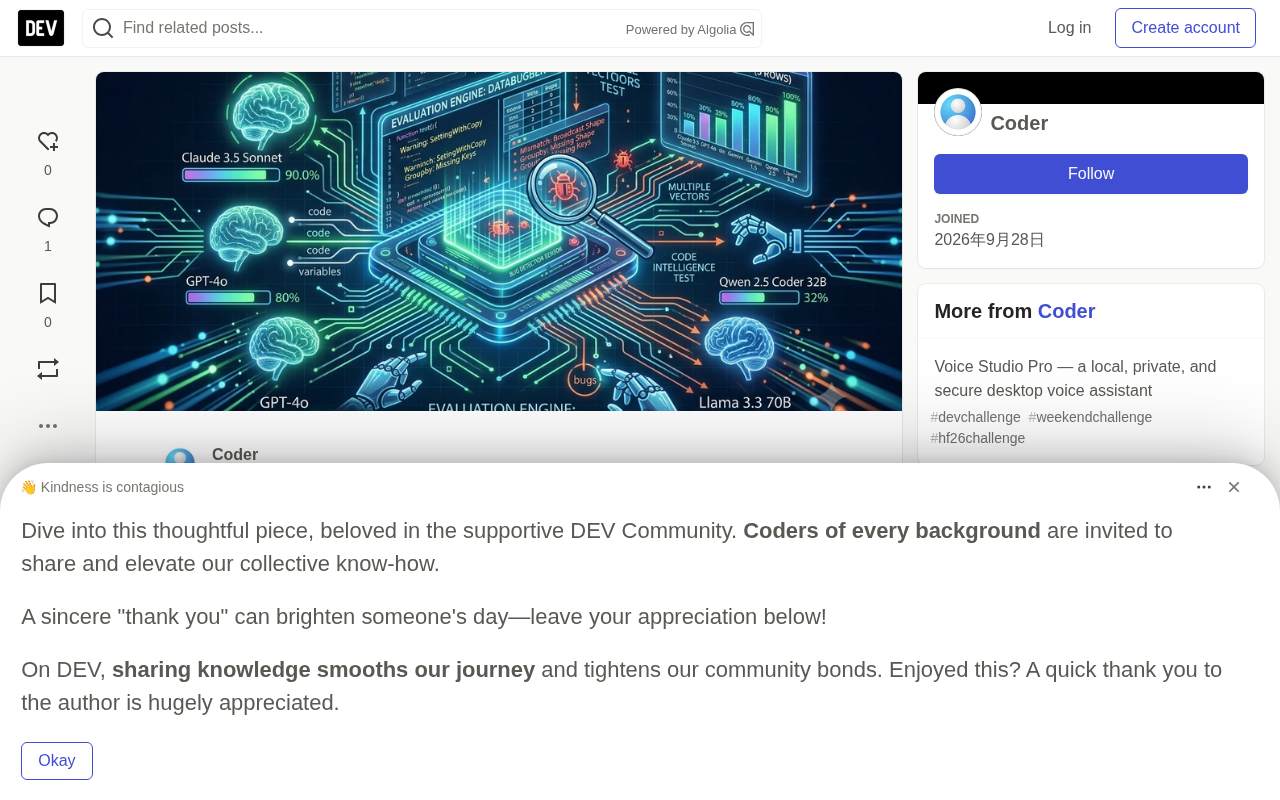
DataBugBench是一个专门评估大语言模型调试Python数据科学隐形Bug能力的新基准,覆盖Pandas链式赋值误修改、Groupby分组键丢失、NumPy广播维度错误、特征缩放数据泄漏、dropna后索引断裂五类常见陷阱——这些Bug的共同特点是代码能正常运行却给出错误结果。测试对象包括Claude 3.5 Sonnet、GPT-4o、Gemini 1.5 Pro、Qwen 2.5 Coder 32B和Llama 3.3 70B。结果显示Claude 3.5 Sonnet以5/5满分居首,GPT-4o与Qwen 2.5 Coder 32B以80%并列第二,Gemini 1.5 Pro和Llama 3.3 70B各得60%。值得注意的是,参数量仅32B的代码专精模型Qwen打平了通用旗舰GPT-4o,印证了专项训练对隐形逻辑Bug的针对性价值。该基准提醒业界,评估AI助手"能否发现不崩溃的逻辑错误"与"能否写出正确代码"同等重要,但因每类问题仅含单个样本,结论更适合作为趋势参考。
数据科学代码的Bug有两种:一种是直接报错崩溃的语法错误,另一种是程序照常运行、却悄悄给出错误结果的"隐形Bug"。后者才是真正的噩梦。一个名为 DataBugBench 的新基准测试,正是针对这类场景评估了五款主流大语言模型(LLM)的调试能力——结果揭示了当前AI在真实数据管道场景中的真实水平。
为什么要测"隐形Bug"
大模型在 LeetCode 式的合成题目上表现亮眼,但真实世界的数据科学管道往往不是因为语法错误而失败,而是栽在"运行不报错、结果却错了"的逻辑陷阱上。DataBugBench 的设计者正是抓住了这个痛点,专门构建了针对 Pandas、NumPy 和 Scikit-Learn 代码的诊断测试。
基准聚焦五类在数据工程中极为普遍的隐患:
- Pandas SettingWithCopyWarning 引发的误修改:链式赋值导致修改作用在副本而非原始数据上。
- Groupby 聚合时丢失分组键:聚合逻辑看似正确,实则遗漏关键维度。
- NumPy 隐式广播的维度不匹配:数组形状在广播机制下被静默扭曲。
- 特征缩放中的数据泄漏(Data Leakage):在训练/测试拆分前做归一化,污染了模型评估。
- 删除 NaN 后的索引不连续:dropna 之后索引断裂,后续按位置取值出错。
这五类问题的共同特征是:代码能跑完,不抛异常,但分析结论已经悄悄错了。对数据科学从业者而言,这类Bug的隐蔽性和危害性远超普通报错。
数据泄漏(Data Leakage) 值得单独说明,因为它在五类问题中隐蔽性最强、危害最大。所谓数据泄漏,是指在模型训练过程中,测试集的信息"提前泄露"给了训练过程,导致模型评估指标虚高,但在真实部署中表现大幅下滑。最常见的场景是:在 train_test_split 之前对全量数据做 StandardScaler 归一化——这意味着缩放参数(均值、标准差)是从测试集数据中计算出来的,模型实际上已经"见过"测试集的统计信息。正确做法是先拆分,再仅在训练集上 fit,然后用同一个 scaler 对测试集做 transform。这类错误不会触发任何异常,模型也会正常收敛,但最终报告的准确率或 AUC 是不可信的,在生产环境中可能造成严重决策失误。
五款模型同台竞技
测试覆盖了五款当下主流的前沿模型,意在观察"代码专精"对调试精度的实际影响:
- Claude 3.5 Sonnet
- GPT-4o
- Gemini 1.5 Pro
- Qwen 2.5 Coder 32B
- Llama 3.3 70B
这个组合既包含通用旗舰模型,也纳入了专门针对代码优化的 Qwen 2.5 Coder,便于横向比较通用能力与专项训练在调试任务上的差异。
测评结果:谁最会抓隐形Bug
最终的通过率结果如下:
| 模型 | 通过情况 | 准确率 |
|---|---|---|
| Claude 3.5 Sonnet | 5/5 | 100.0% |
| GPT-4o | 4/5 | 80.0% |
| Qwen 2.5 Coder 32B | 4/5 | 80.0% |
| Gemini 1.5 Pro | 3/5 | 60.0% |
| Llama 3.3 70B | 3/5 | 60.0% |
Claude 3.5 Sonnet 实现了满分通过,在五类隐形Bug上全部给出正确诊断与修复。GPT-4o 与专精代码的 Qwen 2.5 Coder 32B 并列第二,均为 80%。值得关注的是,参数规模仅 32B 的 Qwen 2.5 Coder 竟与 GPT-4o 打平,印证了代码专项训练在复杂数组形状与广播错误上的"以小搏大"效应。
关键洞察
隐形逻辑错误最难搞定。测试结果清晰显示,模型对显式语法错误几乎都能轻松修复,但在数据泄漏这类"代码照常运行、结果却不对"的问题上频频失手。这类Bug需要模型理解数据流的时序逻辑——比如归一化必须在拆分之后进行——而非单纯的语法层面纠错。
专项训练确实有效。Qwen 2.5 Coder 以较小的参数量跑赢两款更大的通用模型,说明针对代码场景的专门优化,能让模型在数组形状、内存视图、广播机制等底层细节上建立更可靠的直觉。这对资源受限的部署场景是个积极信号。
Pandas SettingWithCopyWarning 是另一个值得深入理解的典型案例。当你对 DataFrame 进行链式索引(如 df[df['col'] > 0]['val'] = 1)时,Pandas 无法保证第一步切片返回的是原始数据的视图(view)还是独立副本(copy)。若返回副本,赋值操作只会修改副本,原始 DataFrame 毫无变化,但代码不会报错。这种行为依赖 Pandas 内部的内存布局,在不同版本和数据形状下结果不一致,极难通过肉眼排查。正确修复方式是使用 .loc 进行单次索引赋值(df.loc[df['col'] > 0, 'val'] = 1),从根本上避免链式赋值的歧义。Pandas 2.0 已将 Copy-on-Write 设为默认行为,在一定程度上缓解了这一问题,但大量遗留代码仍面临这一风险。
对AI数据科学助手的意义
DataBugBench 的结论指向一个方向:前沿大模型在标准代码生成上已经相当成熟,但要真正胜任数据管道的调试,还需要对隐式状态、内存视图和数据泄漏有更深层的理解。
当前主流的编程基准大多围绕"能否写出正确代码"展开,而 DataBugBench 提醒业界,评估"能否发现不崩溃的逻辑Bug"同样关键。只有把这类隐形缺陷纳入评测体系,才能构建出真正可靠的AI数据科学助手——否则,一个看似给出合理结果、实则存在数据泄漏的AI建议,可能比直接报错更危险。
需要说明的是,该基准每类问题仅用单个样本(5/5、4/5 的分母为 5),样本量较小,结论更适合作为趋势参考而非严格排名。感兴趣的读者可查阅作者在 Kaggle 上公开的完整评测代码。
相关推荐

JetBrains孵化ThinkRail:基于Pi的智能体IDE,规格驱动开发新体验
JetBrains Innovation Hub孵化的开源智能体IDE ThinkRail,基于Pi构建,支持规格驱动开发、Git worktree并行工作区与Monaco编辑器交互,完全免费。本文详解其安装、工作流与生态整合。

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。