Dấu or Die基准测试:LLM能还原越南语声调符号吗?

越南开发者用37句手写题测试LLM声调还原能力,Gemini 3.7 Flash满分夺冠,480B代码专精模型垫底。
越南开发者Tuan Nguyen构建了"Dấu or Die"基准,用37个手写句子测试大语言模型能否将无声调越南文还原为标准书写形式。测试覆盖日常句、歧义词、成语、中英混合及专有名词五类,采用确定性精确匹配评分,无LLM裁判。结果显示Gemini 3.7 Flash以37/37满分居首,新一代Flash击败了老一代Gemini 2.5 Pro;480B参数的Qwen 3 Coder因代码专精而丢失多语言细节,以25/37垫底。成本收益方面,GPT-5.4 mini仅0.02美元即达0.89分,性价比远超更大模型。测试还意外暴露了自身局限:精确匹配对真正存在歧义的条目过于苛刻,且temperature 0并不能保证输出完全稳定。
越南语开发者Tuan Nguyen做了一件有趣的事:他构建了一个名为 Dấu or Die 的Kaggle基准测试,专门考验大语言模型(LLM)能否把被去掉的越南语声调符号重新放回去。这个看似微不足道的任务,背后藏着低资源语言处理的真实挑战。
为什么要测试声调还原
越南语有六个声调,外加一组元音变音符号(ă、â、ê、ô、ơ、ư、đ)。但现实中大量越南人日常打字时并不输入这些符号,也就是所谓的"không dấu"(无声调):手机上没装越南语键盘、URL与文件名、用户名,以及只接受ASCII的老数据库和短信系统,都会迫使文字"裸奔"。
问题在于,去掉声调后许多单词会坍缩成同一个字符串。比如 ban 可能是 bàn(桌子)、bán(卖)、bạn(朋友)或 bận(忙)。母语者靠上下文瞬间就能区分,而作者想知道:LLM到底是真正理解语境,还是只会默认选最常见的那个词?
他最喜欢的测试句是:
Cai ban nay ban bao nhieu tien vay ban?→ Cái bàn này bán bao nhiêu tiền vậy bạn?("朋友,这张桌子卖多少钱?")
同样的三个字母出现了三次,每一次都必须还原成不同的词。这正是语境推理能力的试金石。
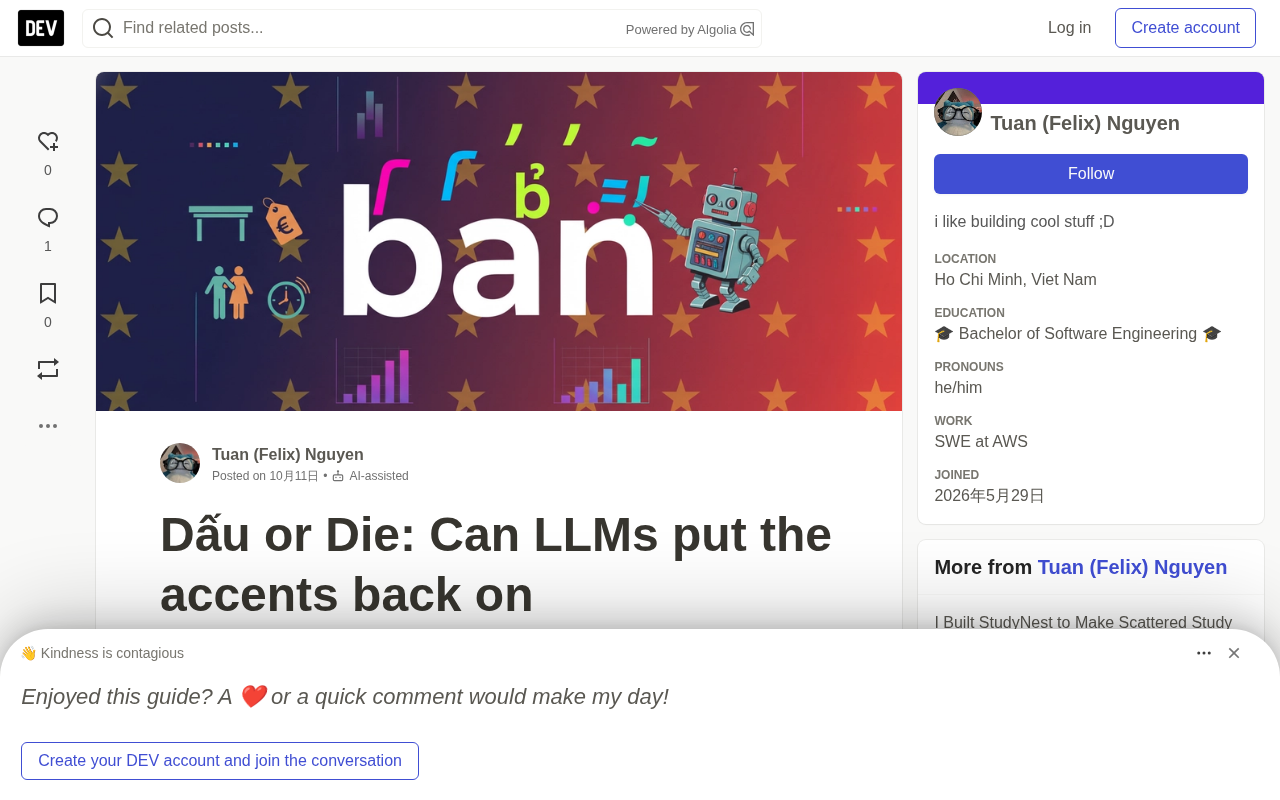
越南语属于孤立型声调语言,声调不仅区分词义,还是语法信息的载体。六个声调分别是:平声(thanh ngang,无符号)、玄声(huyền,)、问声(hỏi,?)、跌声(ngã,~)、锐声(sắc,´)和重声(nặng,.),在正式越语书写系统(Chữ Quốc ngữ)中每个声调对应一套专用变音符号。此外越南语还有七个基本元音,其中六个可通过变音符号衍生出新的音位(如 a→ă/â,e→ê,o→ô/ơ,u→ư),đ与d` 则是两个不同的辅音。声调与变音符号叠加后,单个音节可能有多达十余种不同书写形式,且每种含义完全不同。这使得"无声调越南文"(tiếng Việt không dấu)从信息论角度看会造成极高的歧义密度,远非删去重音符号那么简单——它相当于把多套平行的词汇系统压缩成了同一份字符流。
基准测试是如何运作的
作者手写了 37个句子,分为五个类别,覆盖了不同难度的语言现象:
- everyday:日常普通句子,作为基线
- ambiguous:围绕易混淆词构建的句子(bàn/bán/bạn/bận、cười/cưới、ốm/ôm、thấy/thầy、cá/cà/cả等)
- idiom:谚语成语,词是固定的,考验文化记忆
- code_mixed:越南语混英文开发俚语(如"Em deploy code lên server rồi…"),英文词必须保持不变
- proper_noun:地名人名,如 Hà Nội、Đà Nẵng、Nguyễn Du、Truyện Kiều
评测流程相当严谨:先用 Unicode NFD 归一化自动剥离声调,并把 đ 映射为 d;模型需返回结构化输出 {restored_text: str};评分完全是确定性的,不使用LLM作为裁判。
关键指标被称为"headline score"——即完全还原正确的句子占比。只要有一个声调错,整句就算错,因为一个错误声调就足以改变含义。此外还会报告每个类别的词级准确率。整个测试基于 kaggle-benchmarks 库搭建。
评测中采用的 Unicode NFD(Canonical Decomposition)归一化,是剥离声调的标准技术手段:NFD 会将带附加符号的字符拆解为基字符加组合附加符号的序列(如 ắ → a + 短音符 + 锐音符),之后只需过滤掉所有属于"组合附加符号"Unicode 类别的码点,即可精确还原出纯 ASCII 基字符,同时保持英文和数字不变。这套方法比正则替换更健壮,能处理各种预组合(precomposed)形式的越南字符,无需维护手工映射表。đ→d 的单独映射则是因为 đ 在 NFD 分解后仍是单一码点,必须显式处理。评分端使用确定性字符串匹配而非LLM裁判,避免了"用AI评判AI"带来的系统性偏差,但代价是无法区分"差一点但语义正确"与"完全错误"的输出,这也是作者后续计划引入多参考答案的动机。
七个模型的较量结果
作者挑选了来自五个不同实验室的七款模型,混合了"快而便宜"的档位和更大的模型,想看看在这类偏低资源的语言任务上,是模型规模更重要还是实验室的训练取向更重要。
| 排名 | 模型 | 完全正确句子得分 | 正确句数 |
|---|---|---|---|
| 1 | Gemini 3.7 Flash | 1.00 | 37/37 |
| 2 | GLM-5 | 0.92 | 34/37 |
| 2 | Gemini 2.5 Pro | 0.92 | 34/37 |
| 4 | GPT-5.4 mini | 0.89 | 33/37 |
| 5 | Claude Haiku 5.5 | 0.84 | 31/37 |
| 6 | Qwen 3 Coder 480B | 0.68 | 25/37 |
| – | Gemma 4 26B | 运行报错 | – |
值得说明的是,Gemma 4 26B这款谷歌开源权重模型因为运行报错,在产出分数前就终止了。作者坦言这是自己评测框架的bug——评分代码假设至少有一个句子以正确结构化格式返回,若模型在每个样本上都失败就会导致聚合崩溃。他强调这"不是对Gemma的判决"。
四个值得玩味的发现
新一代"Flash"打败了老一代"Pro"。 Gemini 3.7 Flash还原了全部句子,而 Gemini 2.5 Pro错了3句。在这个任务上,更新的世代比更大的档位更关键。
模型大不等于强,如果它专精于别的领域。 Qwen 3 Coder拥有480B参数,是测试中最大的模型,却垫底(25/37)。为代码调优的模型似乎丢失了细粒度的多语言细节,而越南语声调恰恰就是这种细节。
任务看似简单,分差却很大。 每个母语者都能不假思索地还原这些句子,但最好与最差模型之间差了12句。一个声调错即整句错——对读者而言也确实如此,"bán nhà"(卖房子)和"bàn nhà"(桌子房子)绝不是"差不多"。
在顶端花更多钱几乎买不到提升。 Kaggle的"得分-成本"图显示,GPT-5.4 mini整个基准仅花约0.02美元就拿到0.89分;GLM-5只多对一句(0.92),成本却高出10倍以上,约0.3美元。对于生产环境中的"加回声调"功能,小模型是明智选择——前提是选对那个小模型。
意外收获:基准测试找到了自己的歧义
一个有趣的插曲是,基准测试暴露了自身的局限。在首次开发运行中,Gemini 3.7 Flash把 Sep bao hop online… 还原成 "Sếp báo họp online"(老板"通知"开会),而非作者参考答案的 "Sếp bảo họp online"(老板"说"要开会)。两者都是正确的越南语。当作者在temperature 0下重跑用于排行榜时,它选了"bảo",拿到满分1.00。
这带来两个教训:其一,去掉声调有时会摧毁再多上下文也无法恢复的信息,所以精确匹配是个略显苛刻的指标,未来版本应为每句接受一组有效答案;其二,即便在temperature 0下,模型输出也并非完全稳定,而这种波动恰恰出现在真正有歧义的条目上——单一的排行榜数字掩盖了这种不确定性。
"bảo"(说、叫)与"báo"(通知、报告)的歧义是越南语中典型的"上下文不足以消歧"案例。在无声调形式 bao 下,两个词的句法功能相同(均可作动词带宾语),语义上也高度相近,仅凭单句语境无法确定哪个更"正确"。这类真歧义与模型错误有本质区别:模型错误是在有唯一正确答案时选错,而真歧义是客观上存在多个等价的语言学合法答案。在 temperature 0 下模型仍产生不同输出,正是因为这类条目的 token 概率分布极为接近,随机种子或底层采样的微小差异足以翻转结果。这也说明 temperature 并不等同于"确定性"——它只是降低了随机性,无法消除概率接近时的分支不稳定。
下一步计划
作者列出了后续想要测量的方向:修复评测框架让格式失败计为0而非崩溃,然后重跑Gemma等开源模型;为每句支持多个有效答案(bảo/báo)并进行重复运行以衡量稳定性;加入与缺失声调混合的青少年俚语(如"ko"、"dc"、"j z");测试更长段落;覆盖南北方言词汇差异;甚至反向测试——模型能否检测出打字错误引入的"错误声调"。
这个由Tuan Nguyen独立完成的项目,用一个极小而精巧的基准,揭示了评估低资源语言任务时的许多普遍问题:世代比规模重要、专精会牺牲通用性、成本与收益不成正比、以及"精确匹配"指标的内在张力。对于关注多语言NLP的从业者,它是个值得借鉴的方法论样本。
相关推荐

如何评估AI生成的研究摘要?三个关键维度
AI生成的研究摘要读起来流畅,但事实未必可靠。本文基于Reddit讨论,梳理评估AI研究摘要系统的三个核心维度:来源可追溯性、事实一致性与不确定性处理,并探讨其对深度学习从业者的实践意义。
Go工具Unspill:扫描AI编程助手历史记录中的凭证泄露
介绍Go语言CLI工具Unspill,可本地扫描Copilot CLI、Claude Code、Codex等AI编程助手的历史记录,检测泄露的API密钥和凭证,支持脱敏报告且无网络请求。
AI工具正在"入侵"复古游戏:一场创造力与版权的博弈
AI工具正在大幅降低复古游戏移植门槛,浏览器版《光环》、iPhone版《风之杖》等项目病毒式传播,但也引发版权争议与行业监管担忧。