Decision 3.0开源发布:0.6B-27B多模态决策模型登顶双榜

Decision 3.0发布0.6B至27B全尺寸决策模型,双榜登顶并展现出强大的视频零样本能力。
vLLM Semantic Router团队发布了Decision 3.0(d3)决策模型家族,覆盖0.6B到27B六个参数规模,采用Apache-2.0协议开源。与生成式大模型不同,d3不输出自由文本,而是直接针对选择题、是非判断和打分三类结构化任务输出概率分布,天然适配自动化决策流水线。模型基于Qwen系列构建,支持文本、图像和视频三种模态输入,在AMD Instinct MI325X上以BF16精度完成训练。在Jev Decision Index榜单上,27B版本以文本64.7分、视觉71.6分双双夺冠,各尺寸版本也均领跑同级。尤为值得关注的是,所有模型在训练中均未使用视频数据,却在Perception Test全集上取得了27B版本77.4分、4B版本70.3分的零样本成绩,展示出图像模态能力向时序视觉内容的强泛化性。
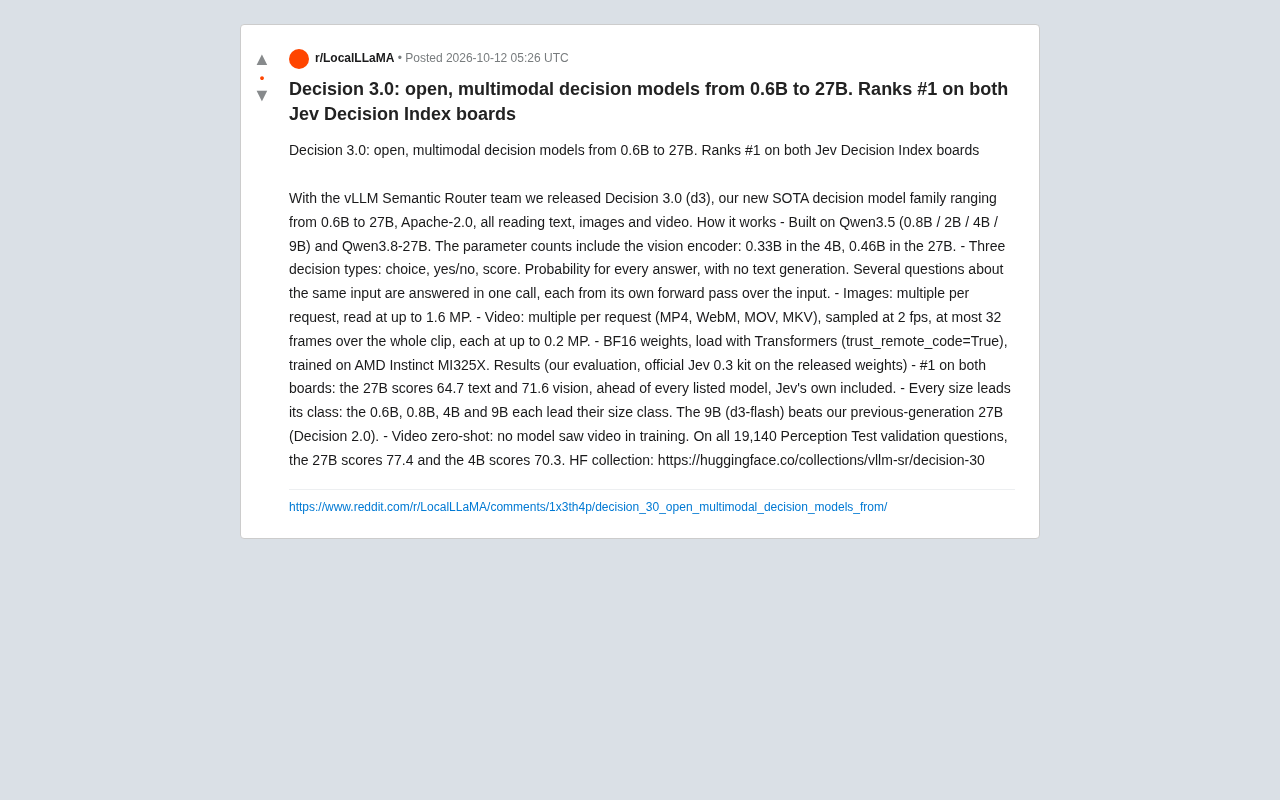
vLLM Semantic Router团队发布了全新的决策模型家族Decision 3.0(简称d3),覆盖从0.6B到27B的多个参数规模,采用Apache-2.0开源协议,支持文本、图像和视频三种模态的输入。这一发布在Jev Decision Index的文本和视觉两个榜单上均拿下第一名,成为当前决策模型领域的新SOTA。
一个专注决策而非生成的模型家族
与我们熟悉的生成式大模型不同,Decision 3.0的定位非常明确——它不生成文本,而是专注于输出决策结果。模型支持三种决策类型:选择题(choice)、是非判断(yes/no)和打分(score),并为每个候选答案给出概率,而非自由文本生成。
这种设计带来一个值得关注的工程特性:针对同一输入的多个问题可以在一次调用中完成,每个问题各自对输入做一次前向传播(forward pass)。对于需要在同一份内容上回答多个结构化问题的场景,这种模式在效率和可控性上都有明显优势。相比用大语言模型生成答案再解析,直接输出概率的方式更适合接入下游的自动化决策流水线。
这类专注于决策输出的模型在业界通常被称为"判别式模型"(Discriminative Model)或"分类模型",与GPT、Llama等"生成式模型"(Generative Model)形成对比。生成式模型通过逐token采样来产生自由文本,而判别式模型则直接对预设的候选项计算后验概率。在路由(Routing)、内容审核、相关性排序等场景下,判别式模型的输出天然就是一个可比较的数值,无需额外解析,延迟也通常更低。vLLM Semantic Router团队将这类模型命名为"决策模型"(Decision Model),强调其在自动化流水线中扮演决策节点的角色,而非信息生成者。
底层架构与多模态能力
Decision 3.0构建在Qwen系列之上,具体包括Qwen3.5(0.8B / 2B / 4B / 9B)和Qwen3.8-27B。官方特别说明,公布的参数量已包含视觉编码器——例如4B版本中视觉编码器占0.33B,27B版本中占0.46B。这意味着这些数字反映的是完整的多模态系统规模,而非仅语言主干。
在多模态输入上,模型的处理能力相当具体:
- 图像:单次请求支持多张图片,分辨率最高可达1.6 MP。
- 视频:单次请求支持多个视频文件,兼容MP4、WebM、MOV、MKV等格式;采样率为2 fps,整段视频最多取32帧,每帧分辨率最高0.2 MP。
模型权重采用BF16精度,可通过Transformers库加载(需设置trust_remote_code=True),训练在AMD Instinct MI325X加速卡上完成。选择AMD硬件进行训练,也从侧面反映出当前AI训练生态正在逐步多元化。
BF16(Brain Float 16)是由Google提出的一种16位浮点格式,与IEEE标准的FP16相比,BF16保留了与FP32相同的8位指数位,只压缩了尾数位。这一设计使BF16在数值范围上与FP32一致,极大降低了训练时数值溢出(overflow)或下溢(underflow)的风险,因此被广泛用于大模型训练和推理。AMD Instinct MI325X是AMD面向数据中心AI训练和推理的加速卡,基于CDNA 3架构,支持BF16和FP8计算。团队选用AMD硬件完成训练并公开这一信息,对于评估模型在非NVIDIA生态下的可复现性和部署成本具有参考价值,也为使用ROCm软件栈的开发者提供了一个可参照的先例。
评测结果:全尺寸领跑各自分级
根据团队使用官方Jev 0.3评测套件在已发布权重上的评估,Decision 3.0的表现相当强势。
27B版本在文本榜拿下64.7分、视觉榜拿下71.6分,领先榜单上包括Jev自家模型在内的所有参赛者,稳居双榜第一。
更有参考价值的是各尺寸的分级表现:0.6B、0.8B、4B和9B四个版本分别在各自的参数规模分级中领先。其中9B版本(代号d3-flash)甚至击败了上一代的27B模型(Decision 2.0),说明新一代在训练方法或数据上的改进让更小的模型获得了超越前代旗舰的能力。这对追求推理成本与性能平衡的部署场景是个好消息。
零样本视频理解的意外表现
一个颇具看点的结果是视频任务的零样本(zero-shot)能力。团队明确指出,没有任何一个模型在训练中见过视频数据。然而在Perception Test验证集全部19,140道问题上,27B版本得分77.4,4B版本得分70.3。
模型在从未接触视频训练数据的情况下,仍能通过逐帧采样的方式迁移出可观的视频理解能力,这说明其图像模态的能力具备较强的泛化性,能够延展到时序视觉内容。对于希望用一套模型同时覆盖图文与视频决策的开发者而言,这种零样本泛化降低了额外采集视频训练数据的门槛。
零样本(Zero-shot)泛化指的是模型在没有见过某类任务训练样本的情况下,仅凭已有知识完成该类任务的能力。在多模态领域,视频理解通常被视为比静态图像更难的任务,因为它额外涉及时序关系和帧间一致性的理解。Decision 3.0通过以2 fps采样、最多取32帧的方式将视频"展平"为一组静态图像序列,从而将视频问题转化为多图输入问题。Perception Test是由DeepMind发布的一个多任务视频理解基准,涵盖感知、记忆、抽象推理等19,140道问题,是衡量视频理解能力的权威数据集之一。在该基准上取得77.4分(27B)的零样本成绩,说明逐帧图像理解能力在一定程度上可以替代专门的时序建模。
对开发者的实际意义
Decision 3.0的几个特点组合在一起,构成了它独特的价值主张:Apache-2.0的宽松许可允许商用,参数规模跨度大便于按需选型,不生成文本而直接输出概率的设计天然适配结构化决策任务,多模态与视频零样本能力则拓宽了应用边界。
从0.6B到27B的完整梯队,意味着从边缘设备到数据中心的不同算力条件都能找到合适的落点。模型已在Hugging Face上开放(vllm-sr/decision-30 collection),感兴趣的开发者可以直接获取权重进行验证和集成。
需要提醒的是,上述评测结果来自团队自行使用官方评测套件的测试,第三方的独立复现与更广泛场景下的实测,仍将是检验其真实能力的关键一步。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。