Dedica:你的网站能通过AI Agent的125项测试吗?
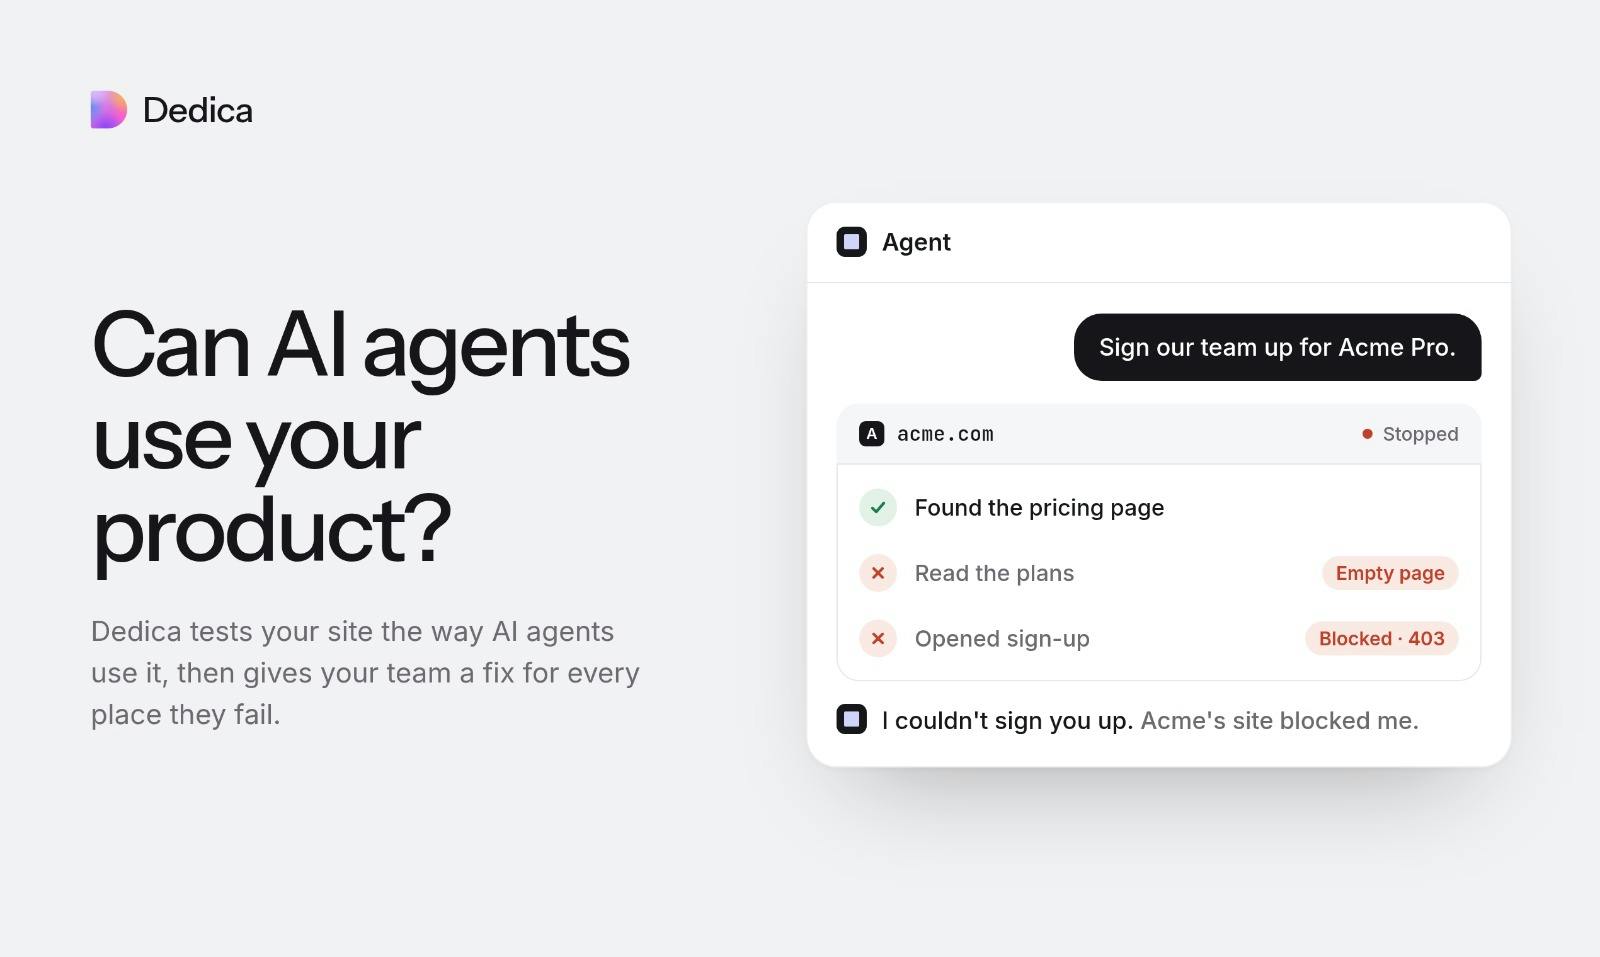
Dedica用125项检查测试网站对AI Agent的可用性,并为每个问题生成可执行的修复方案。
Dedica是Product Hunt上排名第三的新工具,旨在回答“你的网站AI能用吗”这一问题。随着Muse、Instinct、GrokBot等AI Agent开始代替用户浏览、比价和注册,网站的交互设计面临新考验:Agent不像人类那样容忍模糊导航或复杂验证码。Dedica通过模拟AI Agent的使用方式对网站进行125项免费检查,并针对每处失败给出可交给编码Agent执行的修复方案,形成“检测—诊断—修复”的闭环。产品横跨Website Builder与Developer Tools两个分类,获得127票和48条评论。文章指出,AI Agent可用性正成为区别于传统SEO的网站质量新维度——前者关注读取,后者关注行动。不过,检查项的具体分类、修复准确率及不同Agent间的行为差异仍有待实际使用验证。
Dedica:你的网站能通过AI Agent的125项测试吗?
当AI Agent开始代替人类浏览、比价甚至完成注册,网站的"访客"定义正在被改写。Product Hunt上排名第三的新工具Dedica,试图回答一个被大多数团队忽略的问题:你的网站,AI能用吗?
AI访客时代,网站可用性多了一层考验
Muse、Instinct、GrokBot等AI Agent已经在替用户浏览网页、比较商品、填写表单。它们不像人类那样容忍模糊的导航结构,也不会因为一个复杂的验证码就耐心重试。据Dedica的产品说明,这类Agent"正在代表人们浏览、比较和注册",而多数网站的交互设计仍只面向人类访客。
Dedica的做法是模拟AI Agent的使用方式测试网站,然后针对每一处失败给出修复方案。这个思路的巧妙之处在于:它不要求团队重新理解AI的技术细节,而是把问题转化为一份可以交给编码Agent的任务清单。
AI Agent(自主智能体) 是指能够感知环境、自主决策并执行一系列操作以完成目标的软件系统。与传统的搜索引擎爬虫只读取页面内容不同,AI Agent 会模拟人类行为进行点击、滚动、填写表单、跨页面跳转等交互,代表用户完成比价、注册、下单等任务。常见形态包括浏览器自动化代理(如基于大语言模型的 Web Agent)和垂直任务型代理(如购物比价、行程预订)。它们对网页结构的语义清晰度、可访问性标签(ARIA)、表单字段命名、以及反自动化机制(如验证码、动态渲染)高度敏感。因此,面向 Agent 的可用性测试需要覆盖交互路径、状态保持、错误恢复等维度,而不仅仅是内容可抓取性。
125项检查与"每个问题都有修复方案"
Dedica提供125项免费检查,覆盖AI Agent实际使用网站时可能遇到的障碍。产品定位很直接:跑完测试,看到AI能不能用你的站点,然后把每个问题的修复建议直接丢给coding agent去改。
这种"检测—诊断—修复"的闭环,比单纯给一个可用性评分更实用。对开发者而言,知道"哪里坏了"往往比知道"坏了"更有价值。Dedica把输出设计成可执行的修复项,等于把审计报告变成了工单。
从网站建设到开发者工具的交叉定位
Dedica在Product Hunt上被归入Website Builder和Developer Tools两个分类,获得127票和48条评论,排名当日第三。这个交叉定位反映了它的双重受众:一边是关心站点能否被AI正确访问的建站运营方,另一边是真正动手改代码的开发者。
你可能没注意到,AI Agent友好性正在成为网站质量的一个新维度。传统SEO关注搜索引擎爬虫能不能抓到内容,而Agent可用性关注的是自主智能体能不能完成操作——前者是读取,后者是行动,难度和影响都不同。Dedica踩中的正是这个转变的早期窗口。
传统SEO(搜索引擎优化) 主要关注搜索引擎爬虫能否抓取、索引并理解页面内容,优化手段包括关键词布局、站点结构、元标签、加载速度和外链建设等,其核心目标是提升在搜索结果中的排名与曝光。SEO 的评估对象是“读取”行为:爬虫获取 HTML、解析文本与链接,不执行复杂的用户操作。而 Agent 可用性(Agent Usability) 关注的是自主智能体能否在站点上“行动”:完成多步交互、理解按钮意图、处理表单校验、绕过或通过人机验证、在异常时恢复。两者的技术栈和失败模式不同——SEO 失败表现为内容不被收录,Agent 可用性失败表现为任务中断或误操作。随着 AI Agent 流量占比上升,站点需要同时满足“可读”与“可操作”两套要求,这构成了网站质量评估的新维度。
早期信号与待观察的问题
作为Product Hunt上的新产品,Dedica目前的公开信息集中在测试能力和修复建议上,关于检查项的具体分类、修复方案的准确率、以及不同Agent之间的行为差异,还缺少可验证的细节。125项检查究竟覆盖哪些层面,修复建议在真实项目中能落到多细,这些都需要实际使用后才能判断。
对于正在被AI Agent流量改变访问结构的站点来说,提前做一次Agent可用性审计是合理的投资。Dedica的免费检查降低了尝试门槛,但工具能否成为团队工作流的一部分,取决于它给出的修复方案是否足够具体、是否真的能被coding agent直接消化。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。