DeepMind为何在数学基准测试中掉队?专用系统与通用模型的路线之争

一个令人意外的现象
提起AI在数学领域的突破,很多人第一反应是Google DeepMind。这家实验室在过去几年里几乎定义了"AI做数学"这个领域:从破解几何奥数题的AlphaGeometry,到能进行形式化定理证明的AlphaProof,再到通过进化算法发现新解法的AlphaEvolve,DeepMind在数学推理与搜索方向上有着最深厚的研究积累。
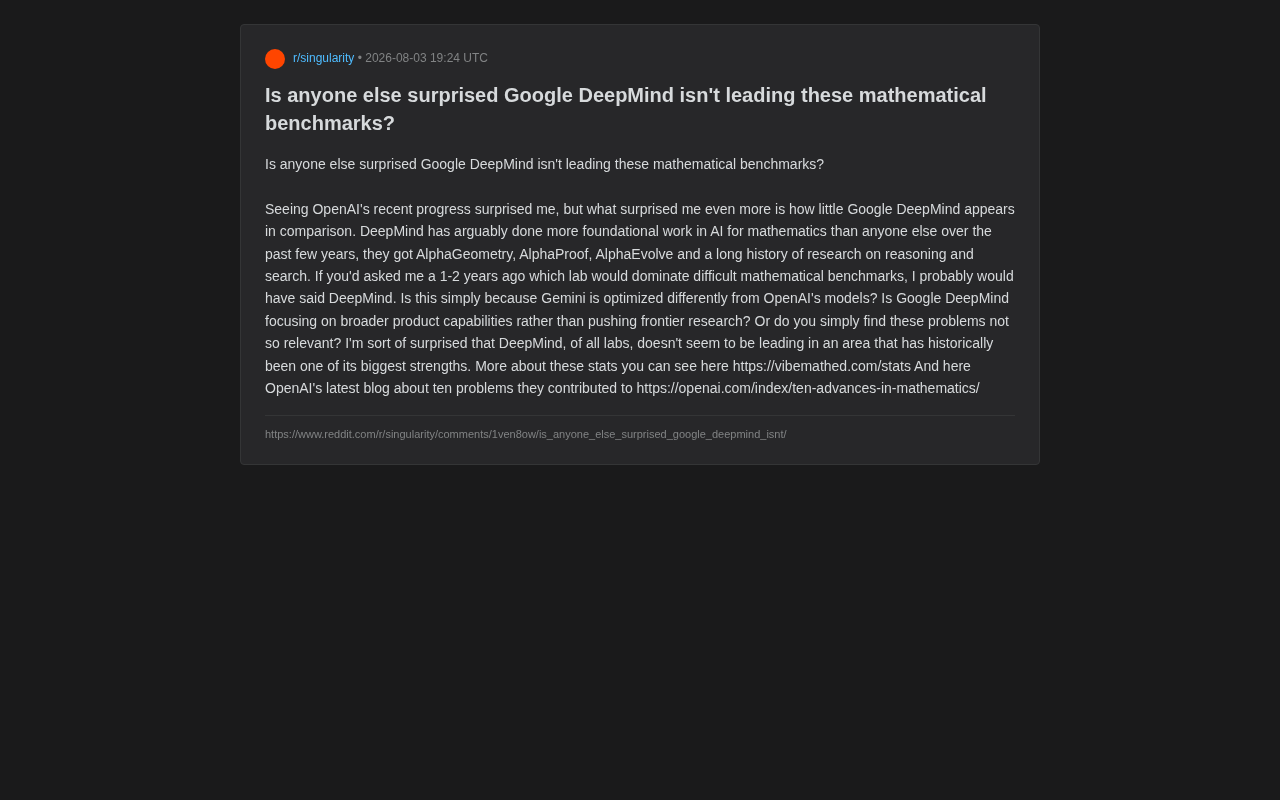
然而近期一位Reddit用户提出了一个耐人寻味的问题:为什么在当前的数学基准测试排行榜上,领跑的却是OpenAI,而不是DeepMind?
"如果一两年前你问我哪个实验室会主导困难数学基准测试,我大概率会说DeepMind。它在这个历史上最擅长的领域反而没有领先,这让我很意外。"
这个疑问背后,其实折射出前沿AI实验室在技术路线、产品战略与评估标准上的深层分歧。
专用系统与通用大模型的路线之争
要理解这个现象,首先需要区分两类完全不同的"AI做数学"。
DeepMind的"专用武器"路线
AlphaGeometry、AlphaProof、AlphaEvolve本质上都是为特定数学任务定制的专用系统。它们通常结合了大语言模型与符号搜索、形式化验证引擎(如Lean)或进化算法,是精心设计的混合架构。
具体来说,AlphaGeometry是DeepMind于2024年初发布的几何定理证明系统,它将一个经过合成数据训练的语言模型与符号推理引擎(DDAR)相结合,能够在不借助人类示范的情况下解决接近IMO金牌选手水平的平面几何题。AlphaProof则基于形式化数学语言Lean 4构建,能够将自然语言的数学命题翻译为形式化表述,然后通过强化学习驱动的搜索过程寻找严格证明。Lean是一种交互式定理证明器,要求每一步推理都必须在类型论框架下被机器验证,因此AlphaProof产出的证明具有数学意义上的绝对严格性,这与大语言模型生成的自然语言推理有本质区别。而AlphaEvolve则将数学问题转化为程序搜索问题,通过维护候选解的种群、利用大语言模型生成变异操作来产生新候选解,再通过自动化适应度评估筛选优秀个体,已在组合数学的cap set问题上发现了超越人类已知最优解的新结果。
这类系统在国际数学奥林匹克(IMO)级别的问题上表现惊艳,AlphaProof甚至达到了银牌水准。
但它们的特点是:深而窄。这些系统针对几何证明、形式化定理等具体领域高度优化,并非可以随手调用的通用聊天模型。它们往往不参与通用基准测试排行榜的直接竞争,因为二者评估的根本不是同一件事。
OpenAI的"通用模型"路线
而当下热门的数学基准测试,很多是在评估通用大语言模型在数学问题上的端到端表现。当前主流的数学基准包括GSM8K(小学数学应用题)、MATH(高中竞赛数学,含代数、几何、数论等)、AIME(美国数学邀请赛题目)以及更新的FrontierMath等。这些测试通常以自然语言呈现题目,要求模型给出最终数值答案或证明步骤,评分方式多为精确匹配。随着模型能力提升,早期基准如GSM8K已基本饱和,行业正转向更具挑战性的测试集。但这些基准的共同特点是评估从读题到输出答案的全流程能力,这与形式化定理证明中要求每一步都被机器验证的范式有根本区别。
OpenAI近期在这方面进展迅猛,其博客甚至公布了模型在十个数学难题上做出的贡献。这些成绩来自通用模型能力的整体提升,而非专门的数学系统。
换言之,DeepMind在"专用赛道"上遥遥领先,但在"通用模型刷榜"这条赛道上,Gemini的优化方向与OpenAI并不完全一致。这才是排行榜排名差异的核心原因之一。
优化目标的不同选择
除了架构路线,两家实验室的战略重心也存在显著差异。
Gemini更偏向产品化
Google将Gemini深度整合进搜索、Workspace、Android等庞大的产品矩阵中。这意味着Gemini的优化目标是广泛的实用能力与规模化部署——多模态理解、长上下文处理、工具调用、成本控制等,都是需要平衡的维度。
这种规模化部署的压力不容小觑。Google搜索中的AI Overview每天处理数十亿次查询,Workspace中的助手需要理解文档、邮件和表格的复杂上下文,Android系统级集成要求模型在端侧设备上也能高效运行。这意味着模型必须在推理延迟、计算成本、多语言支持、安全对齐等多个维度上同时达标。一个在数学基准上多几个百分点的优化,如果以推理时间翻倍或部署成本大幅增加为代价,在产品层面可能并不划算。这也解释了为什么Gemini的工程投入更多放在推理效率优化(如Flash版本)和长上下文能力(百万token窗口)上。
在这样的目标函数下,极限数学推理未必是首要优先级。
OpenAI更愿意展示前沿
相比之下,OpenAI在过去一年里更积极地展示模型在困难推理任务上的天花板,将数学、代码等硬核能力作为标杆宣传点。这种"秀肌肉"式的策略,天然更容易在数学基准榜单上获得曝光和领先位置。
所以,DeepMind"不领先"并不等于"能力不足",很可能只是没有把资源集中投向这类公开排行榜的竞争。
基准测试本身的局限性
还有一个值得警惕的角度:这些数学基准测试本身能在多大程度上代表真实的数学能力?
公开排行榜存在几个固有问题:
- 数据污染风险:热门测试集可能已进入训练数据,导致分数虚高。数据污染(data contamination)是当前AI评估面临的严峻挑战——由于大语言模型的训练数据通常来自互联网爬取,而热门基准测试的题目及答案广泛存在于各类论坛、博客和学术网站上,模型可能在预训练阶段已经"见过"测试题目。研究表明,即使是部分泄露(如见过题目但未见过标准答案),也可能显著提升模型在基准上的得分。
- 评估口径不一:是否允许使用工具、是否形式化验证、题目难度分布,都会显著影响排名。不同实验室在评估时的设置差异——如是否允许多次采样取最优(pass@k)、是否使用思维链提示、是否启用代码执行工具——都会导致同一模型在不同报告中呈现截然不同的分数,使得跨实验室的直接对比变得极为复杂。
- 展示动机差异:并非所有实验室都会把最强的内部系统拿来跑公开榜单。
DeepMind的AlphaProof这类系统追求的是可验证的严格证明,而非在选择题式基准上拿高分。这两种能力虽然都叫"数学",但衡量维度截然不同。用通用基准去评判一个以形式化证明为目标的实验室,本身就可能存在错配。
如何看待这场"错位竞争"
综合来看,"DeepMind没有领先数学基准"更像是一个评估视角问题,而非实力衰退。
可以从三个层面理解:
- 技术深度:在最硬核的数学证明与新解法发现上,DeepMind的专用系统依然处于领先地位。
- 通用能力:在面向消费级产品的通用大模型上,Gemini与GPT系列各有侧重,OpenAI更愿意在数学榜单上展示上限。
- 战略取舍:Google把更多精力放在产品整合与规模化,而非公开基准的短期排名。
对于关注AI进展的从业者而言,这个案例的启示在于:不要被单一排行榜误导。一个实验室是否"领先",取决于你用什么尺子去量。数学能力有奥数解题、形式化证明、开放式研究等多个维度,没有任何一个基准能完整捕捉全貌。
真正值得期待的,或许是当DeepMind把AlphaProof、AlphaEvolve这类专用能力逐步融入Gemini通用模型之时——那时的对比,才可能是更接近本质的较量。
核心要点
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。