DeepSeek 4.1 Flash 1017免费开放:三大平台限时福利汇总
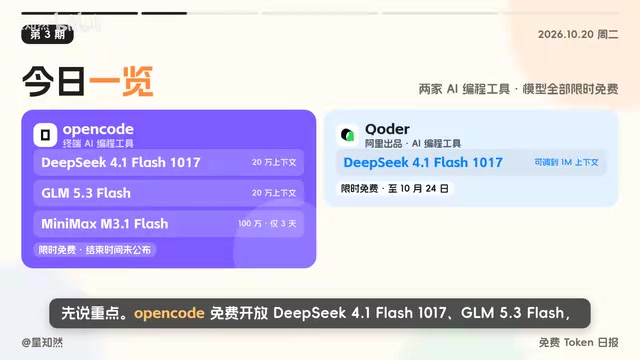
DeepSeek 4.1 Flash 1017 在 OpenCode 与 Coder 限时免费开放,附使用要点。
文章汇总了 DeepSeek 4.1 Flash 1017 模型在两个平台的免费开放情况。OpenCode 同时免费提供 DeepSeek 4.1 Flash 1017 和 GLM 5.3 Flash(均 20 万上下文,结束时间未公布),以及仅免费三天的 MiniMax M3.1 Flash(100 万上下文),额度按 IP 计算,换 IP 可继续使用。Coder 平台提供该模型的国际版和国内版,10 月 24 日截止,额度有限先到先得。使用前需在模型管理中将上下文调成“EM”,否则长上下文能力无法充分发挥。文章提醒,这些规则来自 UP 主整理,平台政策可能随时调整,实际以页面显示为准,并建议关注更新渠道获取额度变动信息。
DeepSeek 4.1 Flash 1017 模型近期在多个平台开放免费使用,对开发者和 AI 应用尝鲜者来说是一次低成本试用的窗口。据 B 站 UP 主「AI鸡蛋日报」的汇总,OpenCode 和 Coder 两个平台目前都提供该模型的免费额度,同时还有 GLM 5.3 Flash、MiniMax M3.1 Flash 等模型一同开放。下面把关键信息拆开来讲。
OpenCode:三款 Flash 模型同时免费
OpenCode 这次开放的不止一个模型,而是三款 Flash 系列:DeepSeek广告 4.1 Flash 1017、GLM 5.3 Flash 和 MiniMax M3.1 Flash。
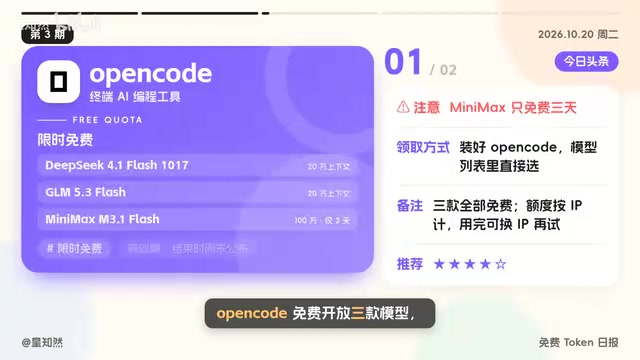
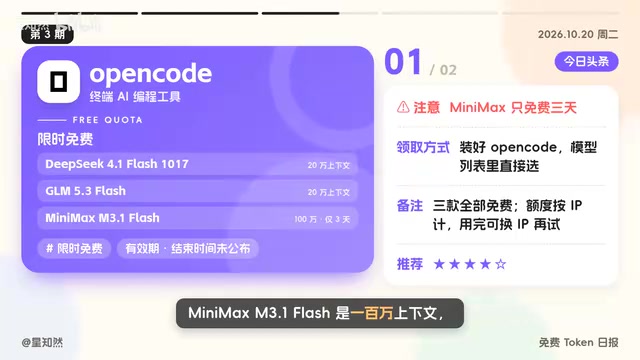
其中 DeepSeek 4.1 Flash 1017 和 GLM 5.3 Flash 都提供 20 万上下文,结束时间尚未公布;MiniMax M3.1 Flash 的上下文达到 100 万,但只免费三天。
额度按 IP 计算,用完之后换一个 IP 可以继续尝试。这个规则意味着同一网络环境下多人共用额度会消耗得更快,个人使用时相对充裕。
上下文窗口(Context Window)是衡量大模型单次可处理信息量的核心指标,通常以 token 数计量。20 万上下文约等于十余万汉字或数千行代码,意味着模型能一次性“看到”整份技术文档、中型代码库或长篇对话记录,而不必分段投喂导致前后信息割裂。100 万上下文则进一步支持完整书籍、大型项目源码或多轮超长会话的连贯理解。需要注意的是,标称上下文长度与实际可用长度常有差距:部分平台默认只启用较小窗口,需手动在模型设置中调高;长上下文还会带来推理成本上升与“中间信息遗忘”问题,即模型对窗口中部内容的检索能力弱于首尾。因此评估这类免费模型时,除了看标称数字,还应确认平台实际放开的窗口大小以及自身任务是否真的需要如此长的输入。
Coder:DeepSeek 4.1 Flash 1017 双版本可用
Coder 这边免费开放的同样是 DeepSeek 4.1 Flash 1017,国际版和国内版都有,截止日期为 10 月 24 日。
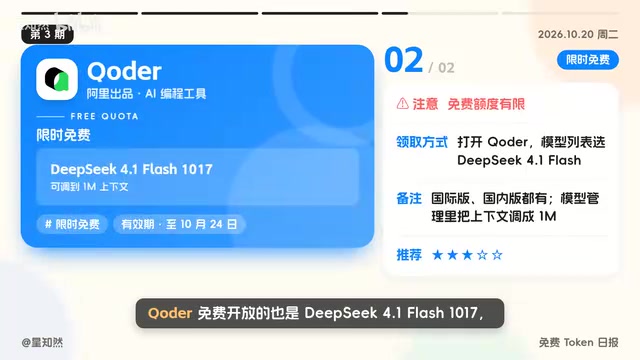
免费额度有限,先到先得。对于需要跨境访问或对线路有要求的用户,双版本入口提供了更灵活的选择。
“国际版”与“国内版”入口的差异,通常体现在服务节点位置、访问线路和账号体系上。国际版多部署在海外机房,国内用户直连可能延迟较高或需要额外网络条件,但模型版本更新往往更快;国内版则针对本地网络优化,访问更稳定,响应延迟更低,适合日常高频调用。对开发者而言,选择哪个版本应结合调用量、对延迟的敏感程度以及是否需要与海外服务对接来判断。同一模型在不同版本间可能存在细微的推理参数或上下文默认值差异,做效果对比时应尽量固定版本变量,避免把线路差异误判为模型能力差异。
使用前的一个关键设置
UP 主特别提醒:使用前要到模型管理里把上下文调成「EM」。这个设置容易被忽略,但直接影响模型能否发挥完整的上下文能力,尤其是面对长文档或大段代码时。
“EM”是平台侧对上下文档位的内部命名,并非模型本身的通用术语,不同平台可能用不同代号表示“扩展上下文”“最大上下文”等模式。这类设置之所以关键,是因为许多推理服务默认启用较短窗口以控制显存占用和响应成本,只有在模型管理或调用参数中显式切换,才会加载完整上下文。若未调整,即便模型标称支持 20 万或 100 万 token,实际处理长文档时也可能被截断,表现为回答遗漏前文信息或代码补全不完整。使用前建议先确认当前档位、单次请求的 token 上限,以及切换后是否影响计费或速率限制。
几点实用判断
从信息本身看,这次开放的共同点是「限时 + 限量 + 按 IP」。DeepSeek 4.1 Flash 1017 在两个平台都能免费用,但 Coder 的截止日期明确(10 月 24 日),OpenCode 的结束时间未公布,存在随时调整的可能。
三款模型中,MiniMax M3.1 Flash 的 100 万上下文是差异化卖点,但三天窗口很短,适合有明确长上下文需求的场景集中测试。GLM 5.3 Flash 和 DeepSeek 4.1 Flash 1017 同为 20 万上下文,可以横向对比效果。
需要说明的是,以上额度规则和截止时间来自 UP 主的整理,平台政策可能随时变化,实际以各平台页面显示为准。关注「新自然」等更新渠道可以及时获取免费额度变动信息。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。