DeepSeek 4.1 Flash新架构:KV缓存压缩437倍的秘密
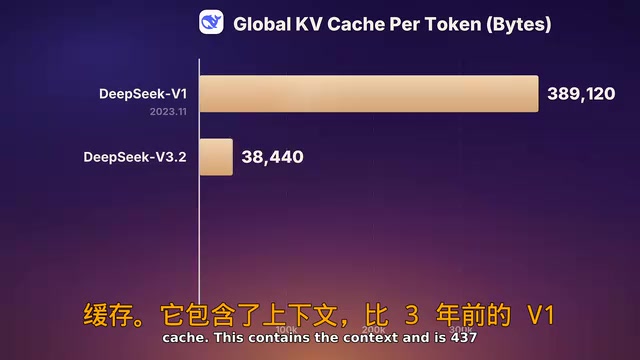
DeepSeek 4.1 Flash 用共享记忆架构将KV缓存压缩437倍,以四分之一成本逼近顶级模型性能。
DeepSeek 4.1 Flash 的核心突破在于架构层面的创新:通过名为 CSA2 的技术,让神经网络各层共享同一份 KV 缓存而非各自独立存储,配合编码器-解码器结构中编码器统一管理全局记忆的机制,将 KV 缓存相比三年前的 V1 压缩了 437 倍,比几个月前的 4.0 Flash 也小了 4 倍。这带来了显著的成本优势——硬件部署成本约为 4.0 Pro 的四分之一,且在部分基准测试中能与 Claude Opus 5 等顶级模型抗衡。但模型并非没有短板:参数量超过 5000 亿无法本地运行,且推理模式下 Token 消耗量较大,部分抵消了 KV 缓存压缩带来的成本红利。结合其开放模型与开放论文的发布策略,DeepSeek 每次迭代都在推动整个行业的推理成本下降。
DeepSeek 发布了全新的 4.1 Flash 模型,最抓眼球的不只是它的运行速度,而是背后一套颠覆性的架构设计。它把 KV 缓存压缩到极致,让大模型的推理成本大幅下降。这篇文章基于 Two Minute Papers 频道 Dr. Károly Zsolnai-Fehér 的解读,梳理它到底做对了什么,以及那些被标题党忽略的细节。
速度与性能:小成本跑出大表现
DeepSeek广告 4.1 Flash 给人的第一印象就是快,而且快得离谱。据 UP 主的实测演示,它的响应速度令人惊讶,在部分基准测试中甚至能超越 Claude Opus 5、Kimi K3 这类顶级模型——注意,是部分测试,并非全面碾压。
更关键的是成本对比。它稳定优于上一代 DeepSeek 4.0 Pro,而 4.0 Pro 本地部署的硬件成本可能高达 30 万美元,4.1 Flash 只需要约四分之一。虽然这依旧是一笔不小的开支,但趋势已经非常明确:照这个速度演进下去,一年后类似能力的模型或许就能塞进我们的口袋里。
此外,4.1 Flash 具备原生视觉理解能力。你可以直接把一张经典游戏菜单的截图丢给它,让它复现出一个可玩的游戏界面。这种多模态的原生支持,让模型的应用场景一下子打开了。
KV 缓存压缩 437 倍:CSA2 技术拆解
模型最令人震撼的地方在于「又大又小」这种矛盾的特性。所谓「小」,指的是它的 KV 缓存(KV Cache)——这部分负责存储上下文信息,是决定显存占用和推理成本的关键。
据频道解读,4.1 Flash 的 KV 缓存相比三年前的 V1 小了整整 437 倍,即便和几个月前的 4.0 Flash 相比也小了 4 倍。短短几个月又压缩了 4 倍,这个进步速度相当惊人。
实现这一点的技术被称为 CSA2。要理解它,得先明白传统神经网络的运作方式:网络由许多层神经元组成,信息在层与层之间传递时,每一层都维护着自己独立的 KV 记忆。这意味着大量冗余存储。
DeepSeek 4.1 Flash 的突破在于让不同层共享记忆——不是每一层都要记住所有东西,而是彼此共用。这在工程上极难实现,因为不同层需要对同一段历史信息有不同的「视角」。强行共享很容易导致性能崩溃,而 DeepSeek 找到了让它稳定工作的方法。
编码器-解码器结构的回归
深入架构内部会发现一个有意思的设计:编码器-解码器(encoder-decoder)结构。编码器负责创建一份共享的全局记忆,解码器则从中读取所需信息。正是这种分工,让 KV 缓存能够大幅缩小。
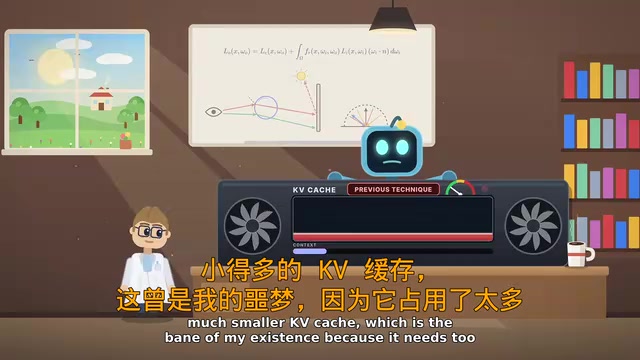
这个思路的价值在于,它把「记忆」从每一层的分散存储,收拢成一份集中管理的全局资源。对于长期困扰大模型部署的显存瓶颈来说,这是一次实打实的跨越。而且由于 DeepSeek 是开放模型,还附带了免费的研究论文,任何人都可以去研究它的具体实现。
KV 缓存(Key-Value Cache)是 Transformer 架构中的核心组件。在自回归生成过程中,模型每生成一个新 Token,都需要「回顾」之前所有 Token 的注意力信息。为了避免重复计算,模型会把每一层的 Key 和 Value 矩阵缓存下来,这就是 KV Cache。它的大小与模型层数、注意力头数量、序列长度以及每个头的维度直接成正比——层数越多、上下文越长,占用的显存就越多。对于拥有数百亿甚至数千亿参数的大模型而言,KV Cache 往往成为推理时显存占用的主要来源,直接决定了单张 GPU 能处理多长的上下文、能同时服务多少并发请求。这也是为什么 KV Cache 的压缩被视为降低大模型推理成本的关键路径之一。
编码器-解码器(Encoder-Decoder)结构最早在 2017 年的原始 Transformer 论文《Attention Is All You Need》中被提出,最初用于机器翻译任务。编码器将输入序列映射成一组连续的隐状态表示,解码器则逐步生成输出序列,并通过「交叉注意力(Cross-Attention)」机制随时查询编码器的输出。然而,GPT 系列将「纯解码器(Decoder-Only)」结构推向主流——这种结构更简单、更易于规模化,成为过去几年大语言模型的主导范式。DeepSeek 4.1 Flash 将编码器重新引入,但动机与原始设计不同:编码器在这里的核心职责不是处理「另一个语言」,而是把分散在各层的历史 KV 信息整合成一份共享的全局记忆,供解码器的各层统一读取,从而打破了「每层独立维护 KV 缓存」的传统模式。这是对经典架构在新场景下的创造性复用。
藏在后面的「坑」:巨大的参数量与 Token 消耗
光看压缩比容易让人误以为这是个能在家轻松跑起来的小模型,但事实并非如此。它的参数规模超过 5000 亿,普通人的家用设备根本没有运行的可能。UP 主坦言自己也跑不动本地部署,只能通过 API 或 Lambda 这类云平台来使用。
另一个需要注意的「catch」是:4.1 Flash 特别爱思考,会烧掉大量 Token。好在单价不算贵,但架不住用量大。所以「小 KV 缓存」带来的成本优势,一定程度上会被高 Token 消耗抵消一部分。
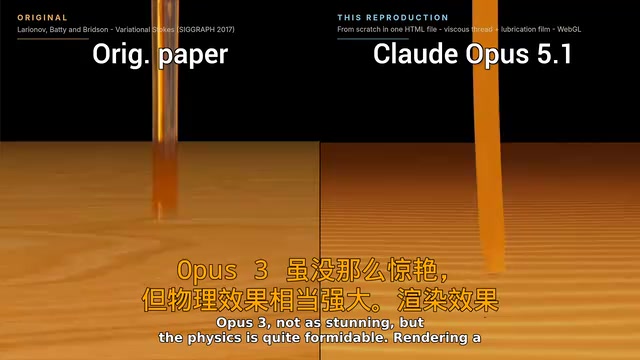
在实际能力测试上,UP 主也保持了客观态度。在复现一篇物理相关论文的实验里,GPT-6 Astra 表现最为出色,Opus 5.4 稍逊,而 DeepSeek 这一代在渲染等细分任务上还有提升空间。换句话说,它并非全面领先,而是在成本效率这个维度上做出了突出贡献。
模型「爱思考」指的是其推理模式(Reasoning Mode):模型在输出最终答案前,会先生成一段较长的内部推理链(Chain-of-Thought),逐步拆解问题、验证中间步骤。这种方式能显著提升复杂任务的准确率,但代价是消耗大量输出 Token。由于 API 通常按输入和输出 Token 分别计费,推理链越长,单次请求的费用就越高。对于简单问答或短文本生成任务,这种模式会造成明显的成本浪费;而对于数学推导、代码调试、科学分析等需要多步推理的任务,额外的 Token 消耗往往物有所值。因此在实际使用中,是否开启「思考模式」需要根据任务复杂度权衡,而非一律启用。
开放科学的价值
每当 DeepSeek 发布一篇新论文,整个 AI 行业的使用成本都会随之下降——这是它对社区最大的贡献。这种把前沿技术公开、让所有人受益的做法,正在帮助更多医生、科学家把 AI 用到实际工作中。
对普通开发者和研究者而言,即便无法本地运行这样的巨型模型,也能通过云 GPU 平台去复现论文、微调模型或运行推理。开放模型加上开放论文,让「验证真相」而非「盲信标题」成为可能。
综合来看,DeepSeek 4.1 Flash 代表的不是某一项跑分的胜利,而是架构层面的一次务实创新:用共享记忆和编码器-解码器结构把推理成本压下来。它有明显的短板,也有清晰的方向感,而 AI 变得更便宜、更普惠这件事,本身就值得记录。
相关推荐
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。
OpenAI Codex 上手指南:用AI代理构建并部署应用
OpenAI Codex 速成课中文整理:从安装、价格套餐、插件与自动化,到 Plan/Go 命令、技能系统,并实战演示用声控 Flappy Bird 游戏走通构建与部署全流程,帮你真正上手这款自主 AI 编码代理。
ICLR投稿量突破5万:AI顶会为何持续爆炸式增长
ICLR 投稿编号逼近 5.1 万引发 Reddit 热议。本文分析 AI 顶会投稿量爆炸式增长的原因、对评审系统的压力,以及数字背后的行业信号与反思。