DeepSeek Harness 实测:八步装机教程与三大避坑指南
DeepSeek开源AI工作台Harness安装全流程与三大避坑要点解析
DeepSeek 开源的 Harness 是一个「一切皆插件」的 AI 工作台框架,本质是包裹在模型外部的编排层,负责界面交互、工具调用和会话留档,而非模型本身。文章整理了完整的八步装机流程,并重点标出三个高频坑:Node 版本须达 22.14 以上(建议直上 24,因其依赖该版本才引入的 zstd 标准库接口);0.1 版本接口尚在快速迭代,不宜压生产工作流;第三方插件需先审源码再信任。Harness 另一个值得关注的设计是全程可回放的 zstd 压缩 JSONL 事件留档,以及整个项目本身由官方 AI 编程 Agent 写出这一样本价值。三万星的热度之外,其「基础能力也外置为插件」的极简内核架构思路才是核心看点。
DeepSeek 开源的 Harness 发布当天就冲上三万星,热度可见一斑。这个项目并非又一个大模型,而是包在模型外面的一层「工作台」——你平时使用时真正打交道的界面、绘画留档、工具调用都在这一层完成。它的口号只有一条:Everything is a plug-in(一切皆插件)。这句话理解透了,后面的安装和使用逻辑就都通了。
本文根据 B 站 UP 主「1024 的工程笔记」的实测记录整理,作者按官方流程完整跑通了一遍,全程八步、踩了三个坑,一个下午搞定。下面把关键节点和避坑要点讲清楚。
Harness 到底是什么:AI 写出来的工程样本
在动手之前,先花半分钟搞清楚定位。Harness 不是模型,是模型外面的一层壳。你给它接上任意 API key,它负责调度插件、读写文件、留档回放。
这个项目还有个有意思的身份:它是官方用编程 Agent 写出来的。打开仓库根目录就能验证——里面放着 AGENTS.md、CLAUDE.md,旁边还有两个 Agent 配置目录,明显是写给 AI 读的。每个模块下面都配了完整的 README,文档密度相当高。厂商用 AI 把工程写完、再开源出来给人读,这种样本目前并不多见,本身就有研究价值。
最能体现「一切皆插件」设计哲学的一点是:连读写文件这种最基础的能力,内核都没有内建,而是全部挂在外面当插件。官方提供的 133 个插件,和社区超过 1400 个第三方插件,走的是同一条装配链路,没有任何特权。你停掉其中任何一个,剩下的照常运行。
「插件化工作台」这类架构在 AI 工具领域有一个更通用的称呼:AI Agent 框架或编排层(Orchestration Layer)。它的核心职责是把大语言模型的文本生成能力,和外部世界的实际操作(读文件、调 API、执行代码)连接起来。早期的 LangChain、AutoGPT 做的是同一件事,只是粒度和抽象方式不同。Harness 的差异化在于把「内核能力最小化」推到极致——连文件读写这种通常内建的原语都拆成插件,意味着内核本身几乎不承担任何业务逻辑,所有行为都可被替换或关闭。这种设计的代价是初次配置复杂度略高,收益是可审计性极强:你随时能精确知道模型被授权了哪些能力,没有隐式权限。
装机前必读:三个坑要提前避开
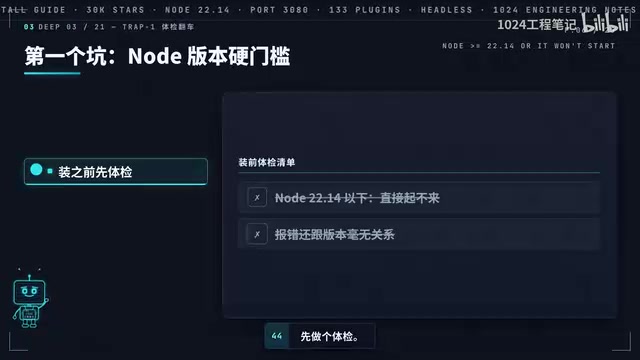
坑一:Node 版本别低于 22.14,直接上 24
这是最容易翻车、报错却「一个字都不提」的地方。Harness 用到的 zstd 解压接口是 Node 22.14 才进的标准库,低版本去调这个函数根本不存在,打补丁也没用。作者的建议很干脆:直接上 Node 24,省得在版本问题上耗半天。
zstd(Zstandard)是 Facebook 开源的一种无损压缩算法,以「压缩率接近 zlib、速度远超 zlib」著称,现已被 Linux 内核、Chrome、Meta 内部数据管道等大量项目采用。Node.js 在 22.14 版本才将 zstd 的解压接口纳入标准库(node:zlib 模块),此前若要使用需依赖 C++ 原生扩展或纯 JS 的第三方包,跨平台编译往往是麻烦的来源。Harness 用 zstd 压缩会话事件流(即第八步提到的绘画留档),这是它对 Node 版本强依赖的根本原因。如果升级 Node 版本对你的其他项目有顾虑,建议使用 nvm(Node Version Manager)管理多版本,可以在同一台机器上并行维护不同版本的 Node 环境,互不干扰。
坑二:0.1 阶段接口会变,别压生产工作流
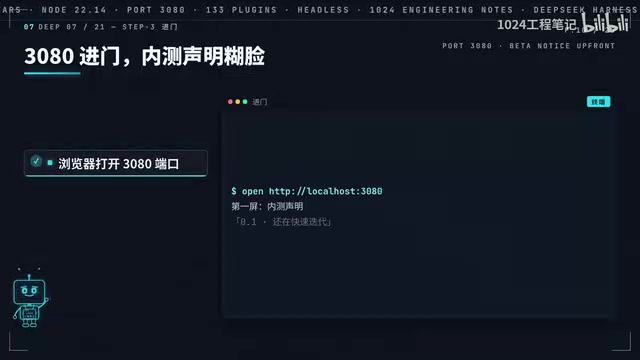
这是开发者预览版,0.1 阶段的配置项和插件接口都可能改动。千万别把生产的工作流直接压上去,先拿不重要的项目试水。值得一提的是,这条「还在快速迭代」的声明,官方直接放在进门第一屏,而不是藏在文档角落。
坑三:第三方插件先过一遍源码
插件市场门槛低,质量就得自己把关。star 数高不等于代码干净,安装第三方插件之前,先过一遍源码再决定是否信任。
八步装机全流程
第一步:打开仓库。 找到 GitHub 上的 DeepSeek广告 Harness 仓库,描述只有一行 Everything is a plugin。三万星看个热闹,那行描述才是正经的核心。
第二步:一行命令装本体。 执行 npx 包名 web 即可。第一次运行会自动拉包并起一个 Node 后台服务,依赖不用你手动装。看到服务地址就说明装好了,没有第二行命令。
第三步:浏览器进门。 打开 3080 端口,第一屏是 0.1 版本的内测声明,点继续进入主界面。
第四步:选工作区。 这里有个容易误会的设计——工作区没选好之前,发送按钮是禁用的、点不动。这不是死板,而是要你先把读写边界定下来,模型才知道去哪里读、往哪里写。
第五步:配模型。 在设置页的 models 一栏把 key 粘进去就能用,key 可在 platform.deepseek.com 申请。它也支持任意 OpenAI 兼容的自定义入口,换模型不用换工具。两条铁律:key 不截图、不进 git,泄露了烧的是自己的余额。
第六步:看插件列表。 这一屏值得多盯一会儿——133 个插件全部挂载,绘画、查询、导出这些能力都是插件。「一切皆插件」到这里算是眼见为实。
第七步:跑个真任务验收。 用 headless 模式一条命令列目录、总结 README,跑完就退,不用开界面。以后碰到重复的活就写成脚本扔给它。作者的习惯是:一个活干到第三遍,就该交给它了。
第八步:看绘画留档。 每一次会话自动存成一个文件,用 zstd 压缩的 JSONL 事件流。你打的字、模型的回复、每一次工具调用,全部是事件、纯文本,可 grep、可回放。出了问题不用猜,直接翻记录,一步一步都查得到。这个设计现在可能没感觉,用上一个月就懂了。
装完自检:三件事全绿才算成
装好先别急着关,花一分钟做体检:
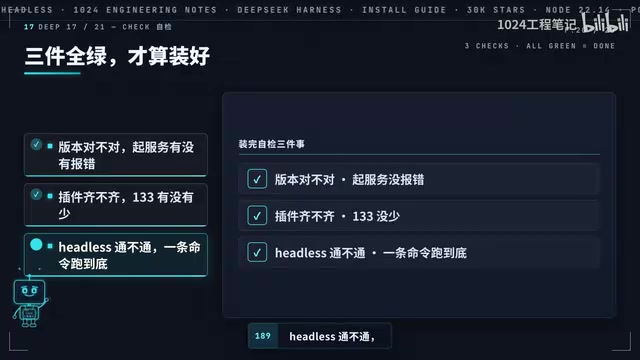
- 版本对不对:起服务时报没报错;
- 插件全不全:133 个有没有少;
- headless 通不通:一条命令能不能跑到底。
三件全绿,才算真的装好。
关于版本关系也要理清:npx 装的这个是 web 版,零安装依赖,起几个服务就能用;桌面版和 CLI 是另外两条线,装法不同,但凭据是通的——装了一个,另外两个不用重新配。
小结
回顾整条链路:体检版本 → 一行命令 → 3080 进门 → 选工作区 → 配 key → 数插件 → headless 跑任务 → 绘画流可回放,一共八步,一个下午能跑通。Harness 最值得关注的不是三万星的热度,而是「一切皆插件」这个把基础能力也外置的架构思路,以及全流程可回放的留档设计。是否切换过来可以慢慢决定,但上手的功夫花过了,判断会更准。
背景补充
JSONL(JSON Lines)是一种每行存储一个独立 JSON 对象的文本格式,与标准 JSON 的区别在于它对流式写入天然友好——每追加一条事件记录只需在文件末尾写一行,不需要维护整个文档的结构完整性,也不怕写到一半进程崩溃导致整个文件损坏。结合 zstd 压缩后,文件体积大幅缩小的同时依然保持「可流式解压、逐行读取」的能力。这意味着即便会话记录体积很大,你也可以用 zstd -d session.jsonl.zst --stdout | grep "tool_call" 这样的管道命令快速筛选特定事件,而不必把整个文件加载进内存。这种「写入不可变事件流、事后任意查询」的思路,与后端分布式系统中的**事件溯源(Event Sourcing)**模式如出一辙。
相关推荐
ChatGPT语音升级:从问答助手到任务执行者
ChatGPT语音功能全面升级,从单纯问答进化为能查日历、管财务、发邮件、建网站、订服务的任务执行助手。本文拆解官方演示场景,解读语音AI从“回答问题”到“完成任务”的关键转变及其实际价值。
ChatGPT玩转怀旧风:用AI重现80年代复古美学
YouTube趣味短片以80年代复古风为噱头,推荐用ChatGPT开启创意时光之旅。本文解析生成式AI在复古风格还原、创意娱乐及趣味化营销中的应用潜力。

Runway WorldPrompt解析:实时世界模型的工程化突破
Runway WorldPrompt 及 GWM Worlds 2 引擎通过持续上下文与定时动作,实现实时生成可交互的视频与音频世界。本文解析其世界模型的核心机制与工程挑战。