deepseek-harness 实测:开源、免费、本地推理的开源项目体验

DeepSeek 开源推理框架 deepseek-harness 实测:本地免费、插件化、可接入 MonkeyCode。
本文介绍了 DeepSeek 开源推理框架 deepseek-harness,其核心理念是「Everything is a Plugin」,模型、工具链与推理后端均可插拔替换,并支持自托管部署、数据不出本地。文章给出三种上手路径:在线试用、本地自部署(克隆仓库、装依赖、运行三步)、以及作为 MonkeyCode 的模型后端接入编辑器工作流。实测反馈响应快且稳定,上下文理解到位,无 API 成本与速率限制,隐私可控。作者同时指出原文中的 25 万星标和「行业领先」说法缺乏统计口径与基准数据,本地部署的硬件门槛、最低配置也未说明,建议读者自行核实后再决策。
DeepSeek广告 在开源社区一直有存在感,而 deepseek-harness 这个新项目又把话题推高了一截。GitHub 上 250311 颗星(原文数据),口号是「Everything is a Plugin」——听起来很激进,但实际体验如何?我把它接到 MonkeyCode 里跑了一轮,下面说结论。
什么是 deepseek-harness
deepseek-harness 是 DeepSeek 推出的开源项目,定位不是单纯的模型权重,而是一个可插拔的推理框架。「Everything is a Plugin」这句话点出了它的设计哲学:模型、工具链、推理后端都可以像插件一样替换。
这和常见的「下载模型 → 写脚本调用」路线不同。Harness 更像是给模型套了一层可编排的外壳,你可以在里面挂不同的能力模块,而不必改动核心逻辑。对于想把 DeepSeek 接入自己工作流的人来说,这层抽象省掉了不少胶水代码。
它是自托管的,数据不出本地,这点对隐私敏感的场景很关键。
可插拔的推理框架指的是把「模型推理」这件事拆成若干职责明确的组件——如模型权重加载、tokenizer、采样策略、工具调用、记忆管理——每个组件都通过统一接口注册,运行时按配置组装。这类设计与 Hugging Face Transformers 的 pipeline、vLLM 的引擎抽象、以及 LangChain 的 tool/agent 分层属于同一思路,但 harness 更强调「模型本身也只是插件之一」。好处是替换任一环节都不必改动其他部分:换推理后端(CPU/GPU/不同量化方案)、换工具集、甚至换底层模型,都只改配置而不重写业务逻辑。代价是引入一层抽象开销,需要理解其配置与生命周期约定,调试时也要分清问题出在哪一层。
为什么值得关注
开源且免费:没有 API 账单
最直接的好处是省钱。deepseek-harness 完全开源,不需要按 token 付费,也没有 API 调用成本。你把它部署在自己的机器或服务器上,推理就在本地跑。
隐私方面,数据全程留在本地,不走第三方接口。对于处理内部代码、敏感文档的团队,这是硬需求,而不是加分项。
性能与速度
原文给出的评价是「industry-leading」(行业领先),推理经过优化,速度较快。这一点在本地推理里并不容易做到——本地跑大模型常见的痛点是慢,harness 在调度和推理路径上做了压缩。
成本对比很直白:免费 vs 付费 API。量大的时候差距会很明显。
上手门槛
API 设计简单,文档比较全,社区也在持续增长。一个项目星标能到 25 万这个量级,说明生态不会太冷清,遇到问题大概率有人踩过坑。
三种上手方式
方式一:在线试用
不想折腾环境的话,直接去 GitHub 仓库 deepseek-ai/deepseek-harness 找在线 demo,用自己常用的 prompt 试几轮,感受一下输出风格和响应速度。这是最低成本的验证方式。
方式二:自托管部署
愿意自己跑的话,流程和大多数 Python 项目差不多:
# 克隆仓库
git clone https://github.com/deepseek-ai/deepseek-harness.git

# 安装依赖
pip install -r requirements.txt

# 运行
python run.py
三步走完。真正的门槛在于硬件——本地推理吃显存,跑之前先确认机器扛得住。
方式三:配合 MonkeyCode 使用
我这次用的是 MonkeyCode 作为客户端。安装后把 deepseek-harness 配置成模型后端,走本地推理。好处是编辑器体验和本地模型隐私兼顾:代码补全、对话都在本机完成,不往云端传。
配置的关键一步是把 harness 设为默认 model,然后在 MonkeyCode 里开启本地推理选项。
实测体验
速度:快且稳定
响应很快,属于「敲完就能看到建议」的节奏。因为是本地处理,没有网络往返延迟,体验上比云端 API 更跟手。多轮对话下表现也稳定,没有明显的卡顿或超时。
质量:上下文理解到位
给我印象比较深的是上下文理解。在有一定复杂度的代码文件里,它能抓住前后依赖关系给出建议,而不是只看当前行。错误提示也比较清楚,不会甩一堆没用的堆栈给用户。
准确性整体不错,但和所有本地模型一样,复杂逻辑上仍需要人工把关,不能盲信。
成本:免费、无限制、隐私可控
不花钱、没有速率限制、数据留在本地——这三点组合起来,对于高频使用者是实打实的收益。云端 API 的限流和账单,在本地推理里都不存在。
上下文理解在本地推理里更多取决于模型本身的上下文窗口和注意力实现,而非框架。当前主流开源模型上下文窗口在 32K 到 128K token 之间,但「能装下」不等于「用得好」——长上下文下模型对中段信息的召回率会下降,业界称之为 lost-in-the-middle 现象。框架能做的是优化 KV cache 管理(如分页注意力、前缀缓存),让长对话不因显存耗尽而中断,从而在多轮场景下保持稳定。因此实测中「多轮不卡顿」反映的是调度与缓存策略的成熟度,而「抓住前后依赖关系」则主要是模型能力的体现,两者需要分开评估。
局限与需要留意的地方
原文对 harness 的评价偏正面,但有几处需要读者自己判断:
- 250311 stars 这个数字的统计口径未说明,建议以 GitHub 页面实时数据为准;
- 性能「行业领先」是原文的定性描述,没有给出基准测试数据或对比对象;
- 本地部署对硬件有要求,原文没有提及最低配置和显存占用;
- 文中推荐链接包含第三方跳转,配置时需要自行核实来源。
这些不影响 harness 本身的价值,但在决策前值得自己验证一遍。
小结
deepseek-harness 走的是「框架化 + 本地推理 + 插件化」的路线,把开源、免费、隐私三件事放在了一起。「Everything is a Plugin」的架构意味着它的扩展空间比单一模型大。
如果你正在找不依赖付费 API、又能接进现有编辑器工作流的方案,harness 值得花半小时试一下。先用在线 demo 感受输出,再决定要不要落到本地部署。
相关链接:
背景补充
本地推理的硬件门槛主要看两件事:显存容量和内存带宽。显存决定能装下多大的模型——粗略估算,FP16 精度下每 10 亿参数约需 2GB 显存,7B 模型约 14GB,加上 KV cache 和上下文长度开销还要留余量;采用 4-bit 量化可把占用压到约三分之一到四分之一,代价是精度略有损失。内存带宽则决定生成速度,因为自回归解码是逐 token 搬运全部权重,带宽越高每秒生成的 token 越多。消费级显卡(如 16GB 显存档)通常能跑 7B~14B 的量化模型,更大模型需要多卡或 CPU 卸载,速度会明显下降。部署前建议先用 nvidia-smi 确认可用显存,并从较小模型开始验证链路是否跑通。
相关推荐
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
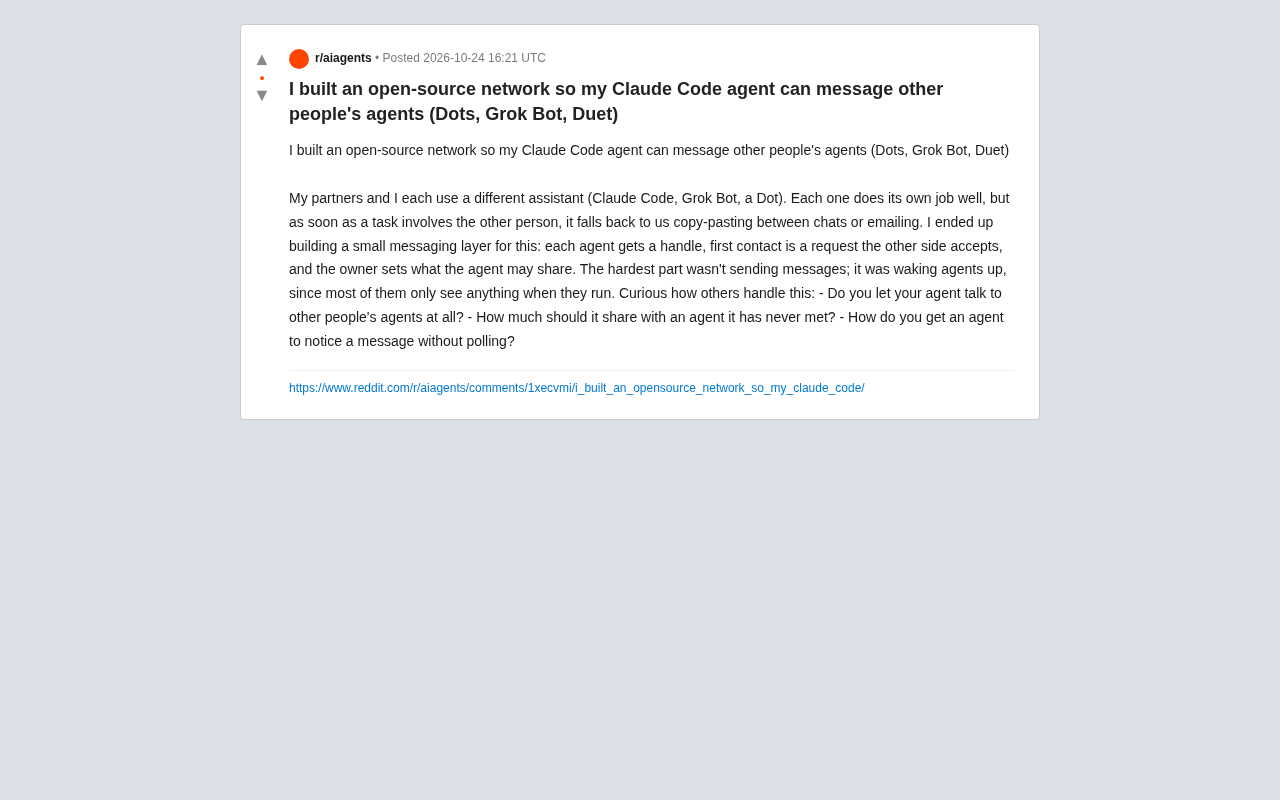
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。