DeepSeek Harness架构拆解:AI智能体的工程内核

什么是Harness?AI工程领域绕不开的核心概念
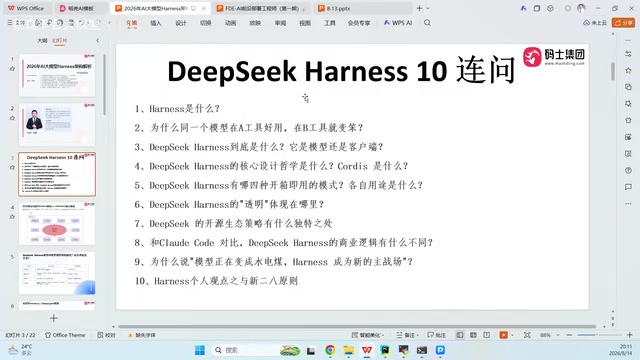
随着大模型能力的飞速提升,一个新的概念正在成为AI工程领域的高频词——Harness(马具/挽具)。DeepSeek广告发布了名为「DeepSeek Harness」的产品,也让这个术语彻底走向台前。
Harness这个词汇在AI工程领域的兴起,标志着行业从单纯追求模型能力向工程化落地的转变。在传统软件工程中,类似的分层思想早已存在——数据库提供存储能力,但ORM框架、连接池、事务管理等工程组件才让数据库真正可用。Harness架构延续了这一思路:大模型提供智能,工程体系提供可靠性、可控性和可扩展性。这种架构范式的确立,意味着AI应用开发从'炼丹'式的模型调优,进化为有章可循的系统工程。
什么是大模型与智能体
大模型(Large Language Model, LLM)是指参数量达到数十亿甚至千亿级别的深度学习模型,如GPT、Claude、DeepSeek等。这些模型通过在海量文本数据上进行预训练,获得了强大的语言理解和生成能力。从架构角度看,当前主流大模型几乎都基于Transformer架构。Transformer是Google在2017年论文《Attention Is All You Need》中提出的神经网络架构,其核心创新是自注意力机制(Self-Attention),让模型在处理每个词时能够「关注」到输入序列中的所有其他词,从而捕获长距离依赖关系。相比此前的RNN/LSTM架构,Transformer支持高度并行化训练,使得模型规模从数百万参数跃升到数千亿参数成为可能。GPT系列采用仅解码器(Decoder-only)架构,通过自回归方式逐个预测下一个token。理解Transformer架构有助于理解为什么大模型天然是无状态的——每次前向传播都是独立计算,模型权重在推理时不会更新。
智能体(Agent)则是在大模型基础上构建的应用系统,它不仅能理解和生成文本,还能通过工具调用、环境交互等方式完成复杂任务。智能体的核心特征是具备感知、决策和行动能力,能够自主规划任务步骤并执行。当前AI工程的核心挑战,就是如何将大模型的通用能力转化为可靠的智能体应用。
值得注意的是,大模型从预训练到可用产品之间还经历了关键的对齐(Alignment)阶段。预训练让模型获得通用语言能力,但要让模型按照人类意图工作,还需要指令微调(Instruction Tuning)和RLHF(基于人类反馈的强化学习)等对齐技术。SFT(Supervised Fine-Tuning,监督微调)使用高质量的指令-回答对训练模型遵循指令;RLHF则通过训练奖励模型来量化人类偏好,再用PPO等强化学习算法优化模型输出。DeepSeek还采用了GRPO等创新对齐方法。对齐技术属于模型层面的优化,而Harness架构则是在对齐后的模型之上构建工程体系,两者协同才能打造出真正可用的AI应用。
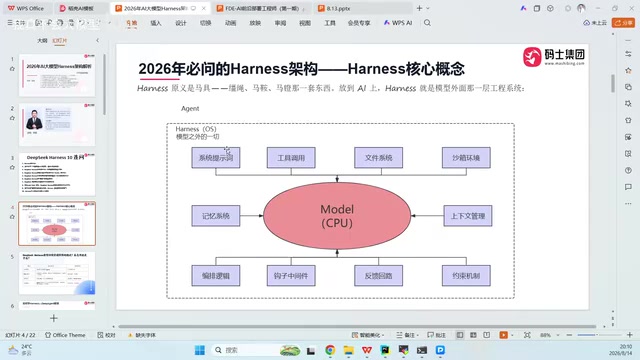
那么,Harness到底是什么?它其实包含两层含义:从产品维度看,它是DeepSeek推出的一款符合Harness架构的智能体应用;但从更本质的技术维度看,Harness代表的是一种架构范式,即模型之外的那一整套工程体系。
Harness的英文原意是「马具、缰绳、马鞍」那套装备。这个比喻非常传神:如今的大模型就像一匹能力极强的野马,力量惊人,但如果不加约束和引导,很难在企业场景中稳定发挥。而Harness,就是给这匹野马套上的缰绳与马鞍——让强大的模型能力真正被驯服、被工程化利用。
模型决定下限,Harness决定上限
理解Harness的关键,在于厘清它与模型本身的分工。
用一个类比来说:模型就像CPU,负责判断与计算;而Harness负责的是模型以外的一切工程支撑。当你把模型接入文件系统、浏览器、代码环境,当你为它构建记忆系统、上下文管理、约束边界,这些都属于Harness这一层。
为什么大模型天生「没有记忆」需要Harness补足
一个典型的痛点是:大模型本身是无状态的。你上一句问了什么,下一句它可能就「忘」了。因此智能体必须依靠外部的记忆系统来记录交互历史、维护上下文。这正是Harness要解决的核心问题之一。
无状态性与上下文窗口
大模型的「无状态」特性是其架构的固有属性。每次API调用时,模型本身并不保存任何历史信息,它只能看到当前请求中提供的上下文。这种设计虽然简化了模型架构,但给应用开发带来挑战。模型的上下文窗口(Context Window)指单次输入可容纳的最大token数量,目前主流模型已达到128K甚至200K tokens。但即便窗口再大,如果没有外部系统管理历史对话、筛选关键信息、维护任务状态,模型仍然无法在多轮交互中保持连贯性。这正是Harness层需要构建记忆系统和上下文管理机制的根本原因。
Token是大模型处理文本的基本单位,一个token大约对应0.75个英文单词或0.5个中文字符。模型的上下文窗口以token计量,例如128K tokens约等于10万字的中文文本。Token不仅决定了单次输入的容量上限,还直接影响API调用成本——主流模型供应商都按输入/输出token数量计费,价格从每百万token几美元到几十美元不等。在Harness架构中,上下文管理模块需要精心设计token预算分配策略:为系统提示词预留多少、为历史对话保留多少、为工具调用结果分配多少,这些决策直接影响应用的成本和性能平衡。
除此之外,Harness还需要处理:
- 反馈回路:当模型出错时,如何重试、回退,或将问题交由人工处理
- 边界约束:明确模型能做什么、不能做什么
- 执行环境:通过沙箱等机制安全地运行模型产出的代码
沙箱环境与代码执行安全
当智能体需要执行代码时,沙箱(Sandbox)技术是不可或缺的安全机制。沙箱是一个隔离的运行环境,限制了代码对系统资源的访问权限,防止恶意代码破坏宿主系统。常见的沙箱实现包括Docker容器、虚拟机、WebAssembly运行时等。在AI应用场景中,沙箱需要解决三个核心问题:资源限制(CPU、内存、运行时间)、权限控制(文件系统、网络访问)、结果验证(输出检查、错误捕获)。GitHub Copilot、Cursor等AI编程工具都依赖成熟的沙箱机制来安全执行模型生成的代码。
Docker容器技术是实现沙箱环境的主流方案之一。容器通过Linux的namespace和cgroups机制实现进程隔离和资源限制,相比虚拟机更轻量且启动更快。在AI应用场景中,每次代码执行可以启动一个临时容器,预装Python/Node.js等运行时,设置CPU和内存上限(如1核2GB),挂载只读的代码卷,禁止网络访问或只允许白名单域名。执行完成后立即销毁容器,确保无状态和安全性。更严格的场景还会使用gVisor、Firecracker等安全容器技术,它们提供了额外的系统调用过滤层。Jupyter Notebook、Google Colab等在线编程平台都依赖类似的容器化沙箱技术。
同一个模型,为何在不同工具里表现天差地别
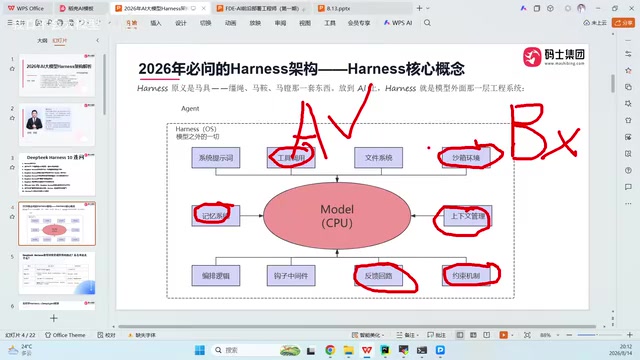
很多人有这样的困惑:明明用的是同一个DeepSeek模型,为什么在工具A里表现出色,换到工具B里就变得「很笨」?
答案就藏在Harness里。
假设智能体A拥有优秀的记忆机制、可靠的工具调用、完善的上下文管理,以及出错时的约束与兜底处理,那么它一定会表现得非常聪明。而智能体B如果这些环节做得粗糙甚至缺失,出错也没有反馈机制,那么它就会显得笨拙。
Function Calling与工具调用
工具调用(Tool Use/Function Calling)是让大模型突破纯文本交互限制的关键技术。OpenAI在2023年正式推出Function Calling功能后,这一范式迅速成为行业标准。其工作原理是:开发者预先定义工具的名称、参数和功能描述,模型在推理过程中识别需要调用工具的场景,输出结构化的函数调用请求,由外部系统执行后将结果返回模型继续处理。常见的工具包括搜索引擎、数据库查询、API调用、代码执行器等。工具调用让模型从「只会说话」进化为「能做事」,是智能体实现复杂任务的基础能力。
在工具调用的标准化方面,Anthropic在2024年底推出的MCP(Model Context Protocol,模型上下文协议)正在成为重要标准。MCP定义了一套统一的协议,让AI模型能够以标准化方式连接各种外部数据源和工具,类似于USB接口统一了外设连接方式。MCP采用客户端-服务器架构,MCP Server暴露工具和资源,MCP Client(通常嵌入在AI应用中)负责发现和调用这些工具。这意味着开发者只需为每个工具编写一次MCP Server,就能被任何支持MCP协议的AI应用调用。MCP的出现为Harness架构的工具调用层提供了标准化基础,大幅降低了工具集成的开发成本和维护负担。
这不是模型的问题,而是工程体系的差距。 模型只决定了智能体的能力下限,而上限则完全由Harness这一层的工程质量决定。
Prompt Engineering与系统提示词
Prompt Engineering(提示词工程)是引导大模型行为的核心技术。在Harness架构中,系统提示词(System Prompt)扮演着「宪法」的角色,定义了智能体的身份、能力边界、行为准则和输出格式。优秀的系统提示词设计需要平衡多个维度:清晰性(明确任务目标)、约束性(设定禁止行为)、引导性(提供思考框架)、灵活性(适应不同场景)。Few-shot Learning(少样本学习)技术通过在提示词中提供示例,能显著提升模型在特定任务上的表现。CoT(Chain-of-Thought,思维链)等技术则通过结构化提示引导模型进行逐步推理。
Few-shot Learning(少样本学习)是大模型的惊人能力之一——无需微调,仅通过在提示词中提供几个示例,模型就能理解任务模式。例如,给模型看3个'情感分类'的标注样本,它就能对新文本进行情感判断。这种能力基于In-context Learning(上下文学习)机制:模型在推理时能从当前上下文中提取模式并泛化。Few-shot的效果取决于示例质量和多样性,通常3-5个精心挑选的示例就能显著提升性能。在Harness架构中,系统提示词的设计需要平衡Zero-shot(无示例)、Few-shot(少示例)和Many-shot(多示例)的成本与收益——示例越多token消耗越大,但任务完成质量可能更稳定。
这也解释了为什么越来越多的面试官开始关注候选人对「模型外工程体系」的理解。如果你想走算法方向,那是深入模型本身;但如果你走的是AI应用开发方向,那么Harness几乎是必修课。
Harness架构的七层实现
事实上,Harness并非凭空出现的概念。在它有统一命名之前,业界已有类似的框架实践,比如DeepAgents框架,就是一套完整的Harness架构雏形。
DeepAgents框架提出了大约七个层面的模块化实现,围绕的核心正是模型之外的工程化体系,具体包括:
- 工具调用:让模型能够调用外部能力
- 文件系统:接入并操作文件
- 沙箱环境:安全地执行代码
- 上下文管理:维护对话与任务上下文
- 记忆系统:弥补模型无状态的缺陷
- 逻辑编排 / 中间件:协调各模块的执行流程
- 反馈回路 / 约束机制:处理错误、设定边界
ReAct与任务规划范式
ReAct(Reasoning and Acting)是2022年提出的智能体架构范式,核心思想是让模型交替进行推理和行动。具体流程是:模型首先分析任务(Thought),决定下一步行动(Action),观察执行结果(Observation),再基于结果继续推理,形成闭环。这种范式大幅提升了智能体处理复杂任务的能力。类似的还有Plan-and-Execute(先规划再执行)、Tree-of-Thought(思维树)等范式。Harness层的逻辑编排模块正是这些范式的工程实现,通过状态机、工作流引擎等技术协调模型与工具的交互流程,确保任务执行的可靠性和可追溯性。
Chain-of-Thought(CoT,思维链)提示技术通过引导模型'逐步思考'来提升复杂推理任务的准确性。经典的CoT提示是在问题后添加'Let's think step by step'(让我们一步步思考),这能激发模型输出中间推理过程。研究表明,CoT在数学问题、逻辑推理、多跳问答等任务上能将准确率提升20-50%。进阶技术包括:Self-Consistency(多路径采样后投票)、Tree-of-Thoughts(树状探索多个推理分支)、ReAct(推理与行动交替)。在Harness架构的逻辑编排层,这些技术被实现为可配置的推理策略,开发者可根据任务复杂度选择合适的方案。
状态机(State Machine)是实现复杂任务编排的经典模式。在智能体应用中,任务执行可以建模为状态转移过程:初始状态→规划状态→工具调用状态→结果验证状态→完成状态。每个状态定义了允许的转移条件和处理逻辑。工作流引擎如Apache Airflow、Temporal、Prefect等提供了更高层的抽象,支持DAG(有向无环图)定义、重试策略、并行执行、错误处理等企业级特性。在Harness架构中,逻辑编排层通常实现一个轻量级的状态机或工作流引擎,用于协调模型推理、工具调用、结果处理的执行顺序,确保任务流程的可靠性和可观测性。
RAG与知识增强
RAG(Retrieval-Augmented Generation,检索增强生成)是解决大模型知识时效性和专业性问题的关键技术。其原理是在模型生成回答前,先从外部知识库检索相关文档,将检索结果注入到提示词中,让模型基于最新、最准确的信息作答。RAG系统通常包含三个核心组件:文档处理(分块、向量化)、向量数据库(存储和检索)、检索策略(相似度计算、重排序)。在Harness架构中,RAG可视为一种特殊的工具调用,为模型提供动态知识支持。LangChain、LlamaIndex等框架已将RAG标准化为可复用的模块。
向量数据库是RAG系统的核心基础设施,它将文本转换为高维向量(Embedding)后存储,支持基于语义相似度的快速检索。与传统数据库的关键词匹配不同,向量检索能理解'北京的天气'和'首都气温'是相似查询。主流的向量数据库包括Pinecone、Weaviate、Milvus、Qdrant等,它们通过HNSW、IVF等索引算法实现毫秒级检索。在生成Embedding时,通常使用专门的嵌入模型如OpenAI的text-embedding-ada-002或开源的sentence-transformers。向量维度一般在384到1536之间,维度越高表达能力越强,但存储和计算成本也越高。
Guardrails与AI安全
Harness架构的七层中,「反馈回路/约束机制」层与当前AI安全领域的Guardrails(护栏)技术密切相关。Guardrails不仅是简单的内容过滤,而是一套多层次的安全防护体系。在输入层面,需要检测提示注入攻击(Prompt Injection)——恶意用户通过精心构造的输入试图绕过系统指令,例如在正常问题中嵌入「忽略上述所有指令」来劫持模型行为。在输出层面,需要检测幻觉(Hallucination)、有害内容、隐私信息泄露等问题。Nvidia的NeMo Guardrails、Guardrails AI等开源框架提供了可编程的护栏机制,开发者可以定义规则来拦截不当输入和输出。在企业级应用中,Guardrails还需要覆盖合规性检查、敏感数据脱敏、审计日志等需求。对于金融、医疗、法律等高风险行业,Guardrails层的完善程度直接决定了AI应用能否通过监管审批。
可观测性与评估体系
在Harness架构的工程实践中,可观测性(Observability)和评估(Evaluation)是确保系统持续可靠运行的关键环节。在传统软件中,日志、指标和链路追踪构成了可观测性三大支柱。AI应用同样需要完善的可观测性体系,但面临独特挑战:模型输出具有随机性、推理过程不透明、质量评估难以自动化。LangSmith、Langfuse、Phoenix等AI专用可观测性平台应运而生,它们能够追踪每次LLM调用的输入输出、token消耗、延迟、工具调用链路等信息,帮助开发者快速定位问题。评估(Evaluation)则是Harness架构中常被忽视但极为关键的环节——如何衡量智能体的回答质量、任务完成率、幻觉比例?常见方法包括人工评估、LLM-as-Judge(用大模型评估大模型)、基于规则的自动化检查等。没有评估体系的Harness架构就像没有测试的软件——看似能运行,但质量无法保证。
这七层共同构成了一个智能体真正「聪明」的工程基础。DeepSeek Harness的发布,本质上是把这套工程范式产品化、标准化,并赋予了它一个清晰的名字。
拥抱Harness架构:开发者的核心竞争力
从工程实践的角度看,AI领域的技术迭代极快,谁能更快掌握新技术,谁就能在求职、项目开发中占据优势。
DeepSeek Harness的意义,不仅在于它是一款可以下载体验的智能体产品,更在于它标志着「模型 + Harness」这一双层架构正式成为AI应用开发的主流范式。对于开发者而言,理解并掌握Harness架构,意味着能够真正驾驭大模型的能力,构建出稳定、可靠、聪明的智能体应用。
LangChain是目前最流行的AI应用开发框架之一,它将Harness架构的各个组件标准化为可复用的模块。框架提供了Chains(链式调用)、Agents(智能体)、Memory(记忆)、Tools(工具)等核心抽象,开发者可以像搭积木一样组装AI应用。例如,一个简单的ReAct Agent可能包含:LLM组件(调用模型)、ToolKit(工具集合)、AgentExecutor(执行器)、ConversationBufferMemory(对话记忆)。LangChain还内置了与主流模型API、向量数据库、文档加载器的集成。类似框架还有LlamaIndex(专注RAG)、Semantic Kernel(微软出品)、Haystack等,它们共同推动了Harness架构的工程化和标准化。
总结来说:模型是野马,Harness是马鞍。真正决定一个AI应用天花板的,从来不只是模型本身,而是模型之外那一整套精心设计的工程体系。
核心要点
- Harness是模型之外的工程体系,负责工具调用、记忆管理、上下文维护等关键功能
- 大模型的无状态特性需要外部系统补足,上下文窗口再大也无法替代工程化的记忆机制
- 同一模型在不同应用中表现差异巨大,根本原因在于Harness层的工程质量
- Function Calling、ReAct、RAG等技术是Harness架构的核心组成部分
- MCP协议正在成为工具调用的行业标准,Guardrails技术构建多层安全防护
- 可观测性和评估体系是确保Harness架构持续可靠运行的关键基础设施
- 掌握Harness架构是AI应用开发者的核心竞争力,也是面试的重点考察方向
- Token计费模式、向量数据库、Docker沙箱、LangChain框架等是实现Harness架构的关键技术基础设施
相关推荐

Applebee's应用硬编码数据库密码泄露客户数据
安全研究人员在Applebee's移动应用中发现硬编码的数据库密码,凭据允许不受限制访问客户个人数据。本文分析事件成因、客户端凭据管理的常见缺陷,以及后端代理、短期令牌、发布前密钥扫描等防护实践。

科技极客万圣节装扮:AI图标、PHP漏洞与Bryan Johnson
万圣节没准备装扮?这篇极客装扮指南给出三个低成本方案:伪装成看似无害的AI智能体图标、扮成PHP漏洞,或化身睡意朦胧的Bryan Johnson。文章解析每个梗背后的AI热潮、开源安全与长寿科技隐喻,并给出最后一天也能落地的实操建议。

多Token预测还能更优?一行代码解锁Soft-MTP
前沿预训练标准配方MTP存在梯度噪声问题,研究者提出Soft-MTP,仅需一行代码即可分离KL自蒸馏信号,提升推测解码与下一Token预测性能,并开源代码与论文。