DeepSeek-Reasonix:基于前缀缓存优化的终端AI编程代理

DeepSeek-Reasonix是专为DeepSeek模型优化的终端AI编程代理,以前缀缓存稳定性为核心优势。
DeepSeek-Reasonix是一款用TypeScript编写的终端AI编程代理工具,专为DeepSeek模型原生设计。其核心创新在于围绕"前缀缓存稳定性"进行深度架构优化,通过维持持续运行状态复用KV Cache计算结果,实现更低延迟、更低API成本和更连贯的代码理解。相比通用型AI编程工具,它以模型专注、性能优先和完全开源为差异化策略,适合长时间编码会话和成本敏感的开发者。
DeepSeek-Reasonix 项目概述
DeepSeek广告-Reasonix 是一款专为 DeepSeek 模型原生设计的 AI 编程代理工具,直接运行在终端环境中。项目使用 TypeScript 编写,目前在 GitHub 上已获得 857 颗星标和 53 个 Fork,反映出开发者社区对专用型 AI 编程工具的持续关注。
该工具的核心设计理念围绕"前缀缓存稳定性"(prefix-cache stability)展开,官方给出的使用建议是"让它持续运行"——这一设计哲学使其在众多 AI 编程代理中形成了鲜明的差异化定位。
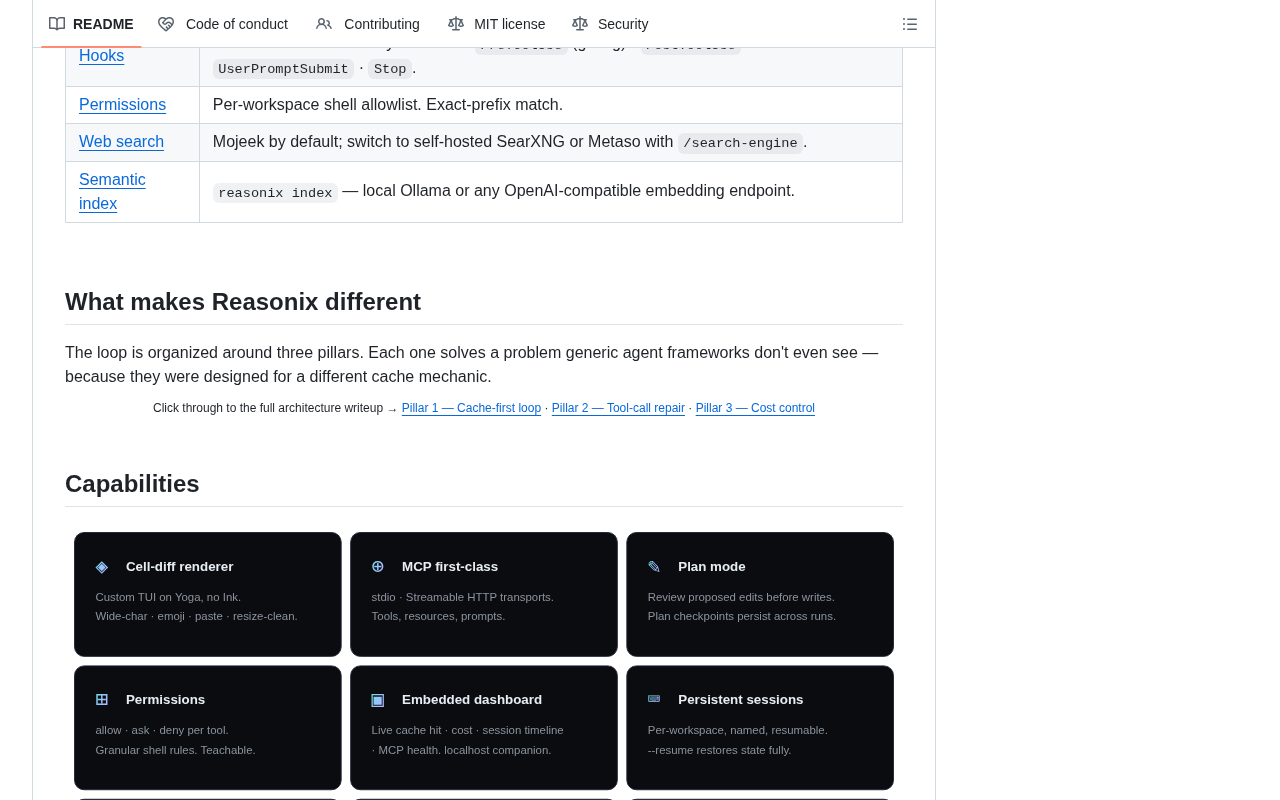
核心特性:前缀缓存稳定性机制
前缀缓存的工作原理
在大语言模型的推理过程中,前缀缓存(Prefix Cache)是一项关键的性能优化技术。当用户与 AI 进行多轮对话时,之前对话产生的上下文会被缓存下来,后续请求可以直接复用这些计算结果,从而避免重复的 KV Cache 计算,显著降低响应延迟和 API 调用成本。
要理解前缀缓存的价值,需要先了解其底层的 KV Cache 机制。在 Transformer 架构的大语言模型中,每次生成新 token 时都需要计算注意力机制中的 Key 和 Value 矩阵。KV Cache 技术将已计算过的 Key-Value 对缓存起来,避免在自回归生成过程中重复计算。前缀缓存则是在此基础上的进一步优化——当多个请求共享相同的前缀(如系统提示词或之前的对话历史)时,服务端可以直接复用已缓存的 KV 状态,跳过这部分的前向传播计算。DeepSeek 的 API 服务在架构层面原生支持这一机制,对缓存命中的输入 token 收取显著更低的费用(通常为正常价格的十分之一),这为围绕缓存稳定性进行工程优化提供了强大的经济激励。
为什么 Reasonix 强调"保持运行"
DeepSeek-Reasonix 围绕前缀缓存机制进行了深度架构优化。传统 AI 编程助手每次启动都需要重新建立上下文,而 Reasonix 通过维持持续运行状态来保障缓存的稳定性。这种设计带来了三个核心优势:
- 更低的响应延迟:缓存命中时,模型无需重新处理完整的上下文历史,推理速度大幅提升
- 更低的 API 使用成本:DeepSeek 对缓存命中的 token 采用更低的计费标准,长时间运行可节省可观费用
- 更连贯的代码理解能力:持续运行确保 AI 对项目结构和代码逻辑的理解不会因会话中断而丢失
技术定位与生态适配
DeepSeek 原生优化设计
与 Aider、Cursor 等通用型 AI 编程工具不同,Reasonix 明确将自己定位为"DeepSeek-native"工具。这意味着它专门针对 DeepSeek 模型的推理能力、上下文窗口管理策略以及 API 接口特性进行了定向优化。这种专一化路线往往能在特定场景下提供比通用方案更出色的实际体验。
DeepSeek 是由深度求索公司开发的大语言模型系列,其中 DeepSeek-V3 以其 MoE(Mixture of Experts,混合专家)架构著称,拥有 671B 总参数但每次推理仅激活约 37B 参数,在保持高性能的同时大幅降低了计算成本。DeepSeek-R1 则是其推理增强版本,通过强化学习训练获得了类似 OpenAI o1 的链式思考(Chain-of-Thought)能力,在数学推理和代码生成任务上表现尤为突出。DeepSeek API 的定价策略在行业中极具竞争力,其缓存命中 token 的折扣机制更是为 Reasonix 这类工具提供了独特的优化空间——通过精心管理上下文前缀的一致性,可以将实际使用成本压缩到极低水平。
通用型 AI 编程工具为了兼容多个模型提供商(OpenAI、Anthropic、Google 等),通常需要在 prompt 工程、上下文管理和输出解析层面采用最大公约数式的设计,无法充分利用特定模型的独特能力。而专注单一模型生态的工具可以针对该模型的具体特性进行深度调优:例如针对 DeepSeek 的 token 化方式优化上下文压缩策略,利用其特有的 API 参数(如前缀缓存控制)实现更精细的性能管理,以及根据模型在代码任务上的具体行为模式设计更有效的 prompt 模板。这种策略在数据库领域有类似先例——专用数据库(如时序数据库 InfluxDB、图数据库 Neo4j)在特定场景下往往比通用数据库表现更优。
终端优先的交互设计
项目选择终端作为主要交互界面,契合了大量开发者的日常工作习惯。相比 IDE 插件或 Web 界面,终端工具更加轻量灵活,能够无缝融入 Git、Docker、SSH 等现有命令行工作流,减少上下文切换的认知负担。
终端优先(Terminal-first)的设计理念根植于 Unix 哲学——每个工具做好一件事,通过管道和组合实现复杂功能。在现代开发工作流中,终端仍然是连接各类工具的核心枢纽:Git 版本控制、Docker 容器管理、SSH 远程开发、包管理器、CI/CD 流水线等关键操作都以命令行为主要交互方式。选择终端作为 AI 编程代理的载体,意味着工具可以直接访问文件系统、执行 shell 命令、读取环境变量,并与开发者现有的 dotfiles 配置和 shell 脚本无缝协作。相比 IDE 插件需要适配 VS Code、JetBrains 等不同平台的 API,终端工具的跨平台兼容性天然更强,部署和维护成本也更低。
市场竞争格局分析
当前 AI 编程代理领域竞争白热化,从 GitHub Copilot 到 Cursor,从 Aider 到 Claude Code,各类产品各有侧重。
AI 编程代理(AI Coding Agent)经历了从简单的代码补全到自主编程代理的快速演进。早期的 GitHub Copilot 主要基于 Fill-in-the-Middle(FIM)模式进行行级或块级代码补全。Cursor 则引入了更深度的 IDE 集成,支持多文件编辑和对话式交互。Aider 作为开源终端工具的先驱,率先实现了基于 Git 的代码变更管理。Claude Code 则代表了 Anthropic 在 agentic coding 方向的探索,支持自主执行终端命令和文件操作。这些工具的共同趋势是从被动的代码建议向主动的任务执行演进,即从 Copilot 模式走向 Agent 模式——AI 不仅生成代码,还能理解项目结构、运行测试、调试错误,甚至自主规划多步骤的开发任务。
DeepSeek-Reasonix 在这一竞争格局中选择了三个差异化切入点:
- 模型专注策略:深耕 DeepSeek 生态,而非追求多模型兼容
- 性能优先理念:以缓存稳定性为核心竞争力,强调长时间运行场景下的效率优势
- 完全开源路线:代码完全开放,支持社区贡献和企业定制化部署
对于已经在使用 DeepSeek API 的开发者和团队而言,Reasonix 提供了一个成本效益比更高的编程辅助方案。
典型适用场景
- 需要在长时间编码会话中获得持续 AI 辅助的全栈开发者
- 希望有效控制 DeepSeek API 调用成本的创业团队和独立开发者
- 偏好终端工作流、习惯命令行操作的后端工程师和 DevOps 人员
- 对 DeepSeek 推理模型(如 DeepSeek-R1)有深度使用需求的 AI 应用项目
总结与展望
DeepSeek-Reasonix 代表了 AI 编程工具发展的一个值得关注的方向:不追求大而全的功能覆盖,而是围绕特定模型的底层技术特性进行深度优化。前缀缓存稳定性这一设计理念,体现了团队对 LLM 推理机制的深入理解,也为用户带来了切实可感的性能提升和成本节约。
随着 DeepSeek 模型能力的持续迭代升级,以及开发者对 API 成本敏感度的提高,这类原生优化工具的实用价值将进一步凸显。对于正在寻找高性价比 AI 编程方案的开发者来说,DeepSeek-Reasonix 值得纳入工具链的评估范围。
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。