DeepSeek V4.1 Flash 1017 实测:最强开源模型?

DeepSeek V4.1 Flash 1017 主打智能体编程,性价比极高但稳定性不足。
DeepSeek 通过 V4.1 Flash 1017 迭代更新重回开源模型竞争中心,官方称实现「帕累托改进」。模型重点转向智能体编程与项目级交付,配套开放搜索与抓取 API,定价为每千次调用 0.75 美元。基准上 Terminal Bench 4.0 升至 42.3%、HLE 升至 42.6%,多项指标超越前沿闭源模型。实测速度约 244 至 300 tokens/秒,3D 与前端生成能力较初版大幅跃升,成本可比 Opus 5.5 低约 26 倍。但复杂任务耗时明显更长、表现不稳定,部分功能完成度不及闭源模型。模型在深度推理中自称 OpenAI 模型,引发蒸馏猜测但无确凿证据。作者建议搭配 DeepSeek Harness 使用以放大智能体能力。
DeepSeek 在经历一段沉寂后,凭借 V4.1 Flash 1017 更新再次回归开源模型的竞争中心。这款模型并非全新旗舰,而是对 9 月 10 日发布的 V4.1 Flash 的迭代升级,官方称其实现了「帕累托改进」——在相同或更低成本下获得更强性能。YouTube 科技频道 World of AI 对其进行了多轮实测,结论是:这可能是目前性价比最高的开源模型,但离完美仍有距离。
核心升级:从写代码到交付项目
DeepSeek广告 此次将重点放在智能体编程(agentic coding)和项目开发上。模型采用带自反馈的强化学习训练,目标不再是生成孤立的代码片段,而是完成从游戏生成、应用搭建到 3D 建模的完整开发流程。这一转变意味着模型开始具备端到端交付能力,而非停留在辅助补全层面。
配套动作同样值得关注:DeepSeek 开放了搜索与抓取 API,由自有搜索基础设施支撑,官方称可处理全球每日数亿次请求,定价为每 1000 次调用 0.75 美元。通过 DeepSeek API 搭配 CloudCode、Codex 或 DeepSeek Harness 使用时,服务端搜索与抓取调用目前免费至 10 月 31 日 16 UTC。
智能体编程(Agentic Coding) 与传统代码补全的关键区别在于任务闭环。传统模式是「给定上下文,预测下一段代码」;智能体编程则要求模型自主规划步骤、调用工具(编辑器、终端、浏览器、测试框架)、读取执行结果并据此修正,直至完成一个可运行的项目。带自反馈的强化学习在这里起核心作用:模型在沙盒中反复尝试,用编译错误、测试通过率、渲染结果等信号作为奖励,逐步学会「先做什么、失败后怎么改」。这也是为什么文章强调它从「生成代码片段」转向「端到端交付」——评价标准不再是单轮输出像不像代码,而是最终产物能否跑通。
基准测试:多项指标超越前沿模型
根据 DeepSeek 公布的数据,V4.1 Flash 1017 在多个基准上录得明显提升:
- Terminal Bench 4.0 从 31.2% 升至 42.3%,超过 GPT 5.6 Sol 的 39.9%
- DeepSafe 1.1 得分 77%,在官方对比中领先 GPT 5.6 Sol、Claude Opus 5 和 GLM 5.3
- HLE 从 36.8% 提升至 42.6%,推理能力有可见跃升
在 World of AI Benchmark 的跨领域测试中,该模型综合排名第 10 至 11 位。虽然未进入前十,但其智能体编程能力尤为突出。定价为每百万输入 token 0.30 美元、每百万输出 token 1.20 美元,附带一百万 token 折扣,目前堪称最佳开源模型之一。需要提醒的是,模型体量过大,无法在本地运行。
Terminal Bench 是评估模型在真实命令行环境中完成多步骤任务能力的基准,题目通常要求在终端里安装依赖、修改文件、运行脚本并验证结果,考察的是工具调用与错误恢复能力,而非单纯的知识问答。HLE(Humanity's Last Exam) 则是面向专家级难度的高区分度题库,覆盖数学、自然科学与人文学科,用于测量模型在长链条推理上的上限,分数提升往往意味着推理深度而非记忆量的增长。需要留意的是,基准分数与实测体验常有落差:基准多为单轮、结构化的评测,而实际开发任务涉及长上下文、多轮纠错与不确定的环境反馈,因此文章中的排名与实测表现需分开看待。
实测表现:速度惊人,前端与 3D 进步显著
实测中最直观的感受是速度。早期测试录得约 244 tokens/秒,部分场景接近 300 tokens/秒,这一速度甚至可能超过 GPT 6.1 Sol 的超快模式,而智能水平与 GPT 5.6 Sol 相当。
3D 生成能力的提升堪称「昼夜之别」。与两个月前的初版 V4.1 Flash 相比,新模型在相同提示下产出的 3D 场景质量大幅跃升。前端开发同样进步明显:排版、动态运动、细微动画效果和滚动触发都处理得流畅自然。在 360 度产品查看器测试中,模型完整编码出 3D 产品视觉,这是多数模型容易失败的环节。
一个体素艺术测试中,模型生成了包含超过 200 万体素的中世纪王国场景,耗时约 25 分钟,API 成本仅 5 美元,还自带昼夜循环和飞龙等细节。另一项测试要求生成带细节草地、树木和随风蒲公英的场景,模型一轮即完成,并自动配上了环境音效。
成本对比:便宜得离谱,但速度有代价
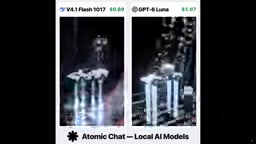
价格优势在多组对比中反复出现。在「骑自行车的鹈鹕」SVG 提示中,DeepSeek 输出成本 23 美分,而 Opus 5.5 花费 6 美元,前者便宜约 26 倍,但 DeepSeek 耗时 1 小时,Opus 仅用 20 分钟。特斯拉 Roadster 3D 场景测试中,DeepSeek 花费 89 美分,GPT-6 Luna 为 1.07 美元,便宜约 17%,但 Luna 的输出质量略优。
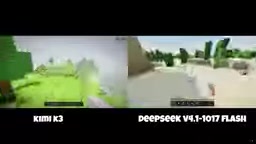
第一人称跑酷游戏(单 HTML 文件)测试更暴露了取舍:DeepSeek 视觉效果好,成本 14 美分,但耗时 1 小时 30 分钟;Haiku 仅花 8 美分且速度更快,功能完成度反而更高。Minecraft 沙盒游戏对比中,Kimi K3 耗时 2.5 小时、成本 35 美元,DeepSeek 耗时 1.5 小时、成本 80 美分,便宜近 44 倍,但 DeepSeek 在许多功能上表现吃力,需要多轮提示才能接近。
Gemini 4 Argon 的 SVG 测试则呈现另一种反差:Argon 13 分钟完成、花费 1.20 美元,DeepSeek 耗时 50 分钟、花费 40 美分,便宜 3 倍,最终水面细节甚至更佳,但整体场景 Argon 更优。作者的评价很中肯:这个模型有时表现出色,有时偏慢,表现并不稳定。
蒸馏疑云与 Harness 组合
一个引发讨论的细节是,模型在某些深度推理响应中会自称 OpenAI 模型,这被部分观察者视为蒸馏训练的间接证据。作者在视频中展示了相关输出,但明确表示这并非确凿证据,只是「很有可能」。
另一个实用建议是搭配 DeepSeek Harness 使用。Harness 围绕 DeepSeek 模型设计,优化了工具调用、上下文管理和代码执行方式。相比通过 API 单次生成代码,接入 Harness 后模型可以持续测试、识别错误并迭代输出,智能体能力明显增强。在 Hermes Agent 中使用 Blender 的测试耗时 7 小时,但成本仅 1.83 美元,适合作为过夜任务运行。视频生成方面模型也有不错表现,主要瓶颈在素材生成时间。
模型蒸馏(Distillation) 指用强模型(教师)的输出去训练或微调另一个模型(学生),使学生以更低成本逼近教师的部分能力。常见做法包括在黑盒 API 上收集教师的推理轨迹做监督微调,或对输出分布做对齐。蒸馏本身并不违规,但多数闭源厂商的服务条款禁止用其输出训练竞品模型,因此一旦被怀疑,就容易引发合规争议。文章提到的「模型自称 OpenAI」属于弱证据:它可能来自训练数据中混入的对话样本、系统提示词的污染,也可能来自蒸馏时继承的说话风格,单凭这一点无法定论。判断蒸馏通常需要更系统的证据,例如输出分布的异常相似、特定错误模式的复现,或训练数据来源的披露。
值得尝试,但别期待完美
综合来看,V4.1 Flash 1017 在编码能力、3D 输出和性价比上确实达到了 Flash 级别模型的新高度,开源属性对社区是实打实的利好。它并不完美:输出速度不稳定、复杂任务耗时偏长、部分功能完成度不及闭源前沿模型。但考虑到其价格仅为对手的几十分之一,且可通过网页版免费试用,对于需要批量运行智能体任务的开发者而言,这是一个值得认真评估的选择。
Harness 在这里指围绕模型搭建的智能体外壳(agent scaffold),负责提示词编排、工具注册与调用、上下文压缩、沙盒执行和失败重试。同一模型接入不同 Harness,表现可能相差很大:单次 API 调用只给模型一次机会,而 Harness 让它能运行代码、读取报错、分步迭代,把「一次性生成」变成「持续调试」。这也是文章建议搭配 DeepSeek Harness 使用的原因——模型能力被外壳放大后,长耗时任务的完成率会显著提升。对开发者而言,评估一个开源模型时应把模型权重与 Harness 视为整体,比较成本时也要把重试与迭代带来的额外 token 消耗计入。
相关推荐

空陆两栖变形无人机:除了省电100倍,还有什么真需求?
空陆两栖变形无人机是否只是噱头?从M4 Morphobot的100倍功耗差异出发,探讨变形无人机的真实应用场景与论文选题思路,分析纯无人机和纯地面机器人均失效的边界条件。

Warhound融资2亿美元:基因工程“战犬”搭配Anduril装备
Warhound完成2亿美元融资,由Ben Lamm和Palmer Luckey推动,通过基因工程改造犬类用于军事和执法,并搭配Anduril装备。本文分析其技术方向、融资逻辑与伦理争议。

Claude API登陆Google Cloud:IAM集成与SDK接入指南
Anthropic将完整Claude API托管在Google Cloud上,通过Google Cloud IAM控制权限并统一计费。本文梳理Vertex AI与Anthropic托管两个服务入口、IAM角色配置要点及SDK接入方式,帮助企业复用现有云治理框架引入Claude模型。