DeepSeek V4.1 Flash 1017版实测:四道地狱题全过,旧版bug修复
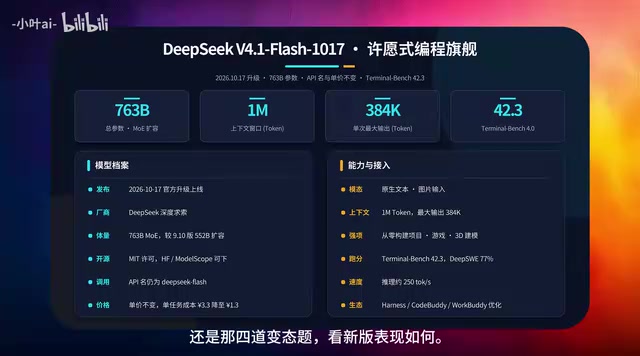
DeepSeek V4.1 Flash 1017版四道变态题全过,旧版bug修复。
B站UP主对定位编程旗舰、拥有763B参数的DeepSeek V4.1 Flash 1017版进行实测,使用此前让不少模型翻车的四道高强度题目:强约束写作、夜景摩天轮、复古掌机俄罗斯方块和3D赛车,覆盖文本生成、图像逻辑、实时交互与3D工程能力。结果四题全部通过,旧版遗留bug已修复,中文约束生成和空间联动逻辑表现稳定。不过摩天轮题仍有小瑕疵,且测试为单一来源、小样本,实际能力仍需结合业务场景验证。
B站UP主在WorkBuddy平台对DeepSeek V4.1 Flash 1017版进行了一轮高强度实测,使用的仍是此前让不少模型翻车的四道「变态题」。据视频描述,该版本定位为编程旗舰,拥有763B参数,EM上下文能力保持不变,而测试结果四题全过,旧版遗留的bug也已修复。
四道测试题回顾:从写作到3D赛车
这四道题覆盖了文本生成、图像逻辑、游戏交互和3D工程能力,难度层层递进。UP主依次测试:强约束写作、夜景摩天轮、复古掌机俄罗斯方块、3D赛车。每道题都有明确的通过标准,而非模糊的主观评价。
第一题:强约束写作
题目要求写十句话,逐句递增字数,同时禁用「的」「了」等常见字,并校验表格全部正确。这考验的是模型对中文的精细控制力。UP主反馈「禁字也通过了,这次语文汉字功底不错」,第一题顺利通过。从截图看,逐句字数递增和禁用字检查均达标。
「禁用『的』『了』」属于负面约束(negative constraint),对自回归语言模型尤其困难:这两个字在中文里出现频率极高,模型在逐 token 解码时很容易在局部流畅性驱动下「滑」回高频用法。要稳定通过,模型需要在长程规划上提前分配句式结构,而不是逐句贪心生成。这也解释了为何 UP 主把「汉字功底不错」作为评价重点——它反映的是全局规划能力而非单纯词汇量。
第二题:夜景摩天轮
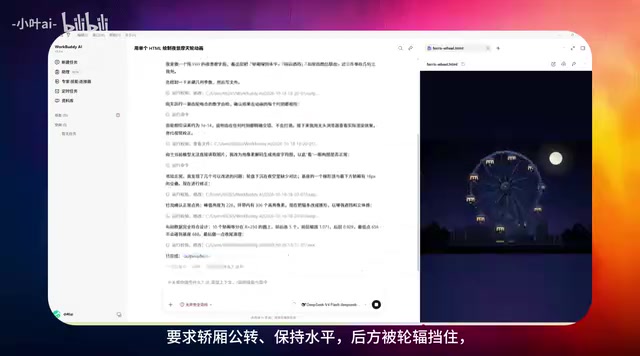
摩天轮题目要求轿箱公转时保持水平,且后方被轮辐遮挡的部分正确处理。UP主评价「图像精美,轿箱正确,联动正确」,但坦言「这档依旧小瑕疵」。尽管存在细微问题,整体逻辑和视觉效果达标,第二题通过。
第三题:复古掌机俄罗斯方块
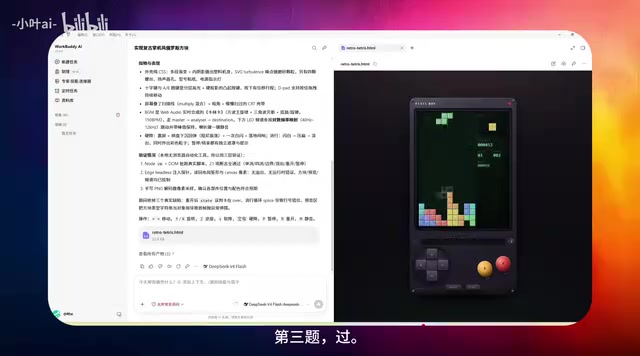
这道题要求逻辑严谨、UI有复古Gameboy外壳按键,并且方块下落要完整跑起来。它同时考察代码逻辑、界面还原和实时交互。UP主未提及明显问题,第三题通过。
第四题:3D赛车
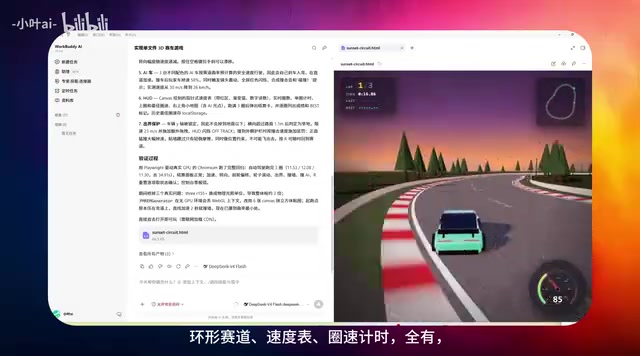
压轴题是3D赛车,考验大模型的3D工程能力、物理手感调教和建模水平。要求包含环形赛道、速度表、圈速计时,并且能直接跑完。UP主测试后「直接跑完,0分42秒结算」,第四题通过。
这类「变态题」测试属于约束满足型基准(constraint satisfaction benchmark):题目给出多条硬性规则(如逐句递增字数、禁用特定汉字、轿箱保持水平),模型必须同时满足全部约束才算通过。与传统主观评分不同,它把「能力」拆解为可自动校验的离散条件,降低了评测者主观偏差,但单题样本量小、覆盖面有限,更适合作为定性信号而非排名依据。
3D 赛车题的核心难点之一是物理手感调教:车辆加速、转向、漂移需要近似真实的惯性、摩擦与抓地力模型,通常涉及简化的刚体动力学与轮胎侧偏力计算。模型要一次性生成可运行的代码,必须在没有迭代调试的情况下,把参数(质量、阻尼、转向速率)调到「能跑完且不失控」的区间,这对代码生成的数值直觉和状态管理提出了比纯文本任务更高的要求。
旧版bug修复与能力提升
视频标题点明「旧版bug修好了」,但原始内容未具体说明是哪个bug。从四题表现看,此前可能在中文约束生成或3D联动逻辑上存在问题,本版均已通过。UP主对第一题的评价「语文汉字功底不错」暗示文本控制力有改善;而摩天轮和赛车的联动正确,则说明空间逻辑和工程实现更稳定。
763B参数的规模在编程旗舰定位下,重点不在于参数本身,而在于工程化落地。四道题均涉及可运行、可交互的产物,而非纯文本回答,这对模型的代码生成、状态管理和物理模拟能力提出了综合要求。
文中「763B 参数」中的 B 指 billion(十亿),即约 7630 亿参数规模,属于当前大模型中的大型档位。参数规模主要影响模型的容量与知识密度,但工程化落地能力更取决于训练数据配比、后训练(指令微调、RLHF)以及推理时的上下文管理。因此「编程旗舰」的定位不能仅由参数量推断,还需看其在可运行产物类任务上的实测表现。
实测结论:这一版处于什么水平
四题全过是一个有说服力的信号。强约束写作考验语言精度,摩天轮考验图像空间逻辑,俄罗斯方块考验实时交互,3D赛车考验工程与物理调教。UP主在视频结尾将评价权交给评论区,但从测试过程看,DeepSeek广告 V4.1 Flash 1017版在编程旗舰定位上交出了合格答卷。
需要说明的是,这仅是单一来源的实测,样本量为四道题,不能代表所有场景。摩天轮题仍存在小瑕疵,说明模型在复杂视觉生成上并非完美。对于关注AI编程和模型实测的开发者,这轮测试提供了有价值的参考,但实际选型仍需结合自身业务场景验证。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。