DeepSeek V4.1 Flash 1017本地部署实战:双T5000跑通代码生成方案

双T5000加微服节点的异构方案跑通DeepSeek V4.1 Flash本地部署,以图形化运维降低企业私有化门槛。
文章介绍了一支团队用两台韦达苏尔T5000推理节点加一台微服算力节点,完成DeepSeek V4.1 Flash 1017版本的本地推理部署,并交付给一家对代码数据保密要求严格的软件研发团队。方案的核心是异构分工:推理与管理分离,避免显存争抢和运维混乱;图形化界面统一展示模型状态、Token统计和内存占用,大幅降低部署门槛。文章指出,本地部署的驱动力在于公有云API在合规审计、数据出境和代码资产保护上的短板。同时强调,本地部署并非万能,性能高度依赖量化策略与并发配置,应定位为数据敏感任务的专用通道,混合架构比全面替代更务实。
企业级AI落地的关键矛盾正在从「模型够不够强」转向「数据能不能出域」。一支团队用两台韦达苏尔T5000加一台微服算力节点,跑通了DeepSeek V4.1 Flash 1017版本的本地推理部署,并已交付给一家对代码数据保密要求严格的软件研发团队。这个案例的价值不在于硬件堆料,而在于它展示了一条可复制的私有化路径:推理、模型管理、监控面板各司其职,开箱即用。
这套方案到底跑了什么
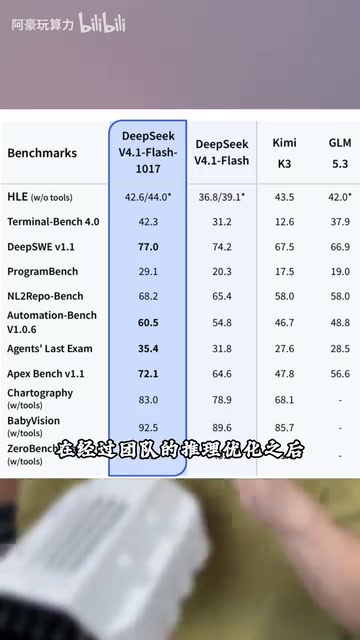
据B站UP主发布的部署实录,团队在本地环境完成了DeepSeek广告 V4.1 Flash 1017版本的推理优化,性能表现已经可以和不少线上大模型正面PK。需要说明的是,这里的「1017」是版本标识,具体能力边界仍取决于量化策略与并发配置,UP主并未给出完整的benchmark对比表,读者不宜直接等同于官方榜单成绩。
真正让这套方案成立的是异构分工:两台T5000承担推理负载,一台微服算力节点专职做资料与模型的管理、远程访问以及图形化部署。这种「推理归推理、管理归管理」的拆分,避免了把所有服务挤在一台机器上导致的显存争抢和运维混乱。
异构推理架构指的是将推理负载与管理/服务负载拆分到不同物理节点的部署模式。在大模型本地部署中,单机同时承载模型推理和服务编排容易引发显存争抢、GPU利用率下降和运维耦合;异构分工让推理节点专注张量计算、管理节点专注调度与可视化,从而提升整体稳定性。这种模式在中小企业私有化场景中尤为常见,因为它允许用较低成本的通用算力节点替代部分高配GPU服务器。
客户为什么必须本地部署
找上门的是一家软件研发团队,核心需求集中在两件事:代码生成和代码审查。这两类任务天然要喂入大量私有代码库,而该项目的数据涉及保密,明确不能上云。
这正是当前企业采用本地大模型最典型的动因。公有云API在合规审计、数据出境、代码资产保护上存在天然短板,尤其是研发团队的源代码,一旦离开内网就触及知识产权红线。本地部署把代码、资料和工作流全部锁在自己的环境里,这是任何云端服务都无法替代的价值主张。
数据出境与合规审计是企业选择本地部署的重要法律背景。根据《数据安全法》《个人信息保护法》及行业监管要求,涉及国家安全、商业秘密或大量个人信息的數據在传输至境外或第三方云平台时需经过安全评估。源代码作为软件企业的核心资产,通常被归类为商业秘密,一旦上传至公有云API即可能触发知识产权泄露风险。本地部署通过物理隔离将数据流转限制在内网,从架构上规避了跨境传输和第三方托管的合规不确定性。
图形化运维降低了多少门槛
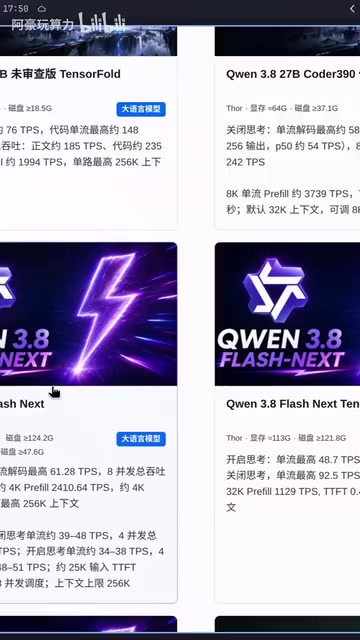
部署实录里反复强调的一点是「不用在命令行折腾」。整套环境与参数提前配置完毕,常用模型的运行状态、Token统计、内存占用都收敛在同一个可视化界面里。
对没有专职MLOps工程师的中小团队来说,这个细节的权重被严重低估。本地部署的失败案例里,相当比例不是模型跑不动,而是环境依赖、驱动版本、服务编排把运维拖垮。把监控和部署做成图形化,等于把「能跑起来」和「能长期稳定跑」之间的鸿沟填掉了一大半。
MLOps(机器学习运维)是覆盖模型部署、监控、版本管理和资源调度的工程实践体系。传统本地大模型部署需要运维人员熟悉CUDA驱动、容器编排、推理框架配置等底层细节,对没有专职算法运维团队的中小企业构成较高门槛。图形化运维平台将模型加载、Token统计、显存监控等操作封装为可视化界面,实质上是用产品化手段替代部分MLOps人力,使业务团队能够自行完成日常运维,这也是该方案可复制性的关键支撑。
本地部署的边界在哪里
这套方案并非万能。UP主提到可以向有兴趣的团队提供单流并发、preview版本表现和上下文长度等参考数据,说明性能指标高度依赖具体配置组合,不同业务负载下的吞吐差异会很大。推理优化能拉近与线上模型的差距,但拉平并不现实——云端大模型在峰值弹性、多模态扩展和持续迭代上仍有结构性优势。
更务实的判断是:把本地部署定位为「数据敏感型任务的专用通道」,而非全面替代云端。代码生成、内部知识问答、合规审查这类场景优先本地化,通用问答和创意类任务继续走API,混合架构往往比二选一更经济。
量化策略是影响本地推理性能与精度的核心变量。常见量化方法包括GPTQ、AWQ和GGUF等,通过将模型权重从FP16压缩至INT8或INT4来降低显存占用、提升吞吐,但会引入不同程度的精度损失。代码生成任务对 token 级精确性敏感,量化后的模型可能在复杂逻辑补全上出现退化,因此部署方通常需要针对具体任务做回归测试,并在并发数、上下文长度和量化等级之间做权衡。这也解释了为何同一模型在不同配置下的表现差异显著。
常见问题
Q:跑DeepSeek V4.1 Flash 1017至少需要什么硬件? A:该案例采用双T5000推理节点加一台微服管理节点,具体显存与并发能力需结合实际量化方案评估,建议向部署方索取单流并发与上下文长度数据。
Q:本地部署后模型性能会打折扣吗? A:经过推理优化后可接近线上模型水平,但量化会带来一定精度损失,代码生成等任务建议做针对性回归测试。
Q:没有运维团队能维护吗? A:图形化界面覆盖了模型状态、Token统计和内存监控,日常运维压力显著低于纯命令行方案,但仍需基本的环境维护能力。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。