DeepSeek V4.1 Flash 1017拆解:跑分赢了,但代价是什么?

DeepSeek V4.1 Flash小版本更新跑分有限提升,赢在输出变短,但稳定性与总成本隐忧仍在。
DeepSeek V4.1 Flash 1017于10月17日上线,距上一版仅37天,官方称“小版本更新”又强调“大幅提升”。文章基于B站UP主逐项对账视频、官方模型卡与第三方评测,还原更完整图景:架构未变,仍是5520亿参数MoE、激活80亿、上下文100万token;官方11项基准有进步,但对比的是GPT-5.6和OPUS-5旧版本,未纳入最新竞品,且与OPUS-5相比赢4输7、偏科明显。第三方实测显示主要赢在输出变短,数学题输出中位数降33%,正确率无明显变化,推理档位控制也更灵敏。定价未变,但Agent任务的重试与多轮调用可能吃掉单价优势。发布前5小时服务中断暴露稳定性短板,而这一维度不在跑分表中。文章最后给出三类用户决策参考。
DeepSeek V4.1 Flash 1017(内部代号)在10月17日上线,距离上一次更新仅37天。官方称之为“小版本更新”,却又在同一段话里强调“大幅提升”——这种措辞上的矛盾,恰好概括了这次更新的微妙之处:它确实变强了,但强得有限,且伴随一些不容忽视的隐性成本。
本文基于B站UP主“测试的好兄弟”的逐项对账视频,结合官方模型卡、第三方独立评测和社区讨论,尝试还原一个更完整的图景。
架构未变,参数依旧:一次“帕累托改进”式的迭代
先补背景:V4.1 Flash 1017没有更换模型结构,仍是5520亿参数的混合专家(MoE)架构,激活参数80亿,输出侧160亿,上下文窗口100万token,最大输出38.4万token。上一版发布于9月10日,间隔37天。
官方将这次升级定义为“性能利用的帕累托改进”——这个经济学词汇落到模型上,意思是“没人变亏,有人变好”:要么同样的成本办更多事,要么同样的事花更少的钱。
从官方公布的11项基准来看,确实有进步:终端操作测试4.0版从31.2提升到42.3,深度软件工程测试1.1版从74.2提升到77.0,自动化测试达到60.5,智能体终极考试(Agent终极考试)为35.4。
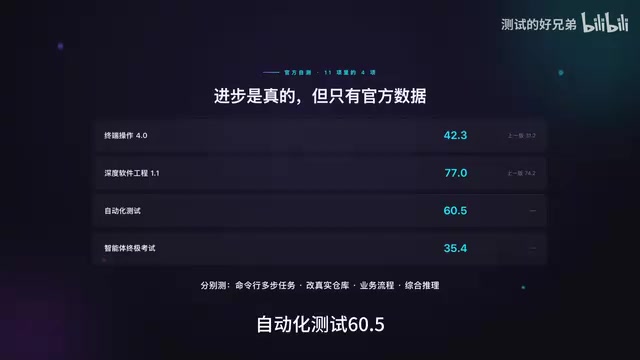
但这里有一个关键细节:官方对比表里的对手是GPT-5.6和OPUS-5,而这两家分别在9月22日和9月29日发布了OPUS-5.5和GPT-6.1,均未进入对比表。赢的是“上一届冠军”,含金量需要打折。
与OPUS-5的对比更能说明问题:11项中赢4项输7项,人类最后考试42.6对56.3,终端操作42.3对51.8——偏科明显,在智能体与终端任务上更强,但在高难度综合推理上仍有差距。
混合专家(MoE)架构的核心思想是“分而治之”:模型由多个专家子网络和一个门控网络组成,每次输入只激活其中少数专家,而非全部参数。这样总参数量可以做得很大(如本文的5520亿),但单次推理的计算量和显存占用只与激活参数(80亿)相关,从而在效果和成本之间取得平衡。DeepSeek广告系列长期采用这一路线,这也是其能以较低单价提供大模型服务的关键。需要留意的是,MoE模型的“总参数”和“激活参数”是两个不同概念,宣传中的参数量往往指前者,实际推理开销更接近后者。
上下文窗口指模型单次能“看到”的token总量,100万token约相当于70万至80万汉字,足以容纳整本长篇小说或大型代码仓库。窗口越大,模型越能处理长文档、多轮工具调用和长程任务,但也会推高推理时的显存与注意力计算成本。最大输出38.4万token则限制了单次回答或单步任务的生成长度,对Agent场景尤为重要。
第三方实测:赢在“变短”,而非“变准”
发布不到一天,第三方数据很少,但有一家推理服务团队做了件“笨事”:同一套题、同一个采样、同一块卡,只换模型,跑了1444个请求先测自己的噪声底。
结论很有意思:这版主要赢在输出变短。数学竞赛题输出中位数从1681个token降到1124个,最长推理链从3814降到1880,而正确率没有明显变化。样本不大(每套10道题),作者自己标注了±1的误差,方向可信,但分值别当定论。
另一个细节:推理档位以前基本是摆设,调到最低照样吐近2000个token;这版最低档790个token,少了60%,题还能做对。官方所说的“任务运行时间缩短”,在输出变短这一点上得到了第三方佐证,但运行时间本身尚无公开数据。
翻译一下:这版模型是不是“学会闭嘴了”?至少方向上是的。
推理档位(或称思考预算、reasoning effort)是让模型在回答前进行不同长度内部推理的可调参数。档位越高,模型生成的中间推理token越多,通常准确率略高但延迟和费用也更高;档位越低则相反。文章提到旧版模型即便调到最低档仍会输出近2000个token,说明其档位控制并不灵敏,存在“过度思考”问题。新版最低档降至790个token且仍能答对,意味着模型对推理长度的可控性增强,这对批量调用和成本敏感型应用是实质性改进,但第三方样本有限,仍需在自有任务上验证档位与准确率的实际取舍。
成本账:单价便宜,不等于总花费低
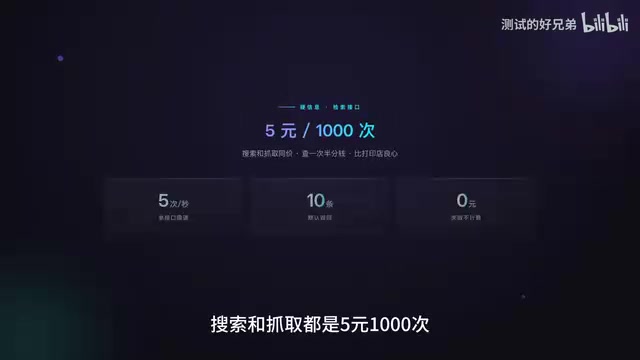
官方定价没变:输出8元/百万token,闲时半价(凌晨2点时段),权重开源允许商用。搜索和抓取接口5元/1000次,查一次半分钱,只有成功才计费,单接口每秒5次,默认返回10条。对做Agent的人来说,这个检索接口可能比模型本身更实用——检索成本终于能算进预算。
但单价便宜和总花费低是两回事。Agent任务尤其如此:重试和反攻都算钱,输出变短省下的token,可能被多轮工具调用吃掉。就像打车起步价降了,司机带你绕半座城,账单反而更高。
官方给的费用对比图显示,新模型最高点在77%位置,花费2块多;OPUS-5接近100块,70%左右。坐标轴是自家订的,量级可参考,比例别太当真。
Agent任务中的重试与反攻成本值得展开。智能体通常需要多轮“思考—调用工具—观察结果—再思考”的循环,任何一步失败都可能触发重试,而重试会重新消耗输入和输出token。若模型输出变短但工具调用轮次增加,总token消耗未必下降;若因稳定性问题中断,已完成的中间步骤作废,成本更会成倍上升。因此在评估单价时,应把“每完成任务的总token消耗”和“失败重试率”纳入计算,而非只看每百万token的标价。闲时半价对可延迟的批处理任务有效,但对实时交互型Agent帮助有限。
被跑分表忽略的成本:稳定性
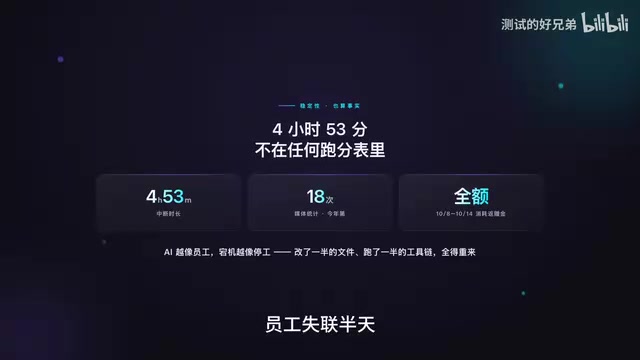
10月15日早上8点11分,DeepSeek服务中断,下午1点04分恢复,近5小时。官方状态页和多家媒体均有记录。官方回应称“全面排查,剥离单点依赖”,并针对10月8日至14日的消耗额度返还赠金。有媒体统计,这至少是今年第18次中断(官方未确认)。
有人形容得挺准:AI越像员工,当机就越像停工。员工失联半天,改了一半的文件、跑了一半的工具链全得重来。
海外社区当天开了两个帖子,夸的骂的都不少。有人说前端和编码更顺,也有人在代码审查里测出它比GPT-5.6差不少。同一个模型,有人当宝有人当草——这些都不是受控实验,只能当线索。
基准跑分与生产可用性之间存在系统性偏差。公开基准通常在固定数据集、单次调用、无中断的理想条件下测得,衡量的是模型峰值能力;而生产环境关注的是长时间在线、高并发下的成功率、延迟分布和故障恢复能力。服务中断、限流、超时等问题不会体现在跑分中,却直接决定用户体验和业务损失。对依赖模型输出的工作流而言,一次数小时的中断可能导致半成品文件、未完成的任务链和额外的人工修复成本。因此选型时应同时考察服务商的状态页历史、SLA承诺和故障补偿机制,把稳定性当作与准确率同等重要的指标。
谁该升级?三类人的决策参考
自己玩、写小工具:直接用,跑分进步是真实的,成本也低。
从旧版迁移:换,但先跑自己的评测集。重点测断线重连能不能扛住,推理档位准不准。生产环境尽量放到空闲时段跑,闲时半价能省一半。
自己部署:权重是开的,但5520亿参数,家用显卡想想就好。
一个模型值不值得用,看它出问题的时候你损失多少,而不是峰值时能刷多高。便宜能帮你省钱,稳定才能帮你赚钱——而稳定这一项,从来不在跑分表里。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。