DeepSeek V4.1 Flash 1017发布:11项基准4项第一

DeepSeek V4.1 Flash 1017发布,11项基准4项第一,主推长程Agent能力。
DeepSeek V4.1 Flash 1017 发布,官方称其在 11 项基准测试中取得 4 项第一,并对上一代模型的 11 项指标实现全面超越。对比对象指向 Kimi K3、GLM 5.3 与海外的 Cloud Opus 5,发布方称在代码与 Agent 任务上领先前两者,长程任务则超过 Cloud Opus 5。能力描述集中在三个方向:更长的人物链、更稳的工具调用、更强的多模态,其中多模态信息最为有限。产品定位被概括为「一句话抵达终点」,即用户给出目标、模型负责拆解执行与交付的 Agent 交互范式。文章提醒,上述数据均为发布方自述且无第三方复现,基准排名受测试选取与评分口径影响,建议在正式采用前用自身典型任务做小规模对照测试。
DeepSeek V4.1 Flash 1017发布:11项基准4项第一
DeepSeek广告 V4.1 Flash 1017 的发布视频,用一种近乎调侃的方式开场:「写代码也能许愿的话,键盘就该退休了。」这句宣传语背后,是一个明确的产品信号——模型正在从「辅助写代码」向「一句话抵达终点」的交付形态演进。
核心数据:11项基准,4项第一
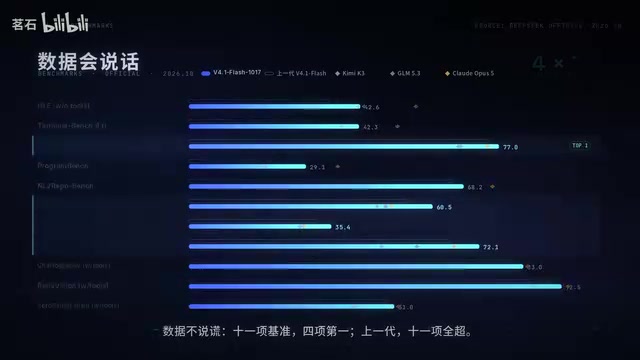
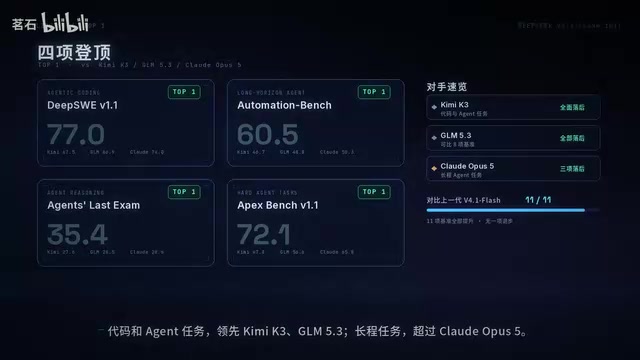
根据发布方公布的数据,DeepSeek V4.1 Flash 1017 在 11 项基准测试中取得 4 项第一,并且对上一代模型的 11 项指标实现全面超越。这是一个覆盖面较广的提升,而不是单点突破。
对比对象直接指向当前竞争最激烈的几个名字:Kimi K3、GLM 5.3,以及海外的 Cloud Opus 5。发布方称,在代码和 Agent 任务上领先前两者,而在长程任务上超过 Cloud Opus 5。
需要说明的是,这些数据来自发布方自述,目前尚无第三方独立复现结果。基准测试的选取、提示词设计和评分口径都会显著影响排名,读者在引用这些数字时宜保留一份审慎。
基准测试(Benchmark)是模型能力评估的通用手段,典型代表包括评估代码生成的 HumanEval、SWE-bench,评估综合知识的 MMLU,以及评估数学推理的 GSM8K、MATH 等。不同基准考察的能力维度差异很大,把多项基准的得分汇总成「11项中4项第一」是一种压缩式表达,会掩盖单项之间的强弱分布。此外,基准得分高度依赖提示词模板(prompt template)、few-shot 示例数量、是否允许使用工具、以及采样温度等参数设置,业界常见的做法是同时报告 pass@1 与 pass@k 等不同口径。因此横向对比不同厂商的榜单成绩时,只有在评测协议一致的前提下才具备可比性,这也是第三方独立评测(如 LMSYS Chatbot Arena、各机构自建的私有测试集)受到重视的原因。
三个能力方向:长链路、工具调用、多模态
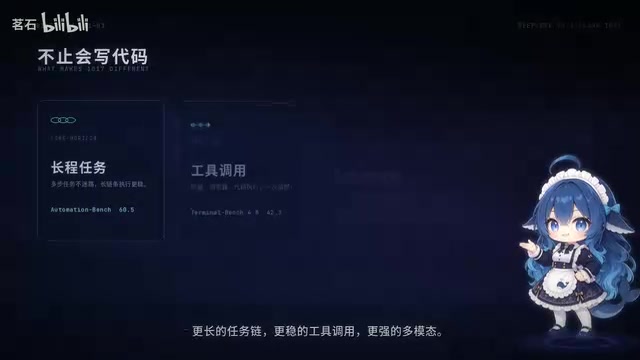
比排名更值得关注的是能力描述的具体化。发布内容提到三个方向:更长的人物链、更稳的工具调用、更强的多模态。
「更长的人物链」指向长程任务中的上下文保持能力。Agent 场景的典型失败模式,是任务进行到中后段时遗忘早期约束或丢失中间状态。链条能拉多长,直接决定模型能否独立完成多步骤工程任务。
「更稳的工具调用」则是 Agent 落地的关键。工具调用的稳定性不只是成功率,还包括参数格式正确率、失败后的重试逻辑、以及对模糊指令的容错。发布方用「稳」而非「强」来描述,某种程度上比宣称能力上限更有信息量。
多模态被列为第三支柱,但发布内容没有给出具体基准或场景说明,信息相对有限。
工具调用(Tool Use / Function Calling)指模型在推理过程中输出结构化的调用请求,由外部运行时执行后将结果回传给模型继续推理。其技术基础是模型经过专门训练后能按 JSON Schema 生成函数名与参数,业界通用规范包括 OpenAI 的 function calling 格式与 MCP(Model Context Protocol)等。评估工具调用不能只看「是否调对」,还要看参数类型与枚举值是否正确、多工具串联时依赖顺序是否合理、调用失败后能否依据错误信息修正重试。Agent 场景中一次任务的工具调用往往多达数十次,单次 95% 的正确率经过多步串联后会显著衰减,这正是「稳」比「强」更贴近生产需求的原因。
与 Cloud Opus 5 的对比意味着什么
把 Cloud Opus 5 作为长程任务的参照系,是一个有指向性的选择。长程任务能力通常与模型的规划能力、状态管理和错误恢复机制相关,也是当前 Agent 产品体验差异的主要来源。
如果「长程任务超过 Cloud Opus 5」这一说法能在实际使用中成立,那么它在自动化 coding agent、多步骤数据分析、复杂工作流编排等场景中会有直接价值。但这些场景的验证周期较长,单次基准得分并不能完全代表真实生产环境下的表现。
长程任务(Long-horizon Task)指需要数十乃至上百步操作、跨越较长上下文才能完成的任务,例如在大型代码库中定位并修复一个跨模块缺陷,或完成多阶段的数据清洗与分析流程。这类任务的核心难点在于状态管理:模型必须在上下文中持续维护已完成的步骤、尚未满足的约束和中间产物,而随着对话变长,早期信息会被稀释甚至被挤出上下文窗口。常见的缓解手段包括上下文压缩、外部记忆(把中间结果写入文件或数据库)、子任务分解与显式计划(plan-and-execute)。长程能力也因此与错误恢复机制强相关——模型需要能识别自身某一步出错并回退重来,而不是沿着错误路径一路推进。
「一句话抵达终点」的产品含义
发布语中反复出现的一个意象是「一句话抵达终点」。它描述的是一种交互范式的迁移:用户给出目标,模型负责拆解、执行和交付,中间过程对用户透明。
这对模型的要求是全方位的——不仅要会写代码,还要会规划、会调用工具、会在出错时自我纠正。从发布方强调的三个能力方向看,V4.1 Flash 1017 的定位正是朝这个方向推进。
不过,从「一句话」到「抵达终点」之间的实际落差,取决于模型在边缘情况下的鲁棒性。演示视频里的顺畅流程与真实项目中的反复调试,往往是两回事。
理性看待「登顶」叙事
国产模型在基准榜单上的竞争已经进入白热化阶段,「登顶」「最强」这类表述在发布节奏中几乎成为标配。对开发者和企业用户而言,更有参考价值的是具体场景下的实测表现:在你的代码库上、你的工具链里、你的任务复杂度下,它是否稳定可用。
DeepSeek V4.1 Flash 1017 给出的数据提供了一个值得验证的起点,但基准第一和实际好用之间,仍然隔着大量工程细节。建议在正式采用前,用自己的典型任务做一轮小规模对照测试。
在模型选型实践中,业界通常区分「公开基准」与「私有评测集」两类证据。公开基准便于横向比较,但存在训练数据污染(benchmark contamination)的风险,即测试题目可能已出现在预训练语料中,导致分数虚高;私有评测集则用企业自身的真实任务构建,更能反映落地效果。一个可操作的做法是:从自己的业务日志中抽取 50 至 200 条典型任务,固定提示词与评分标准,对新旧模型做盲测对照,同时记录成功率、平均耗时与单任务成本。这种小规模 A/B 测试的成本远低于全面切换,却能有效降低被榜单叙事误导的风险。
相关推荐

AgentCore 实战:为智能体接入自定义工具与 MCP 服务器
DebuggerCafe 教程演示如何为 Amazon Bedrock AgentCore 智能体接入自定义工具与 MCP 服务器,突破默认工具集限制,并分析工具契约设计、MCP 复用价值及扩展后的工程注意事项。

816B参数只拿39分?开源大模型参数竞赛的性价比真相
Meta 816B Muse Spark Open 在 Artificial Analysis 仅得39分,180B Qwen3.8-Flash-Next 却拿到40分。本文解析11个开源权重模型的参数与分数关系,探讨激活参数、量化体积与部署成本的真实影响。

空中机械臂:无人机从「看」到「改」的下一步
从Reddit讨论出发,分析空中机械臂(Aerial Manipulator)的技术难点、潜在应用场景与落地瓶颈,探讨无人机从环境感知走向物理操作的关键挑战。