DeepSeek V4.1 Flash 1017实测:Token效率补齐最大短板

DeepSeek V4.1 Flash 1017 版大幅提升 token 效率,长程 agent 性价比突出,但前端视觉还原仍逊于前沿。
DeepSeek 发布 V4.1 Flash 的 1017 版本,官方称“小更新”,但实测显示其核心改进是 token 效率:同等单价下编程任务成本从约 50 美分降至 20 美分,high 档推理 token 减少约三分之一,准确率反而上升。Terminal Bench 从 31 升至 42,Arena Web Dev 成为第一开源模型。长程 agent 任务表现亮眼:纯数学 SDF 生成 3D 龙、50 万恒星双星系碰撞模拟、从零手写 PPO 教机器狗行走(46 秒起步,26 分钟近 6 米/秒),全流程仅 22 美分。多模态支持图像输入但不支持视频,复杂前端页面重建仍落后 Gemini Argon。建议默认 high 档,长程开放式构建切 max,并升级 DeepSeek harness 至 0.2.1。
DeepSeek 发布 V4.1 Flash 的 1017 版本,官方口径是"小更新",但基准测试和周末实测给出的信号要强得多。最值得关注的不是分数涨了多少,而是它完成任务所消耗的 token 明显变少了——这恰好是 DeepSeek Flash 系列长期被诟病的地方。
从"单价便宜"到"任务便宜"
模型定价页上的数字是按 token 计的价格,但实际支出是单价乘以模型为完成任务生成的 token 总量。一个单价打五折、思考量翻三倍的模型,最终账单可能更贵。这正是 DeepSeek广告 Flash 之前的问题:费率低,但耗 token 多。
据 artificial analysis 在去年四月对 V4 Flash 的测试,它是当时测试过的最耗 token 的模型之一;九月的 V4.1 Flash 更啰嗦,跑同一基准的 token 消耗接近同规模开源模型的兩倍。低价被"想得多"悄悄吃掉了。
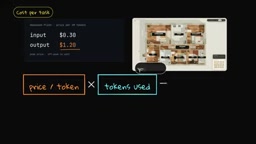
1017 版本的关键变化就在这里:DeepSeek 自己的图表显示,同等单价下编程任务在 max 档的成本从约 50 美分降到约 20 美分。这个降幅只有在生成 token 大幅减少时才可能出现。
Token 消耗为何成为性价比关键
大模型 API 通常按输入和输出 token 分别计价,而推理模型在生成最终答案前还会产生大量不可见的“思考 token”,这些同样计费。对于需要多步推理或长程任务,思考 token 可能数倍于可见输出,因此“单价便宜”不等于“任务便宜”。业界常用“每任务成本”(cost per task)衡量真实开销,即完成一个标准任务(如编程题、网页生成)的总费用。DeepSeek Flash 系列此前因过度思考导致 token 消耗偏高,削弱了低价优势;1017 版本通过减少冗余思考 token,使同等任务的总成本显著下降,这正是其性价比提升的核心机制。
基准与真实测试:不只是纸面数字
模型规模与九月版完全一致,但权重明显不同。DeepSeek 称进一步训练让所有基准都有提升,其中 Terminal Bench 从 31 涨到 42——对一个自称"小更新"的版本来说相当可观。按其自家数据,它已能对标 GPT 5.6 Sol(并非 OpenAI 最新型号),而价格只是零头。在 Arena 的 Web Dev 排行榜上,它成为排名第一的开源模型,仅落后 Gemini 版 Argon 八分。
我重跑了九月版用过的同一批 prompt 与设置:high 档推理 token 减少约三分之一,max 档降幅更大,同时准确率反而上升,带视觉能力的物体检测项目提升尤其明显。一个有趣的细节是,我在官方公告前就跑完了测试,API 里的模型名和响应指纹都没变,但背后的模型显然已经换了。
长程 Agent 任务:从 3D 龙到会跑的机器狗
我把一周前交给 Gemini 版 Argon 的同一批长程任务,全部丢进 DeepSeek harness 无人值守运行。每个任务是一个目标,agent 持续工作、用截图自查输出,自认为完成后才停。
第一个是图形研究者 Kenan Crane 在另一个前沿模型上跑过的 3D 测试:用有符号距离函数(SDF)纯数学描述每个形体,不借助 Blender 或任何 3D 软件,造一条龙。给 DeepSeek 同样的两条 prompt 和参考图,最终渲染里每一片鳞、角、眼睛都是单个 shader 文件里的数学函数。
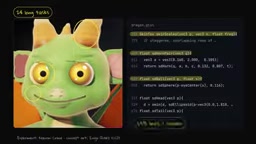
接下来是三个开放式 3D 世界:程序化星球、传送门物理实验室、带真实齿轮传动的机械表。每个都是它自己写的单页网页,自己在浏览器里测试并持续改进约一小时。对可自托管的开源模型来说,这个结果相当能打。
更有说服力的是真 GPU 实验。我给它 DGX Spark 的访问权限,第一个任务是超过 50 万颗恒星的双星系碰撞模拟:它自己写模拟、检查总能量近似守恒、再渲染完整并合过程。第一次运行时 Spark 直接卡死,因为三个重任务在同时跑——这是我自己的配置问题,但模型并未主动指出这一点。
最惊艳的是开头那只机器狗:要求从零手写 PPO 强化学习算法、禁止使用任何 RL 库,教四足机器蚂蚁走路。训练 46 秒后它就开始前进,不到两分钟达到目标分数,26 分钟后奔跑速度接近 6 米/秒。写代码、训练、渲染视频、生成结果页,整个任务花了约 22 美分。
SDF 与 PPO 的技术背景
有符号距离函数(SDF)是一种用数学表达式描述三维形体的方法:对空间中任意一点,函数返回该点到形体表面的最短距离,符号表示点在内部还是外部。通过组合球体、圆柱、圆环等基本 SDF 并做布尔运算,可以纯代码构建复杂模型,无需传统多边形网格。这要求模型具备较强的数学抽象与空间推理能力。
近端策略优化(PPO)是强化学习中的经典算法,通过约束策略更新幅度来稳定训练。让模型从零手写 PPO 并训练四足机器人行走,考验的是其对强化学习原理、奖励设计、超参数调节和并行环境模拟的综合掌握,而非简单调用现成库。
多模态与前端:聪明,但不是前沿
模型原生支持图像输入,不支持视频,agent 需要自己抽帧来看。
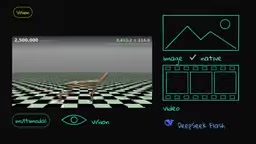
第一项视觉测试是一张缺了两个房间尺寸的户型图,要求生成完整 3D 漫游。它从图纸其余部分反推出缺失尺寸,做出了娃娃屋视图、俯视平面图和自动导览的行走模式。第二项是 20 秒的双摆混沌运动视频,要求建立并排对照的仿真。它追踪两条摆臂上的光点跨越全部 500 帧,再拟合物理参数,然后让仿真完全自主运行——前几秒吻合,之后逐渐漂移,这正是真实混沌系统该有的样子。作为对比,上周测试的 Gemini 版 Argon 是从视频里量出摆角,再用一根隐藏弹簧把仿真拉回目标区域。
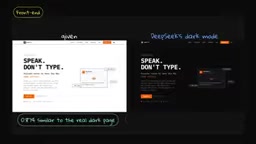
前端是差距显现的地方。对简单的落地页,它重建得几乎像素级一致;但对 NASA 首页这类复杂页面,始终略逊于 Argon——尽管 Arena 上人类投票几乎同样喜欢它的设计。Argon 的视觉还原能力明显更强。给页面做暗色模式时它表现亮眼,页面里的照片全是它手写 SVG 画出来的,NASA 页面上的降落伞就是上千行手写矢量代码。
视觉还原与设计偏好的区别
前端页面重建涉及两个维度:视觉保真度(像素级还原布局、颜色、字体、图像)和设计合理性(人类主观偏好)。Arena Web Dev 排行榜基于人类 pairwise 投票,反映的是后者;而复杂页面(如 NASA 首页)的精确重建则依赖前者。DeepSeek 1017 在设计偏好上接近前沿模型,但视觉还原仍逊于 Gemini Argon,说明其多模态理解在细粒度空间定位和样式复现上存在差距。模型手写 SVG 生成图像,则展示了其将视觉元素转化为矢量代码的代码生成能力。
推理档位怎么选
模型有 low、high、max 三档。我把 20 个任务在 high 上重跑以对比 max:max 多生成约 16% 的 token,推理任务的总耗时几乎相同;推理题和网页重建上 max 没有可测差别,high 已经够完美;但长程开放式构建中,max 完成了 high 超时的户型图,3D 世界也明显更丰富。我的建议很简单:默认 high,只在需要反复打磨的长程开放式构建里切到 max。
另一个实操提醒:DeepSeek 表示模型是在 DeepSeek harness 内训练的,建议升级到最新版(录制时为 0.2.1)。我用旧版测试时没看到明显差异,但值得留意。
推理档位(reasoning effort)的作用
推理档位控制模型在生成答案前允许消耗的思考 token 上限。low 档倾向于快速响应,适合简单查询;high 档在准确率与成本间取得平衡;max 档允许更长的内部推理链,适合需要反复试错、自我修正的复杂任务。档位越高,模型越可能发现并纠正错误,但 token 消耗和延迟也相应增加。实测表明,对于有明确答案的推理题,high 档已足够;而对于开放式长程构建,max 档能完成 high 档超时的任务,并产出更丰富的细节。
结论
1017 版本真正的意义,是 DeepSeek 第一次同时做到"每 token 便宜"和"每任务便宜",token 效率的短板被补上了。它不是前沿模型,做前端精确还原时差距肉眼可见;但在长程 agent 任务这个区间、这个价格上,是我目前测过性价比最高的。价格战已经开打,连中国厂商都在用它互相施压。
相关推荐

Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战
Meta修改商业账户服务条款,允许用关联网站数据训练AI模型,引发出版商和创作者强烈反弹。媒体行业组织联名致信扎克伯格,Meta被迫删除"训练"措辞并推迟条款生效。这场争议揭示了AI时代数据授权与互联网未来的深层博弈。

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。