DeepSeek v4.1 Flash 成为最强安全测试模型?
有团队称DeepSeek v4.1 Flash是当前最佳安全攻防模型,但结论样本有限,需以基准数据审慎看待。
Hacker News上一则帖子声称DeepSeek v4.1 Flash在渗透测试、漏洞挖掘等安全攻防任务中表现优于其他大模型,成为该团队的首选"hacking model"。Flash版本以更低成本和更快速度见长,若能胜任高难度安全任务,对预算有限的安全团队具有明显吸引力。然而,该帖子热度有限,结论来自单一团队实践,缺乏大规模可复现的公开基准佐证,社区应保持审慎。此事更深层的意义在于,它印证了开源低成本模型正在特定垂直任务上快速逼近闭源旗舰的趋势,安全研究作为对推理与代码能力要求极高的领域,正成为衡量模型真实水平的重要试金石。与此同时,AI辅助安全工具的双刃剑属性不容忽视,合法授权与负责任披露是使用底线。
一条引发讨论的技术声明
近期在 Hacker News 上,一则名为「DeepSeek v4.1 Flash Is Now Our Best Hacking Model」的帖子引发了技术社区的关注。该帖主张 DeepSeek 的 v4.1 Flash 版本在渗透测试、漏洞挖掘等「安全攻防」类任务中,表现超越了此前使用的其他大模型,成为其团队眼中当前最佳的「hacking model」。
需要澄清的是,这里的「hacking」在专业语境下通常指代安全研究、渗透测试与红队演练等合法的攻防工作,而非恶意入侵。随着大模型能力持续增强,越来越多的安全团队开始尝试用 AI 辅助代码审计、漏洞复现和攻击链构建。
为什么安全领域开始青睐 DeepSeek
DeepSeek 系列模型近来在代码能力上的进步有目共睹。安全攻防任务对模型的要求相当苛刻:它既需要扎实的代码理解与生成能力,又需要能够进行多步推理、串联复杂的攻击逻辑,同时还得在面对晦涩的底层协议、内存操作时保持准确。
帖子作者将 v4.1 Flash 评为「best hacking model」,暗示这一版本在上述维度取得了平衡。Flash 类模型通常主打更快的响应速度与更低的推理成本,如果它能在保持效率的同时胜任高难度安全任务,对预算有限的安全团队而言吸引力不小。
成本与能力的权衡
在实际的安全研究工作流中,往往需要对大量代码、日志和二进制文件进行反复分析。使用顶级旗舰模型固然效果好,但高昂的 API 成本会迅速累积。Flash 版本若能以更低的单位成本提供接近旗舰的攻防能力,就意味着可以进行更大规模、更高频率的自动化扫描与测试。
Flash 系列模型在架构上通常通过减少参数量、采用蒸馏或量化技术来降低推理成本,与同家族的旗舰模型相比,推理延迟可压缩数倍,API 调用费用也往往只有旗舰版的十分之一甚至更低。在安全研究场景中,一次完整的漏洞挖掘流程可能涉及对数万行代码的逐函数分析、对数百个网络请求的逐条解析,乃至对二进制文件的反汇编片段进行多轮推理。在这种高吞吐量需求下,Flash 版本允许团队以固定预算内运行更多测试迭代,从而在广度上弥补单次推理可能存在的深度差距。
大模型在安全攻防领域的核心价值通常体现在几个典型任务上:其一是代码审计,模型需要理解跨文件的数据流和控制流,识别如缓冲区溢出、SQL 注入、反序列化漏洞等模式;其二是漏洞复现与利用链构建,需要将公开的 CVE 描述转化为可执行的概念验证代码;其三是模糊测试(Fuzzing)辅助,模型可根据协议格式生成高覆盖率的变异测试用例。这些任务对模型的上下文窗口长度、多步推理一致性以及对低级语言(C/C++、汇编)的理解深度均有较高要求,因此安全领域的评估结果往往比通用编程基准更能区分模型间的实际能力差异。
需要保持的审慎态度
该帖子在 Hacker News 上的热度有限(约 29 个赞、1 条评论),这意味着相关结论目前更多来自单一团队的实践观感,尚缺乏大规模、可复现的公开基准测试来佐证。
对于「哪个模型最擅长安全攻防」这类判断,社区历来存在分歧。不同的评估依赖于具体的任务集、提示工程方式以及团队的使用习惯。一款模型在某个团队的工作流中表现出色,未必能在通用场景下复现同样的效果。
合规与伦理边界
随着模型攻防能力增强,围绕 AI 辅助安全工具的双刃剑属性也值得警惕。同样的能力,用于授权渗透测试是提升防御的利器,用于未授权攻击则涉嫌违法。使用者需要确保所有测试都在合法授权范围内进行,并遵守相应的负责任披露原则。
「负责任披露」(Responsible Disclosure)是安全研究领域的核心规范之一,指研究人员在发现漏洞后,应在公开披露前给予受影响的厂商合理的修复时间窗口(通常为 90 天),以防止漏洞在被修复前遭到恶意利用。当 AI 工具大幅提升漏洞发现效率时,这一规范面临新的压力:自动化扫描可能同时发现大量漏洞,如何在批量协调披露与防止信息泄露之间取得平衡,成为安全社区正在讨论的新课题。此外,部分国家和地区对「渗透测试工具」的开发、持有与传播有明确的法律约束,使用 AI 辅助生成攻击代码时需额外确认本地法律框架。
对行业的启示
无论这一具体评价是否经得起更广泛验证,它折射出一个明确趋势:开源与低成本大模型正在快速逼近甚至在特定任务上追平闭源旗舰。安全研究作为对模型推理与代码能力要求极高的领域,正成为衡量模型真实水平的试金石之一。
对于关注 AI 能力演进的从业者来说,这类来自一线实践的反馈——即便样本有限——依然具有参考价值。它提示我们持续关注 DeepSeek 等模型在专业垂直任务上的进展,同时以基准数据而非单一断言作为最终判断依据。
相关推荐
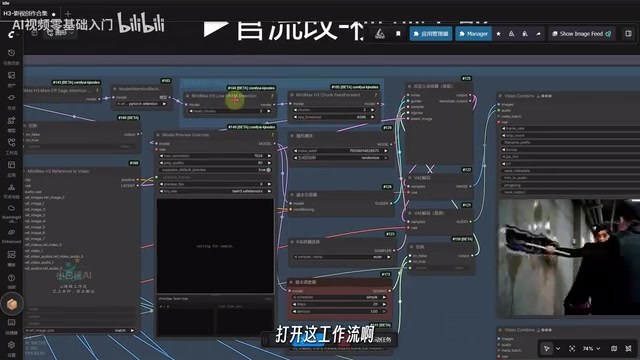
16GB显存跑27B大模型:Qwen3与MiniMax H3本地视频生成实测
实测16GB显存跑27B开源大模型:结合Qwen3与MiniMax H3的ComfyUI工作流集合,涵盖文生图、图像编辑与视频生成,8GB显存起步即可本地部署,媲美付费闭源方案。
MiniMax开源视频模型本地部署:8G显存也能跑,速度惊人
MiniMax最新开源AI视频加速模型支持8G显存本地运行,生成速度极快。本文详解ComfyUI本地部署流程、模型文件存放路径、五种工作流选择及文生视频、图生视频实测效果。
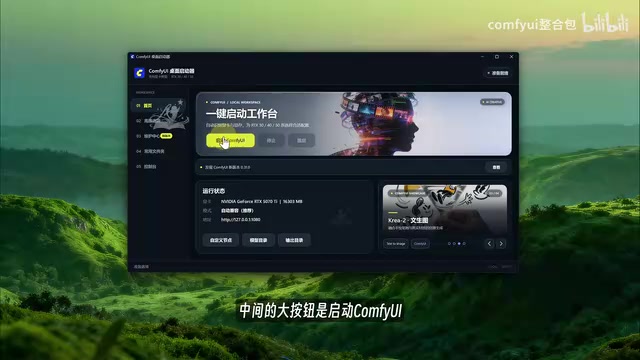
秋叶ComfyUI整合包实测:8G显存也能跑AI视频
秋叶ComfyUI中文整合包实测:解压即用、图形化启动器、显存四档自动匹配,8G显存也能跑AI视频。详解显存分档、依赖修复、下载源切换与插件管理等核心功能。