DeepSeek V4.1 Flash 迁移指南:避开 400 错误与静默换模

DeepSeek 静默换模到 1017 检查点,工程上要防 400、检测换模并控制高峰账单。
文章从工程视角拆解 DeepSeek 于 2026 年 10 月 17 日把 `deepseek-flash` 别名背后的检查点静默替换为 V4.1 Flash 1017 所带来的三类问题。显性故障是带 `tools` 的请求若丢失历史 assistant 消息的 `reasoning_content` 会返回 400,修复方式是追加完整的 assistant 消息对象。隐性变化是别名背后权重被换但无报错,输出长度、评测基线和行为路径都会漂移,应记录响应中的 `model` 字段并重跑回归集来识别。计费层面,工作日高峰时段价格翻倍,调度到非高峰、保持提示前缀稳定以提高缓存命中是主要省钱杠杆。此外文章还给出 effort 建议(保持 high)、max_tokens 与采样注意事项、shell 权限纪律,以及 Claude Code、Codex、DeepSeek Harness 三种协议的具体接入配置和一份 15 分钟冒烟测试。
DeepSeek 在 2026 年 10 月 17 日将 deepseek-flash 背后的检查点悄悄换成了 V4.1 Flash 1017,模型名和价格都没变。很多应用在那天下午“自动”完成了迁移,却没人做出迁移决定。话说回来,一个显性的坑在等着工具调用场景:只要请求里带 tools,而历史 assistant 消息丢了 reasoning_content 字段,API 就会返回 400。
这篇文章从工程角度拆解这次迁移:复现并修复 400、从响应里识别静默换模、看清高峰时段和 effort 设置如何影响账单,以及把 Claude Code、Codex 和 DeepSeek广告 Harness 接到新检查点上。
为什么迁移会失败:三个层面的问题
DeepSeek V4.1 Flash 1017 的迁移不是单一故障,而是三种性质不同的变化叠加。第一种是显性错误:工具循环中丢掉 reasoning_content 导致的 HTTP 400。第二种是隐性的:模型别名背后的检查点被替换,没有报错,但输出长度、评测基线和行为路径都可能改变。第三种是计费层面的:工作日高峰时段价格翻倍,而很多团队并未调整任务调度。
AIHubMix 在 10 月 19 日 03:02 UTC 对 deepseek-v4.1-flash-1017 做了一组冒烟测试,每个检查只跑一次。结果需要谨慎解读:在 Chat Completions 端点,effort 设为 low、high、max 均返回 200;工具第二轮不带 reasoning_content 的请求也返回了 200 和正常回答。但同一形状在 DeepSeek 自家 API 上正是公开报告里返回 400 的形态。由于响应不显示上游通道,这只能算一次观察,不是契约。
模型别名与检查点(checkpoint):在托管推理服务中,deepseek-flash 这类字符串只是对外的模型别名,真正回答请求的是服务端某个具体训练权重的快照,即检查点。别名机制让供应商可以在不改动客户端代码、不改变定价页的前提下替换后端权重,从而完成静默升级。这与“版本号写死在模型名里”的做法相反:后者迁移是显式的,客户端会读取到新的模型名;前者则把迁移决策从开发者手里收回到了供应商手里。工程上应对这种不透明性的通用手段,是把响应中返回的 model 字段、请求时间戳与评测结果一并入库,使后端权重的任何漂移都能在回归数据上显现出来。
失败一:工具调用后的 HTTP 400
症状与根因
症状很明确:发送工具结果的第二次请求失败,报错信息为 The reasoning_content in the thinking mode must be passed back to the API。这个错误在 V4 Pro 和 V4 Flash 时期就出现过,opencode、LangChain、claude-code-router 都有相关报告。
根因写在 DeepSeek 的 thinking mode 指南里:当请求包含 tools 时,之前每一轮 assistant 消息的 reasoning_content 都必须回传,即使那一轮模型没有执行工具调用。不回传,API 就返回 400。不带工具时,回传是可选的且会被忽略。客户端踩坑是因为消息序列化器只保留 content 和 tool_calls,把额外字段丢掉了。
reasoning_content 与 thinking mode:在 DeepSeek 的思考模式下,模型在给出最终回答前会先生成一段推理过程,这段内容不与普通 content 混在一起,而是单独放在 reasoning_content 字段中。它既是给用户看的解释,也是模型在多轮工具循环中维持推理状态的上下文。因此当请求携带 tools 时,API 要求把历史 assistant 消息连同该字段原样回传,否则第二轮请求缺少上一轮的思考轨迹,服务端会判定上下文不完整而返回 400。多数客户端 SDK 或自研序列化器只认识 content 与 tool_calls 这两个 OpenAI 标准字段,遇到非标准扩展字段时会直接丢弃,这正是该错误在 opencode、LangChain、claude-code-router 等项目中反复出现的结构性原因。
修复方式
最稳妥的做法是追加完整的 assistant 消息对象,而不是手工拼一个副本。在 Python 里就是 messages.append(resp.choices[0].message),它自带 content、reasoning_content 和 tool_calls。框架层面,opencode 在后续版本修复了往返序列化,opencodex 于 10 月 16 日合并了修复。最后手段是设置 {"thinking": {"type": "disabled"}} 关闭思考模式,但这等于放弃了让模型擅长 agent 工作的推理能力,不建议作为常规方案。
失败二:没有报错,但模型换了
DeepSeek 10 月 17 日的更新日志原话是:API 调用方式和定价不变,继续使用 deepseek-flash 即可访问最新模型。问题在于,九月检查点没有留下 pinned 名称,而 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 这两个旧名字现在也都跑在 1017 上。
不会抛异常,但有三样东西会在测试脚下移动。输出长度:1017 被训练为产生更短的输出,期待九月模型长篇解释的解析器、UI 布局和提示词可能拿到更少文本,DeepSeek 没有给出缩短比例。评测基线:九月检查点上的分数和成本不再描述 deepseek-flash 的返回结果。行为:1017 针对端到端项目工作重新训练,agent 可能走不同路径到达同一结果。
如何检测换模
响应本身会告诉你哪个检查点在回答。在 AIHubMix 的测试里,每个响应都带有 "model": "deepseek-v4-1-flash-261017"。把响应中的 model 字段和日期与每次评测一起存储,立即重跑回归集,未宣布的换模就能在发生当天暴露。
缓存命中与提示前缀(prompt prefix caching):DeepSeek 的输入计费区分“缓存命中”与“缓存未命中”,前者价格约为后者的五十分之一。缓存能否命中取决于请求开头部分是否与上一次请求逐 token 一致:供应商会把公共前缀对应的 KV 状态缓存起来,后续请求若共享同一前缀即可复用,跳过重复计算。在 agent 场景中,系统提示、工具定义与历史对话天然占据请求前部,因此把稳定的内容放在最前面、把每轮变化的部分(如新的工具结果、用户输入)放在末尾,可以显著提高命中率。反之,若在系统提示里插入时间戳、随机 ID 或频繁变动的配置,缓存会整体失效,成本回到未命中的价位。
失败三:工作日高峰账单翻倍
DeepSeek 在工作日 01:00–04:00 和 06:00–10:00 UTC 收取全价,其余时段、整个周末和中国法定节假日半价。AIHubMix 使用相同窗口,并按请求提交时间计价,因此一个从非高峰开始的长流式请求全程保持非高峰费率。
以 100 万 token 计价,输入缓存未命中的高峰价为 $0.3098、非高峰 $0.155;缓存命中高峰 $0.0062、非高峰 $0.0031;输出高峰 $1.2392、非高峰 $0.62。一个包含 40 次调用、120 万输入 token(90% 缓存命中)和 6 万输出 token 的 agent 会话,高峰成本 $0.118,非高峰 $0.059。
三个杠杆能改变这个数字。调度:把批处理移到非高峰是最大的单项节省。缓存:命中比未命中便宜约 50 倍,agent 每次调用都重发相同的系统提示、工具定义和历史,保持前缀稳定、把每次变化的内容放在末尾。思考:默认开启,推理 token 同时计入账单和 max_tokens。
另有一个日期需要标记:DeepSeek 于 10 月 17 日开放 Search 和 Fetch API,各按每 1000 次成功调用 $0.75 收费。通过 DeepSeek Harness、Claude Code 或 Codex 在 DeepSeek API 上发起的服务端调用,在 2026 年 10 月 31 日 16:00 UTC 前免费。此后,每轮都搜索的 agent 将在 token 成本之上叠加按次费用。
失败四:代价高于回报的设置
Effort 层级
API 提供 low、high(默认)和 max。DeepSeek 的 V4.1 Flash 论文将它们映射为内部 effort 值 50、75 和 100,并报告从 high 到 max “将 agent 轨迹拉长 1.6–1.8 倍,却只带来边际提升”。有意思的是,DeepSeek 自己的 Claude Code 设置指南仍然设置 CLAUDE_CODE_EFFORT_LEVEL=max。对日常 agent 工作,high 是更好的默认值。
其他 effort 名称会被折叠:minimal 变成 low,medium 和 xhigh 都变成 high。一个提供五档的工具实际只给你两到三档。
max_tokens 与采样
模型卡建议长 agent 运行至少 256K,因为思考与输出共享预算。上限太小时,困难步骤可能把全部预算花在思考上,应对 finish_reason: "length" 设置告警。在思考模式下,temperature、presence_penalty 和 frequency_penalty 被接受但没有效果,top_p 被钳制在 0.95–1.0。依赖低温度获得确定性输出的流水线不再得到那个保证。
给 shell 权限之前
1017 在完整项目上做过强化学习训练,倾向于一直构建到任务看起来完成为止。它的回答也更短,意味着对所做更改的叙述更少。两条纪律:审查 diff 和命令日志,而不是模型对它们的总结;在带有命令允许列表的沙箱中运行,对删除、强制推送、迁移、外部网络调用等破坏性操作要求人工审批。DeepSeek 自己强调 Flash 系列在安全任务上的强度,九月检查点在其表格中 CyberGym 得分为 88.1。这对防御性工作有用,也是收紧权限范围的另一个理由。
接入编码工具
AIHubMix 在三种协议上提供 deepseek-v4.1-flash-1017:Claude Code 使用 Anthropic Messages,Codex 使用 Responses API,DeepSeek Harness 使用 Chat Completions。
Claude Code 需要设置 ANTHROPIC_BASE_URL 为 https://aihubmix.com,ANTHROPIC_AUTH_TOKEN 为你的 key,ANTHROPIC_MODEL、ANTHROPIC_DEFAULT_HAIKU_MODEL 和 CLAUDE_CODE_SUBAGENT_MODEL 都指向 deepseek-v4.1-flash-1017,并把 CLAUDE_CODE_EFFORT_LEVEL 设为 high。测试中发现,没有 effort 设置的 Messages 请求不返回 thinking 块,而设置了 output_config.effort 的请求会返回 thinking。DeepSeek 指南中给模型名加的 [1m] 后缀在 AIHubMix 上未测试。部分路由器下 Claude Code 曾丢弃 thinking 内容并触发上述 400,但 AIHubMix 的 Messages 端点两轮工具测试未遇到。
Codex 按指南配置 aihubmix provider,base_url 为 https://aihubmix.com/v1,wire_api 为 responses,模型设为 deepseek-v4.1-flash-1017。要在 /model 里选到它,需加入 model_catalog_json 文件并把 context_window 设为 1,000,000。注意 Codex 的目录脚本提供 low、medium、high 三档,按 DeepSeek 映射后 medium 和 high 都落到 high,实际只有两档。
DeepSeek Harness 建议使用 0.2.1-rc.1 或更高版本,将 AIHubMix 作为 OpenAI 兼容 provider 加入,再添加模型 ID。现有 AIHubMix 指南写于较早版本,字段名可能已经变化。
15 分钟冒烟测试
建一个含失败测试的小仓库:stats.py 里 mean 函数对空列表会除零,测试文件断言 mean([]) == 0。启动工具后要求:“运行 pytest,只改 stats.py 修复失败测试,再运行 pytest。” 通过的判据是:agent 至少发起两次工具调用(跑测试、改文件)且无 400;两个测试最终通过;AIHubMix 请求日志显示 deepseek-v4.1-flash-1017,会话成本最多几美分。
这次测试没有告诉你的
被剥离字段的工具轮返回 200:只有一次请求,上游通道不可见,DeepSeek 的规则仍然有效,该字段还是要发。Effort 成本:effort 检查用了极简提示,推理 token 数(low、high、max 分别为 68、39、54)无法区分层级,选择 high 的成本论据来自 DeepSeek 论文而非这次测试。上下文后缀:[1m] 未在 AIHubMix 上测试。Harness UI:AIHubMix 指南早于 0.2.1-rc.1。“输出更短”:DeepSeek 没有量化,需要拿自己提示词上的 completion_tokens 与九月检查点的记录对比。
迁移到 1017 的核心不是改一个模型字符串,而是承认别名背后可能已经换了东西。发全 reasoning_content、记录响应里的 model 字段、把批处理挪出高峰、effort 留在 high,这四件事能把大部分意外挡在门外。
相关推荐
LangGraph速通指南:手撕企业级AI智能体与工作流
LangGraph 速通指南:解析 LangGraph 与 LangChain 的独立关系、MIT 开源协议、FastAPI 高并发部署、人工审批与长短记忆存储机制,助你手撕企业级 AI 智能体与工作流。
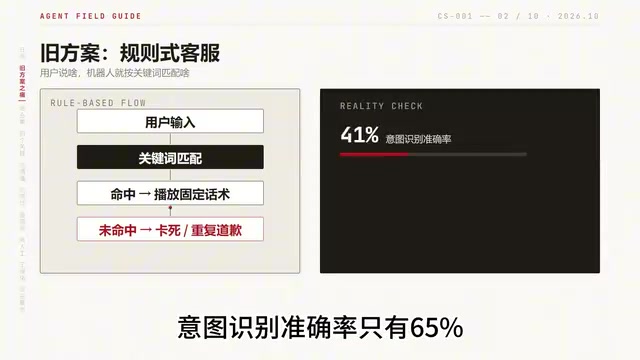
从0到1搭建智能客服Agent:意图识别92%的实战拆解
B站实战分享:从0到1搭建智能客服Agent,用BERT意图识别、对话状态跟踪、向量检索混合方案和转人工打分模型,把意图识别准确率从65%提升到92%,对话完成率78%,每天处理10万次对话。
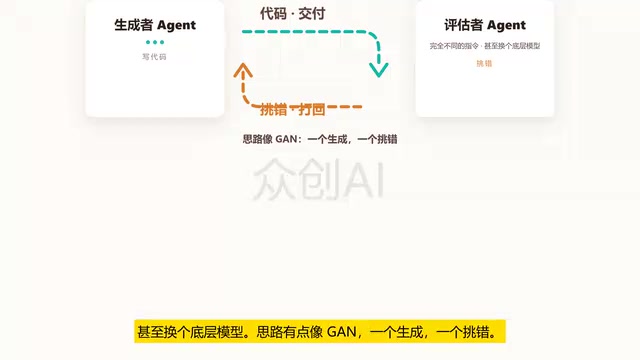
Loop Engineering:让AI自动写代码并合并PR的工程范式
Loop Engineering 正在改变 AI 开发流水线:Stripe 用 Minions 系统每周合并超 1300 个机器生成的 PR。本文拆解 Loop Engineering 的五个核心动作、六类部件、五种失控模式与三条安全纪律,说明为什么独立评估者、状态文件与预算上限比全自动更重要。