DeepSeek V4.1 Flash「小更新」实测:基准全面上涨,性价比重塑推理市场

DeepSeek V4.1 Flash 虽称小更新,但终端基准五周涨11点、性价比突出、思考token省三分之一。
DeepSeek 发布的 V4.1 Flash 1017 被官方称为小更新,但基准表显示 Terminal Bench 4.0 成绩在五周内从31%提升至42%,涨幅达11个百分点,其他指标也全面上涨。单任务成本约20美分,输出价格仅为 GPT 5.6 Sol 的十六分之一,性价比位于曲线顶端。训练上采用强化学习构建完整项目,提升长程规划与工具调用能力。实测思考 token 减少约三分之一,输出更简洁,实际使用成本降幅大于标价。同步推出千次请求75美分的搜索 API,并在 Hugging Face 开放权重。尽管模型结构未变,但工程优化带来的能力升级显著,值得开发者实测验证。
DeepSeek 发布了 Flash 系列的最新版本 V4.1 Flash 1017,官方口径是「一次小更新」。但翻看它自己公布的基准表,几乎每一项指标都在往上走,幅度之大让「minor update」这个说法显得相当谦虚。
这篇内容基于 YouTube 频道的实测解读与官方演示整理,重点拆解三件事:基准涨了多少、价格落在什么位置、以及这版模型在训练方法上做了什么改变。
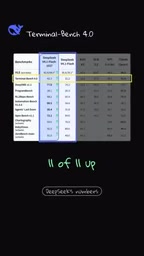
基准表现:五周内终端任务能力跳涨11个点
最有意思的是 Terminal Bench 4.0 的成绩。据视频作者引用的数据,该指标在短短五周内从 31% 提升到 42%,涨幅达到 11 个百分点。对于同一个模型尺寸的迭代版本来说,这个速度并不常见——通常这类「小版本」带来的提升在个位数百分点。
作者用「有点疯狂」来形容这个斜率,并非夸张。终端类任务考察的是模型在多步骤命令行环境中的规划与纠错能力,这类能力的提升往往依赖训练数据质量和强化学习策略的改进,而不是简单堆参数。11 个点的跃迁说明训练侧确实动了真格。
其他基准项也呈现一致方向:官方表格中几乎每个测试项都有上涨。这种「全面上涨而非单点突破」的形态,通常意味着训练流程整体做了优化,而不是针对某一项基准做的定向调优。
Terminal Bench 是一个专门评估语言模型在终端环境中执行多步骤任务的基准测试。它模拟真实的命令行工作流,要求模型根据自然语言指令,规划并执行一系列 shell 命令,例如文件操作、软件安装、系统配置等。测试不仅关注最终结果是否正确,还考察模型在遇到错误时的诊断与恢复能力。该基准的评分通常基于任务完成度、步骤效率及命令准确性。由于终端任务涉及长程规划、工具调用和实时纠错,它被视为衡量模型实际工程能力的重要标尺,尤其能反映模型在强化学习下形成的可验证技能水平。
价格与性能的交叉点:每任务约20美分
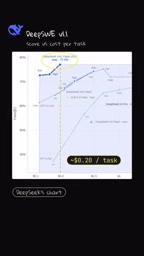
视频里最有信息量的部分是价格-性能散点图。DeepSeek广告 V4.1 Flash 落在图表的最高性价比区域,单个任务成本约 20 美分。作者用「burrito frontier」这个说法来形容这条性价比边界——大意是花一份卷饼的钱能干完的活,它基本都在边界上。
横向对比更值得关注:这个成绩已经接近 OpenAI 的 GPT 5.6 Sol。需要说清楚的是,GPT 5.6 Sol 并非 OpenAI 当前最新的旗舰,所以这不是一次同代对决。但关键在于速度量级——Flash 模型的输出价格大约是对方的十六分之一。在成本敏感型场景里,这种差距足以改变技术选型。
需要提醒的是,散点图上的性价比排名依赖具体任务集的构成。视频没有披露完整的评测任务分布,所以 20 美分这个数字应理解为特定基准下的均值,而非通用工作负载的承诺价格。
GPT 5.6 Sol 是 OpenAI 推出的一款面向复杂推理与多步骤任务优化的模型版本,属于 GPT-5 系列中的特定迭代。Sol 版本通常强调在科学计算、逻辑推理和长上下文理解上的增强,但并非 OpenAI 最新旗舰(如 GPT-5.6 的其他变体或更高版本)。其定价处于高端区间,输出 token 成本显著高于轻量级模型。在性价比对比中,Sol 常作为性能参照点,但需注意其定位并非纯粹的成本敏感型场景,因此直接对比价格时需结合任务复杂度与延迟要求综合评估。
训练方式:用强化学习做完整项目
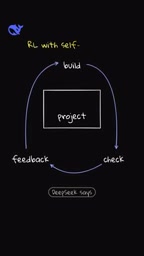
DeepSeek 表示这版模型使用强化学习训练其构建完整项目的能力,并公开了若干演示。从演示形态看,模型被要求端到端完成一个可运行的项目,而不是只回答孤立问题。这种训练范式对奖励设计的要求很高——需要判断一个项目是否真的能跑起来、结构是否合理,而不只是文本层面像不像。
这也解释了终端基准的跳涨:完整项目构建与多步骤终端操作共享同一类能力,即长程规划、工具调用和错误恢复。强化学习在这类可验证任务上有天然优势,因为成功与否可以被程序化判定。
同尺寸模型的性能提升,很大程度来自这种可验证奖励的规模化,而不是模型结构的改动。视频作者也明确说「还是同一个模型、同样的尺寸」,变的是优化程度。
强化学习(Reinforcement Learning, RL) 在大型语言模型训练中,通常指通过奖励信号优化模型行为的方法。与监督学习不同,RL 不依赖人工标注的“正确”输出,而是让模型在环境中尝试动作,并根据结果获得奖励。在代码生成与项目构建场景中,奖励可以设计为程序化验证:例如项目能否成功编译、测试是否通过、结构是否符合规范。这种可验证奖励使得 RL 能够规模化地提升模型的长程规划与错误恢复能力。DeepSeek 此次强调用 RL 训练完整项目构建,正是利用了这一范式,让模型在端到端任务中自我优化,而非仅模仿文本模式。
实际体验:思考 token 减少约三分之一
作者在自己的测试中观察到,这版模型的思考 token 数量减少了大约三分之一,输出也更简洁。官方说法是响应会更精炼、用更少的 token。
这个变化对成本的影响不亚于单价本身。推理模型的账单由输入、输出和思考 token 共同构成,思考部分压缩三分之一,意味着实际使用成本比标价下降得更明显。对高频调用场景来说,这是容易被忽略但相当实在的改进。
代价是可能的取舍:更少的思考 token 在简单任务上是效率,在复杂推理任务上则可能压缩探索空间。视频没有给出复杂任务下的对比数据,这一点需要用户在自己的工作负载上验证。
思考 token(thinking tokens) 指推理型模型在生成最终答案前,内部产生的中间推理步骤所对应的 token。这些 token 不直接展示给用户,但会计入 API 使用量并影响成本。例如,模型可能先分解问题、列举方案、验证条件,再输出结论。思考 token 的多少反映了模型的“深思熟虑”程度:更多 token 往往意味着更充分的探索,但也带来更高延迟和费用。压缩思考 token 可以提升效率、降低实际使用成本,但可能牺牲复杂任务中的推理深度。因此,评估此类优化时需权衡简单任务效率与复杂任务准确性。
配套动作:搜索 API 与开源权重
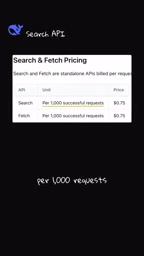
DeepSeek 同时推出了自己的搜索 API,定价为 1000 次请求 75 美分。这个价格放在检索类 API 市场里属于激进区间,配合模型本身的低价,构成了一套完整的低成本推理栈:检索 cheap、生成 cheap、思考 token 也省。
权重方面,模型已在 Hugging Face 开放。对需要私有部署或做微调的团队来说,这消除了供应商锁定的顾虑,也让社区可以独立复现基准结果——视频中的数据目前主要来自官方表格和作者个人测试,独立第三方的大规模评测尚未出现,这是判断这版模型真实水平时应当留意的空白。
这算「小更新」吗
从模型结构看,算。同尺寸、同架构,没有换代级别的改动。
从工程结果看,不太算。五周内终端基准涨 11 点、思考 token 压缩三分之一、性价比曲线推到图表顶端,同时配套搜索 API 并开放权重——这套组合拳的实际影响,更接近一次有分量的能力升级,而不是补丁式的小版本。
对开发者而言,值得关注的不是版本号,而是两个可验证的问题:在自己的任务集上,20 美分级的单任务成本能否复现;思考 token 减少后,复杂任务的准确率是否出现可见的下降。这两点,只有实测能回答。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。