DeepSeek V4.1 Flash登顶AA新基准,超越Astra引热议
DeepSeek V4.1 Flash在AA新私有基准上超越Astra登顶,但评测体系三天两改引发社区对中立性的质疑。
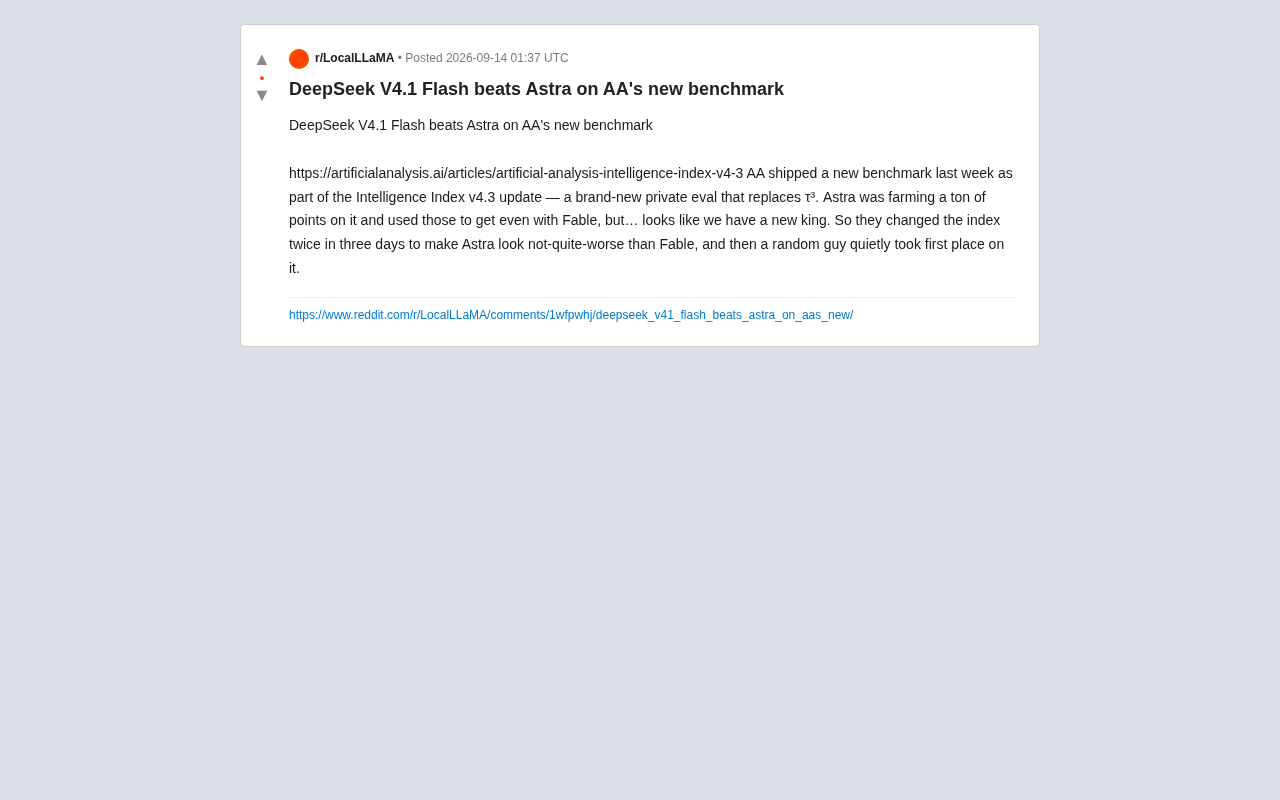
Artificial Analysis在其Intelligence Index v4.3更新中推出全新私有评测基准,DeepSeek V4.1 Flash凭此超越Astra登上榜首。然而这一结果伴随争议:Reddit社区用户指出Astra此前在该基准上集中"刷分",AA随后在三天内两度调整指数权重,被质疑有意缩小Astra与Fable之间的差距。私有评测因题目不公开、可有效规避数据污染而被认为含金量更高,DeepSeek Flash版本在此登顶尤为值得关注,因为它以轻量化、低延迟的定位实现了综合智能维度的头名,体现出效率与能力兼顾的竞争趋势。不过,上述细节主要来源于Reddit单一帖子,具体数据仍需以AA官方发布内容为准。
DeepSeek V4.1 Flash拿下新基准第一
据Reddit社区讨论,Artificial Analysis(AA)在其Intelligence Index v4.3更新中推出了一项全新的私有评测基准,而DeepSeek广告 V4.1 Flash在这项新基准上超越了Astra,登上榜首位置。
这一结果之所以引发关注,是因为它发生在评测体系密集调整的背景下。根据社区用户的描述,AA新推出的这项私有评测取代了此前的τ³(tau-cubed)基准,成为衡量模型综合智能水平的重要组成部分。
评测体系的争议:三天两改指数
Reddit帖子中提到一个颇具争议的细节:Astra此前在这项新基准上"刷"到了大量分数(farming a ton of points),并借此在总榜上与Fable打成平手。而在随后的短短三天内,AA对Intelligence Index进行了两次调整。
发帖者的观点带有明显的质疑色彩,认为这些调整的效果是"让Astra看起来不至于明显落后于Fable"。这种说法本质上是对评测机构中立性的一种怀疑——当基准和权重在极短时间内反复变动时,排行榜的可信度自然会受到审视。
需要说明的是,以上均为社区单一来源的观点表述,AA官方并未就调整动机作出对应回应,读者应对这类推测保持理性判断。
为什么私有评测更受重视
此次AA采用的是"全新私有评测"(brand-new private eval),这一点值得展开。私有评测的核心优势在于其测试题目未公开,模型无法通过在训练数据中"背题"来提升成绩,因此更能反映模型的真实泛化能力。
相比之下,公开基准长期面临数据污染(data contamination)的问题——一旦评测题目进入训练语料,模型的得分就会虚高。这也是为什么帖子中提到某些模型能"farming points"时,社区会格外敏感:如果一个模型在特定基准上分数异常突出,人们首先会怀疑它是否针对性地优化了该测试,而非真正提升了通用能力。
DeepSeek V4.1 Flash在私有评测中拿下第一,若结果属实,含金量相对更高,因为它排除了针对公开题库刷分的可能性。
Flash型号登顶的意义
从命名看,"Flash"通常指向轻量化、低延迟、成本更优的模型变体。这类模型往往为速度和性价比做了权衡,通常不会在最高智能维度上称冠。
如果DeepSeek的Flash版本能在综合智能基准上超越Astra这样的对手,说明其在保持效率优势的同时,智能水平也达到了第一梯队。这对于实际部署场景尤为重要——大量真实应用更看重响应速度和调用成本,而非单纯堆砌参数追求极限性能。
如何看待这场排行榜之争
这次事件折射出当前AI模型评测领域的两个现实:其一,基准更新的频率和方式会直接影响厂商与社区的信任;其二,头部模型之间的竞争已经细化到具体基准的每一分差距。
对于关注模型能力的开发者和用户而言,与其纠结于单一榜单的排名波动,不如结合多项基准和自身实际任务进行验证。排行榜提供的是参考坐标,而非最终答案。
由于本文素材主要来自Reddit社区的单一讨论帖,关于分数细节、调整幅度等具体数据仍需以AA官方发布的Intelligence Index v4.3内容为准。
相关推荐
AI游戏开发实战:音频总线与全流程UI搭建
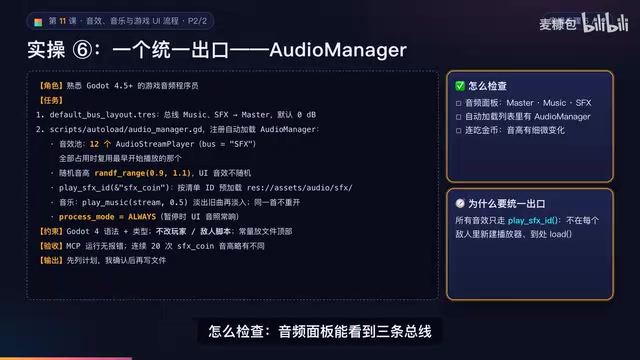
AI游戏开发实战第11课下篇:讲解Godot音频三件套、音频总线与音量分贝转换、AudioManager音效池与随机音高、自动加载节点边界、从标题到通关的完整UI流程、JSON存档容错设计,以及像素字体抗锯齿关闭与整数倍字号规则。
AI游戏开发验收课:用GUT测试与Agent自检让Bug无处可藏
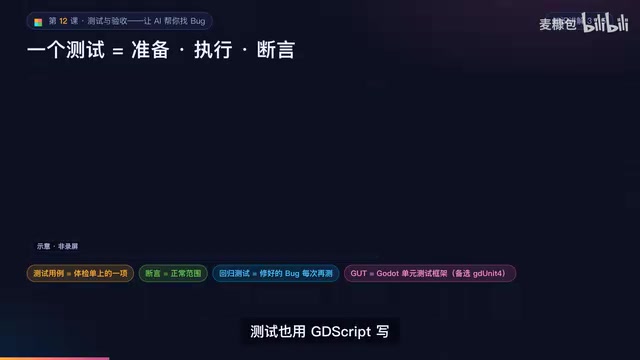
AI游戏开发实战第十二课聚焦测试与验收:用GUT自动化测试、Agent自检循环、浏览器冒烟验收和外部试玩四层金字塔,让AI的每一项完成都有可观测证据。核心原则是退出码判据、证据必须为原文、禁止Agent改断言让测试变绿。

DoorDash披露:AI智能体下单仅数百单,开放合作成关键
DoorDash 披露其平台仅收到数百单来自 AI 智能体的订单,并表示愿意与第三方智能体开发者合作。本文分析智能体电商的早期现状、平台开放策略以及交易信任瓶颈。