DeepSeek V4.1 Flash登陆Cursor:全档位领跑成本前沿

DeepSeek V4.1 Flash 接入 Cursor,全 effort 档位落在成本前沿,单任务 0.60–0.98 美元。
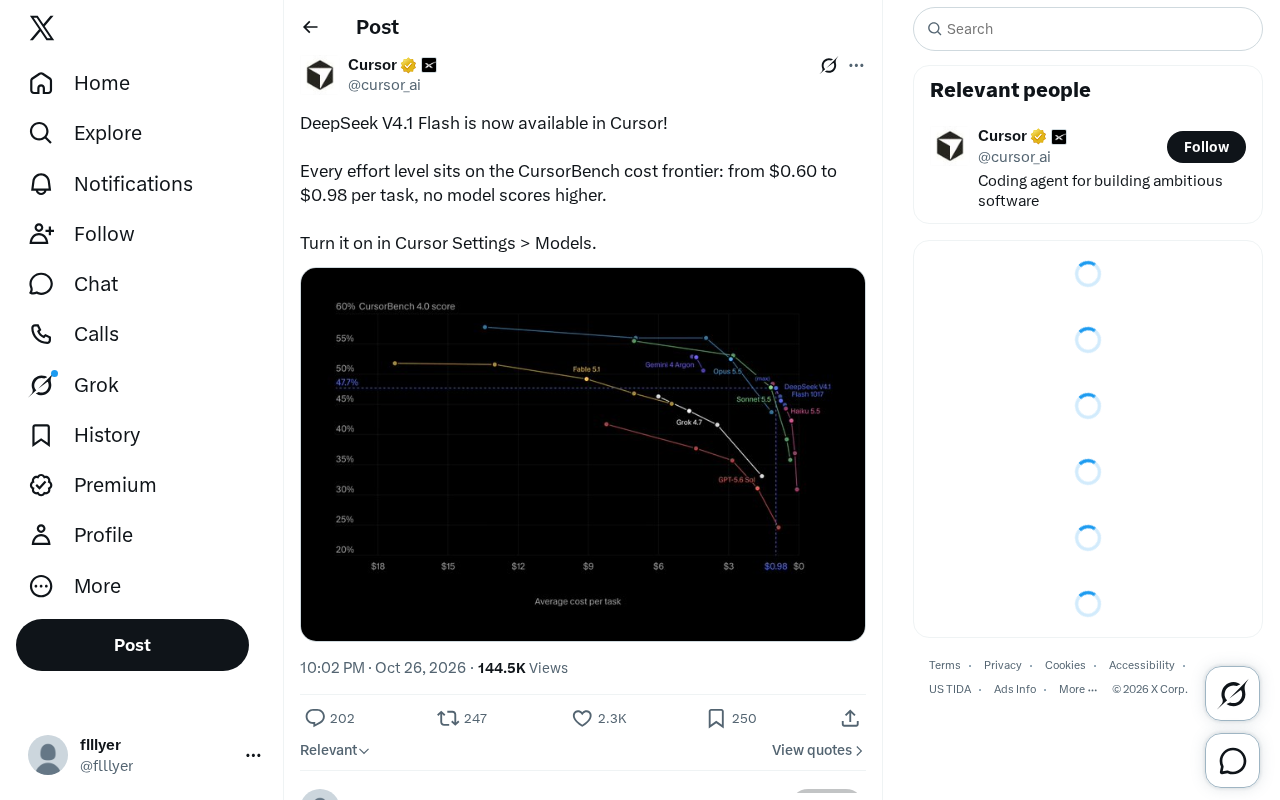
DeepSeek V4.1 Flash 正式接入 Cursor,用户可在 Settings > Models 中直接开启,无需额外配置。官方数据显示,该模型在 CursorBench 上每一个 effort 档位都落在成本前沿上,单任务成本区间为 0.60 至 0.98 美元,同价位下没有模型得分更高。全档位的前沿表现说明其推理强度与成本之间的缩放关系较为平滑,而非只在某一档位取巧。对开发者而言,这意味着更细粒度的成本控制空间:简单补全用低成本档、复杂重构用高 effort 档,且每档都处于该价位的最优区间。对预算敏感的团队,它可作为默认模型候选,提供可预测的开销模型。文章同时提示,官方基准数据仍需第三方复现验证。
DeepSeek V4.1 Flash 已正式接入 Cursor。官方宣布,在 CursorBench 基准测试中,该模型的每一个 effort 档位都落在成本前沿(cost frontier)上——单任务成本从 0.60 美元到 0.98 美元,同价位下没有模型得分更高。
接入方式与可用性
用户可以在 Cursor 的 Settings > Models 中直接开启 DeepSeek广告 V4.1 Flash,无需额外配置。这意味着 Cursor 用户在模型选择上又多了一个低成本、高性能的选项。
对于日常依赖 Cursor 进行代码补全、重构和调试的开发者来说,模型列表的每一次扩充都直接影响使用成本和响应质量。DeepSeek V4.1 Flash 的加入,让「便宜但够用」这一档位有了新的竞争者。
Cursor 是基于 VS Code 分支构建的 AI 编程编辑器,核心能力包括行内代码补全、选中代码后的对话式改写、跨文件重构以及 agent 模式下的多步任务执行。它的模型接入采用「多模型路由」架构:用户在 Settings > Models 中启用或禁用具体模型,工具会根据任务类型与用户配置决定调用哪一个。这种设计使得新增一个模型对终端用户几乎是零成本的——不需要申请新的 API key、不需要改动工作流,只需在列表里勾选。也正因如此,模型进入 Cursor 列表本身就被视为一次市场信号:它意味着该模型已通过工具方的接入适配与基础评测。
成本前沿意味着什么
「成本前沿」是评估模型性价比的核心概念:在给定成本水平下,能取得最高得分的模型构成前沿曲线,落在曲线上的模型意味着没有其他模型能在同样价格下提供更好的表现。
官方数据显示,DeepSeek V4.1 Flash 在 CursorBench 上的单任务成本区间为 0.60 至 0.98 美元。关键点不在于绝对价格高低,而在于每一个 effort 档位都处于前沿位置——从低 effort 到高 effort,成本随性能同步上升,且每个档位都没有被同价位竞品超越。
这背后反映的是模型在不同推理强度下的效率一致性。很多模型在低 effort 时便宜但质量下降明显,在高 effort 时质量提升却伴随成本陡增,导致中间档位脱离前沿。DeepSeek V4.1 Flash 的全档位表现说明其推理强度与成本之间的缩放关系较为平滑。
effort 档位(推理强度档) 指的是模型在生成回答时投入的「思考量」层级,通常通过控制思维链长度、采样次数或内部推理预算来实现。低 effort 档位响应快、token 消耗少、单次调用成本低,适合代码补全这类模式化任务;高 effort 档位会展开更长的推理链、尝试更多候选路径,因而得分更高但成本也更高。不同厂商对档位的命名和切分方式不同,但共同点是:档位选择本质上是让开发者用显式的配置项,在延迟、成本与质量之间做权衡,而无需更换模型本身。
成本前沿(cost frontier) 源自经济学与多目标优化中的帕累托前沿概念。把横轴设为单任务成本、纵轴设为基准得分,每个模型(或同一模型的不同档位)对应平面上的一个点;所有不被其他点「既更便宜又更高分」支配的点连成的曲线即为成本前沿。落在前沿上意味着该点在当前可选集合中是帕累托最优的:想提高得分就必须付出更多成本,想降低成本就必然损失得分。因此「全档位落在前沿」是一个比「单点便宜」强得多的声明——它要求模型在整条成本-性能曲线上都没有被同价位竞品支配。
对开发者的实际影响
对于 Cursor 用户,这次接入带来的是更细粒度的成本控制空间。开发者可以根据任务复杂度选择不同的 effort 档位:简单补全用低成本档,复杂重构用高 effort 档,而每个档位都保持在该价位的最优表现区间。
这也意味着在预算敏感的团队场景中,DeepSeek V4.1 Flash 可以作为默认模型的候选之一。单任务不足 1 美元的成本,配合前沿级别的得分,为高频使用 AI 编程助手的团队提供了可预测的开销模型。
CursorBench 是 Cursor 官方用于评估模型在其真实产品场景中表现的内部基准,通常覆盖补全、编辑、多文件重构与 agent 任务等类别,并同时记录得分与单任务成本。与通用的代码生成基准(如 HumanEval、SWE-bench)相比,它的特点是贴近实际编辑器工作流、且把成本作为一等指标纳入报告。需要注意,厂商自建基准在任务分布和评分口径上可能与第三方评测存在差异,因此其发布的成本前沿结论更适合作为选型的初始参考,而非最终定论——这也是原文强调需要社区复现的原因。
竞争格局观察
Cursor 作为 AI 编程工具的代表产品,其模型列表的构成某种程度上反映了市场竞争的走向。DeepSeek V4.1 Flash 以成本前沿全档位覆盖的姿态进入,对同价位区间的其他模型形成直接压力。
值得跟踪的是后续第三方复现测试的结果——官方公布的 CursorBench 数据具有说服力,但实际开发场景中的表现仍需社区验证。如果独立测试能够印证这一成本前沿结论,DeepSeek V4.1 Flash 有望成为 Cursor 生态中性价比档位的常驻选项。
目前,用户只需在设置中开启即可体验。对于正在评估模型成本和效果的开发者,这是一个值得纳入对比清单的新选择。
相关推荐
64麦克风声学相机实测:800美元看见声音
实测Amazon售价800美元的TD2E声学成像相机:64个麦克风阵列实时定位声源,频响覆盖2000至100000赫兹,可探测超声波。本文分析其工作原理、实际定位精度、工业巡检适用场景及接口缺失等细节问题。
制造加速器Re:Build融资21亿美元,分拆Slate Auto
制造加速器Re:Build完成21亿美元融资,自称“美国对深圳的回应”,并分拆出Slate Auto。本文梳理已知事实、定位含义与信息缺口。
OpenAI公开突破却遭学界诟病:科研透明度成焦点
OpenAI公布数学、计算机科学和物理学突破并声称改进沟通方式,但研究人员向The Verge表示不满加剧,批评其选择性公开、缺乏可复现细节,企业研究与开放科学之间的张力再度凸显。