DeepSeek-V4.1-Flash发布:552B MoE与Engram记忆架构解析
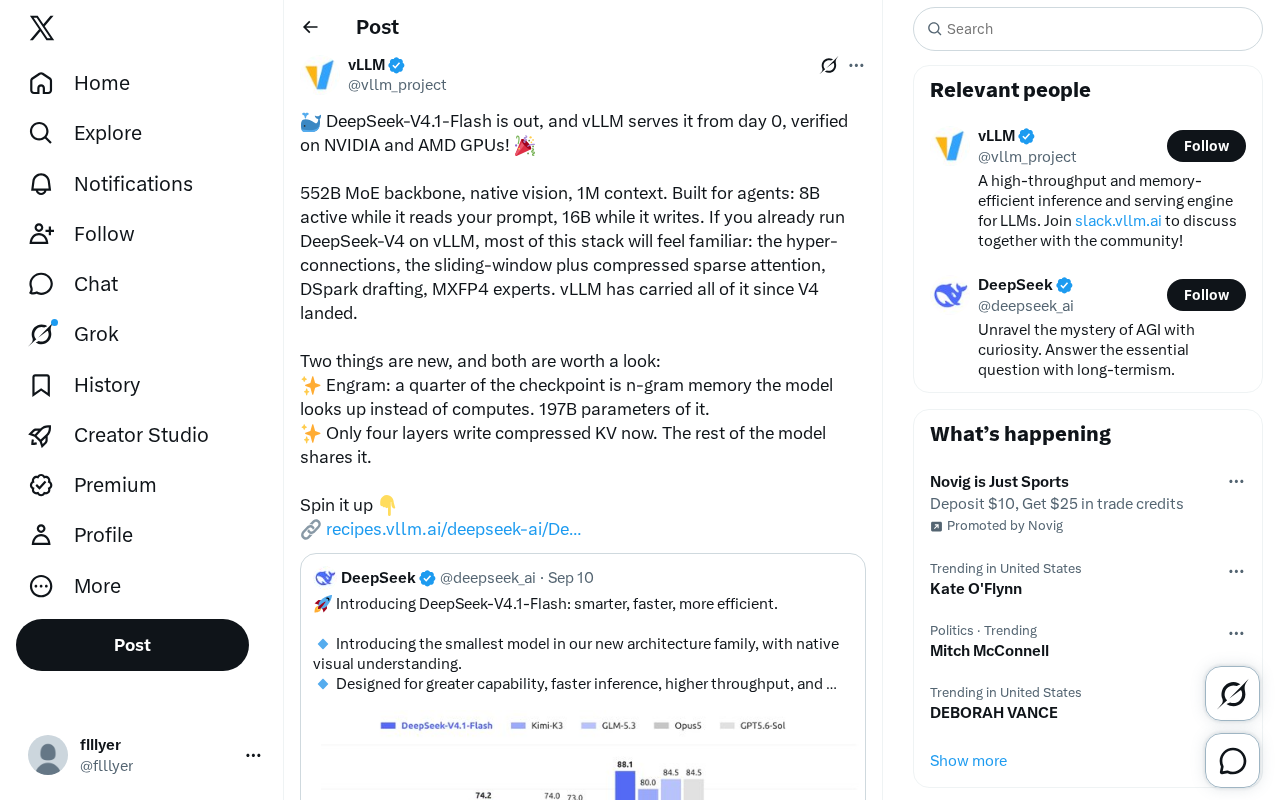
DeepSeek-V4.1-Flash以552B MoE架构引入Engram记忆与压缩KV共享,专为长上下文智能体场景降低推理成本,vLLM提供day-0跨平台支持。
DeepSeek-V4.1-Flash是一款552B参数的MoE模型,原生支持视觉输入与100万token上下文,并针对智能体场景设计了差异化激活策略——读取阶段仅激活8B参数,生成阶段激活16B参数。在延续V4超连接、滑动窗口注意力、投机解码、MXFP4低精度专家等成熟技术栈的基础上,V4.1-Flash引入两项关键创新:Engram将四分之一检查点(197B参数)用作n-gram记忆表,以查找替代实时计算;压缩KV共享机制仅允许四层写入KV缓存、其余层共享,大幅降低长上下文场景的显存压力。vLLM从发布首日即提供支持,并同时在NVIDIA与AMD硬件上完成验证,使这套复杂架构在开源推理框架上开箱即用。
DeepSeek-V4.1-Flash正式发布,vLLM从第一天起就提供了原生支持,并在NVIDIA与AMD两大GPU平台上完成了验证。这次更新在延续V4技术栈的基础上,引入了两项值得关注的架构创新。
核心规格:为智能体而生的稀疏架构
DeepSeek-V4.1-Flash采用552B参数的MoE(混合专家)主干,原生支持视觉输入,并将上下文窗口扩展至100万token。这些参数指标本身已经足够亮眼,但更具设计意图的是它的激活策略。
模型针对智能体(agent)场景做了专门优化:在读取prompt阶段仅激活8B参数,而在生成输出阶段激活16B参数。这种「读少写多」的动态激活方式,意味着模型在处理长上下文输入时保持极低的计算开销,只有在真正需要推理和生成时才调用更多算力。对于需要频繁读取大量上下文、间歇性输出的智能体工作流而言,这是一种相当契合的资源分配思路。
MoE(Mixture of Experts,混合专家)是一种稀疏激活架构:模型由大量「专家」子网络组成,每次前向传播时由门控路由器(gating router)只选择其中少数几个专家参与计算,而非激活全部参数。这使得MoE模型可以在参数总量(决定知识容量)与实际计算量(决定推理成本)之间解耦——552B的总参数不代表每次推理都要跑552B的计算量。DeepSeek-V4.1-Flash将这一特性进一步细化:区分prompt读取阶段与token生成阶段,分别激活8B和16B参数,本质上是将MoE的稀疏性在推理流程的不同阶段差异化应用。
熟悉的技术栈:从V4延续而来
如果你已经在vLLM上运行过DeepSeek-V4,那么V4.1-Flash的大部分技术栈会显得相当熟悉。原文明确指出,以下几项能力自V4落地以来vLLM就已全面承接:
- 超连接(hyper-connections):改进层间信息流动的连接机制
- 滑动窗口 + 压缩稀疏注意力:兼顾长上下文效率与注意力质量
- DSpark drafting:投机解码相关的草稿机制,用于加速生成
- MXFP4 experts:专家层采用MXFP4低精度格式,压缩显存与算力需求
这种技术连续性对生产环境部署者是个好消息——现有的推理栈无需大规模改造,就能平滑迁移到新模型。
两项新特性:Engram记忆与共享KV
真正的新变化集中在两点,官方也特别强调二者「都值得一看」。
Engram:把记忆变成查表而非计算
Engram是这次最引人注目的设计。它把整个checkpoint中四分之一的容量用作n-gram记忆——具体规模达到197B参数。模型面对这部分内容时,采取的是「查找」而非「计算」的方式。
换句话说,模型不再对某些高频语言模式反复进行前向计算,而是像查字典一样直接检索预存的n-gram记忆。这种做法把一部分语言建模负担从实时计算转移到了内存查表,理论上能在特定场景下降低推理成本、提升响应速度。197B参数的规模也说明,DeepSeek团队对这条路线下了不小的赌注。
n-gram是自然语言处理中的经典概念,指文本中连续n个词(或token)构成的序列。传统语言模型在预训练过程中将高频n-gram模式隐式编码进权重,每次推理时仍需通过完整的矩阵乘法「重新计算」这些模式。Engram的思路则是将这部分知识显式物化为可检索的记忆表——类似于把常用词组收录进词典,遇到时直接查找而无需重新推导。197B参数的规模意味着这张「词典」覆盖了大量高频语言片段。这与检索增强生成(RAG)有概念上的相似性,但Engram是模型内部权重结构的一部分,而非外部知识库的调用,因此延迟特性与系统复杂度均有本质差异。
压缩KV共享:只有四层写入
第二项变化针对KV缓存。在V4.1-Flash中,只有四个层负责写入压缩后的KV,模型其余部分共享这份缓存。
KV缓存是长上下文推理中的主要显存瓶颈之一。通过让绝大多数层共享少数几层写入的压缩KV,模型显著削减了KV缓存的存储压力。结合100万token的上下文能力来看,这项设计几乎是长上下文场景能够落地的前提——否则百万级上下文的KV缓存开销将难以承受。
KV缓存(Key-Value Cache)是Transformer推理的核心机制:在自回归生成过程中,每一层的注意力计算会产生Key和Value矩阵,为避免对历史token重复计算,这些矩阵会被缓存在显存中供后续token复用。随着上下文长度增长,KV缓存的显存占用呈线性扩张——对于百万token级上下文,若每层都独立维护完整KV缓存,其显存开销往往超过模型权重本身,成为长上下文推理落地的最大障碍。DeepSeek-V4.1-Flash的「仅四层写入、其余层共享」策略,本质上是一种极激进的KV缓存压缩:通过大幅减少需要独立存储的KV层数,将显存压力压缩至原来的极小比例,代价是部分层失去了独立的注意力表达能力。这与Multi-Query Attention(MQA)和Grouped-Query Attention(GQA)的精神一脉相承,但共享粒度更粗。
Day-0支持的工程意义
vLLM从发布首日即提供支持,并同时验证NVIDIA与AMD硬件,这一点的价值不容低估。对开发者和企业用户来说,模型能力再强,如果缺乏成熟的推理框架和跨硬件支持,落地成本依然很高。
DeepSeek与vLLM的紧密协作,让这套包含超连接、稀疏注意力、投机解码、低精度专家、Engram记忆和共享KV在内的复杂架构,在开源推理栈上开箱即用。跨NVIDIA/AMD的验证也意味着用户在硬件选型上拥有更大灵活性,不必被单一供应商锁定。
小结
DeepSeek-V4.1-Flash延续了V4成熟的稀疏与低精度技术栈,同时以Engram记忆和压缩KV共享两项创新,进一步压低了长上下文与智能体场景下的推理成本。552B MoE主干、100万上下文、原生视觉,加上vLLM的day-0跨平台支持,构成了一套面向实际部署的完整方案。对于关注开源大模型工程落地的团队,这是一个值得尽快上手评估的版本。
注:本文基于官方发布信息整理,部分架构细节有待更详细的技术文档进一步验证。
相关推荐
分布式系统经典论文导读:从入门到精通的必读清单
一份在 Hacker News 走红的分布式系统经典论文清单,涵盖共识算法、逻辑时钟、CAP 定理等核心主题,为工程师提供系统化的学习路径与理论到实践的桥梁。
Valve仍在权衡Steam Deck 2的推出时机
Valve完成Steam Controller、Steam Machine和Steam Frame三款2026硬件产品线后,Steam Deck 2仍无明确时间表。Valve设计师表示仍在权衡"如何以及何时"推出,坚持不为单纯性能提升而做续作。
"Dario, Please":一封写给Anthropic CEO的公开呼吁引发热议
《Dario, Please》一文在Hacker News引发热议,累计247分与122条评论。这封写给Anthropic CEO Dario Amodei的公开呼吁,折射出AI社区对头部大模型公司决策方向的持续关切与话语生态变化。