DeepSeek V4.1 Flash发布:552B参数全面超越V4 Pro

DeepSeek发布552B MoE架构的V4.1 Flash,性能超越旧旗舰V4 Pro,并大幅降价,9月14日起全量切换。
DeepSeek于9月10日密集发布6条推文,正式推出V4.1 Flash模型。该模型采用552B参数的MoE稀疏激活架构,推理时仅激活80-160亿参数,KV缓存显存开销降至上代四分之一,在性能、速度和成本上全面超越旧旗舰V4 Pro,并在Agent编码类基准上击败同级竞品。新模型原生支持视觉理解,实现多模态升级,定价也低于即将退役的V4 Flash,并推出限时5折优惠。自9月14日起,V4 Pro将全量路由至新模型,开发者和企业用户需提前完成迁移。
突发:DeepSeek连发6条推文推出V4.1 Flash
DeepSeek广告官方在9月10日突然发力,一口气发布6条推文,正式推出全新的V4.1 Flash模型。作为中体量段位中最小的模型之一,V4.1 Flash主打「更强能力、更快推理、更高吞吐」的三重升级,并原生支持视觉理解能力。据B站UP主的第一时间快讯分析,这款模型不仅在综合性能上全面超越上代旗舰V4 Pro,更在多项Agent编码基准上实现了对同级模型的反超。
从时间线看,这次发布相当激进——从内测到转正仅用了两天时间。这种「快速迭代、即时上线」的节奏,也让业界对紧随其后的V4.1 Pro充满期待。
V4.1 Flash架构解析:552B参数的稀疏化设计
V4.1 Flash最引人注目的地方在于其全新架构。模型总参数量达到552B,采用了MoE(混合专家)稀疏激活机制,并引入了新的因果编码器-解码器结构。

关键的稀疏化设计体现在激活参数上:输入阶段仅激活80亿参数,输出阶段激活160亿参数。这意味着虽然模型总容量高达552B,但实际推理时的计算开销被控制在极低水平。这种「大容量、小激活」的思路,正是当前大模型在成本与性能之间寻求平衡的主流方向。
更重要的是显存优化。官方数据显示,V4.1 Flash的KV缓存显存开销仅为上一代的四分之一,SSD存储需求也降至八分之一。对于需要频繁读写缓存的重度Agent场景而言,这将带来显著的成本降低——这一点对于长时间运行的自动化代理任务尤为关键。
MoE(Mixture of Experts,混合专家)是当前大型语言模型主流的稀疏化架构范式。与传统Dense模型每次推理都激活全部参数不同,MoE将模型分割为多个「专家」子网络,每个Token在前向传播时只由路由器(Router)动态选择少数几个专家处理。这样一来,模型可以在不线性增加推理计算量的前提下大幅扩充参数总量,从而在训练时积累更丰富的知识表征。GPT-4、Mixtral、Google的Gemini系列均采用了类似思路。V4.1 Flash的552B总参数对应推理时仅激活80-160亿参数,激活比例约为3%-29%,这种极高的稀疏率在保证吞吐的同时也对路由器的精准度提出了更高要求。
KV缓存(Key-Value Cache)是Transformer推理中的关键加速机制。在自回归生成过程中,每个新Token都需要与所有历史Token做注意力计算,KV缓存通过将已计算的Key和Value矩阵存储在显存中来避免重复计算,代价是随上下文长度线性增长的显存占用。在长上下文或多轮对话的Agent场景中,KV缓存往往成为显存瓶颈,直接影响并发能力和单次推理成本。V4.1 Flash将KV缓存显存开销降至上一代四分之一,意味着同等硬件条件下可支持更长的上下文窗口或更高的并发请求数,对于需要持续调用工具、维持长期记忆的自动化代理任务具有显著实用价值。
性能全面反超:多项基准领先V4 Pro
根据官方援引的多方实测数据,V4.1 Flash在性能、成本、速度、总耗时等多个维度上全面领先上代旗舰V4 Pro。

尤其值得关注的是Agent编码类基准测试。在这一对代码理解、多步推理能力要求极高的赛道上,V4.1 Flash不仅超越了自家的V4 Pro,还实现了对同级竞品的反超。这说明DeepSeek在架构层面的优化确实转化为了实打实的任务表现提升,而不仅仅是参数堆砌。
结合前文提到的原生视觉理解能力,V4.1 Flash实际上已经从纯文本模型进化为多模态基座,这为其在复杂Agent应用中的落地打开了更大空间。
Agent编码基准(Agentic Coding Benchmark)是近年新兴的评测维度,与传统代码生成基准(如HumanEval、MBPP)的单次补全任务不同,它要求模型在多步交互中完成完整的软件工程任务:理解需求、拆解步骤、调用工具、修复错误,直至产出可运行结果。代表性基准包括SWE-bench(基于真实GitHub Issue的Bug修复)和HumanEval+等延伸版本。这类基准对模型的长程规划能力、指令遵循稳定性和代码上下文理解要求极高,被认为比单轮代码补全更能反映模型在实际开发工作流中的真实能力。V4.1 Flash在该赛道超越同级竞品,说明其架构优化对多步推理链路有实质性改善。
V4.1 Flash定价方案:旧旗舰V4 Pro退役倒计时
除了性能升级,这次发布最直接影响用户的还是价格调整。DeepSeek明确了新的计费方案,按每百万Token计算:
- 缓存命中:最高6美分
- 缓存未命中:0.3美元
- 输出:1.2美元

此外,官方还推出了限时优惠——特定时段统一按5折计费。整体价格已经低于即将退役的V4 Flash,可以说是「加量又降价」。
伴随新模型上线,旧旗舰的退役时间表也已确定:自9月14日中午12点起,V4 Pro将全量路由到新模型,届时统一按新价计费。同时,WorkBuddy广告和OpenCode等工具生态也将全面支持V4.1 Flash。

开源与大规模部署支持
在开源生态方面,DeepSeek表示将联合开源社区共同完善推理支持。对于有大规模部署需求的企业客户,官方明确表示2000卡级别的大规模部署可以直接洽谈——这一表态显示出DeepSeek在争夺企业级市场上的野心。
总结:V4.1 Flash值得尽早迁移
V4.1 Flash的发布,展现了DeepSeek在架构创新(MoE稀疏激活、因果编解码器)、成本控制(KV缓存与存储优化)和商业策略(激进降价、平滑迁移)上的全面发力。从内测到转正仅用两天的速度,也预示着后续V4.1 Pro等更强版本的到来值得期待。
对于开发者和企业用户而言,随着9月14日V4 Pro退役节点的临近,尽早熟悉并迁移到V4.1 Flash新模型,将是接下来需要关注的重点。
相关推荐
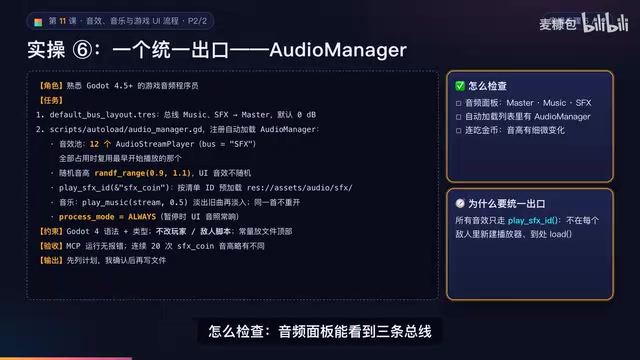
AI游戏开发实战:音频总线与全流程UI搭建
AI游戏开发实战第11课下篇:讲解Godot音频三件套、音频总线与音量分贝转换、AudioManager音效池与随机音高、自动加载节点边界、从标题到通关的完整UI流程、JSON存档容错设计,以及像素字体抗锯齿关闭与整数倍字号规则。
AI游戏开发验收课:用GUT测试与Agent自检让Bug无处可藏
AI游戏开发实战第十二课聚焦测试与验收:用GUT自动化测试、Agent自检循环、浏览器冒烟验收和外部试玩四层金字塔,让AI的每一项完成都有可观测证据。核心原则是退出码判据、证据必须为原文、禁止Agent改断言让测试变绿。

DoorDash披露:AI智能体下单仅数百单,开放合作成关键
DoorDash 披露其平台仅收到数百单来自 AI 智能体的订单,并表示愿意与第三方智能体开发者合作。本文分析智能体电商的早期现状、平台开放策略以及交易信任瓶颈。