DeepSeek V4-1 Flash发布:552B参数MoE多模态模型支持百万上下文
DeepSeek再次搅动市场
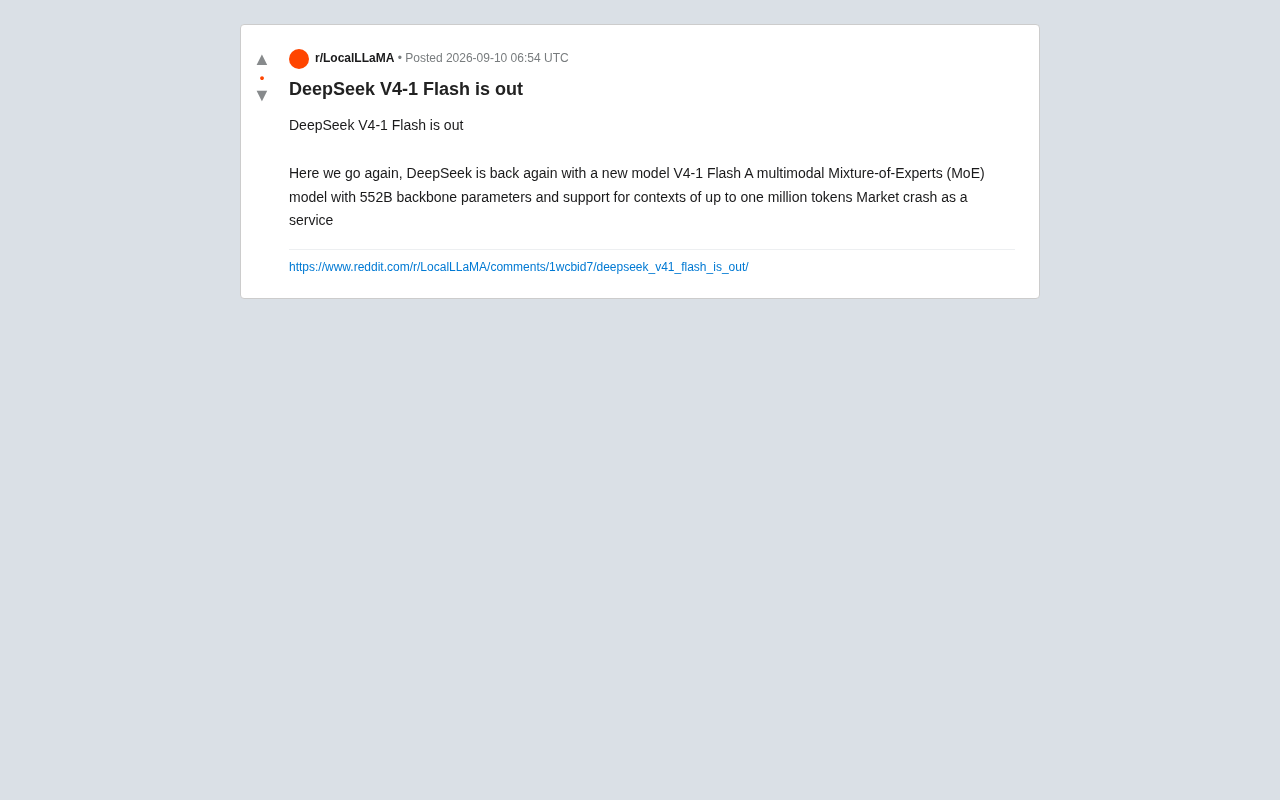
国产大模型厂商DeepSeek广告再度出手,发布了全新的V4-1 Flash模型。这一次,DeepSeek带来的不只是常规迭代,而是一款采用混合专家架构(Mixture-of-Experts, MoE)的多模态模型,拥有高达5520亿(552B)主干参数,并支持最高100万tokens的超长上下文。
消息在Reddit社区一经放出,便引发了热烈讨论。有网友半开玩笑地称DeepSeek的每次发布都是"Market crash as a service"(市场崩盘即服务)——回顾此前DeepSeek系列模型多次以极具竞争力的性能和成本冲击行业格局,这句调侃背后其实透露出业界对其技术实力的认可与忌惮。这一戏称并非空穴来风:在2025年初DeepSeek-R1发布时,其极低的训练成本估算一度引发华尔街对AI资本支出合理性的质疑,导致英伟达等芯片巨头股价出现显著回调,市场对"是否需要如此大规模的算力投入"产生了根本性反思。这一事件也被媒体称为"DeepSeek冲击",其深远影响不仅限于股市波动——它迫使整个行业重新审视Scaling Law(规模定律)的经济学边界,即模型能力的提升是否必须依赖算力投入的线性或超线性增长,还是可以通过架构创新和工程优化实现"弯道超车"。

V4-1 Flash核心技术亮点
混合专家架构(MoE):大参数低激活
V4-1 Flash采用的MoE架构,是当前大模型突破算力瓶颈的主流路线之一。与传统稠密模型(Dense Model)在每次推理时激活全部参数不同,MoE架构通过"路由机制"仅激活部分专家网络参与计算。这意味着,尽管模型总参数量高达552B,但实际推理时的计算成本可以被显著控制在合理范围内。
MoE架构的核心思想最早可追溯到1991年Jacobs等人提出的混合专家系统,但真正在大语言模型领域大放异彩是近几年的事。Google在2022年发布的Switch Transformer是MoE在Transformer架构上的里程碑式应用。其关键组件包括多个并行的"专家"前馈网络(FFN)和一个门控路由器(Gating Router)——路由器负责将每个token分配给最适合处理它的少数专家,通常只激活总专家数的10%-20%。这种稀疏激活机制带来的核心优势是:模型的知识容量(由总参数量决定)可以远超实际推理时的计算量(由激活参数量决定),从而打破了传统稠密模型中"更强能力必然意味着更高算力消耗"的线性约束。值得一提的是,DeepSeek在V2阶段就引入了自研的DeepSeekMoE架构,创新性地采用了细粒度专家分割和共享专家隔离策略,显著提升了路由效率和专家利用率。
然而,MoE架构在理论上极具吸引力的同时,工程实现中面临诸多挑战。首先是负载均衡问题:如果路由器持续将token分配给少数几个热门专家,会导致"专家坍缩"(Expert Collapse),即大部分专家得不到充分训练而逐渐退化。为此,业界通常引入辅助损失函数(Auxiliary Loss)来强制平衡各专家的负载分布。其次是通信开销:在分布式训练和推理中,不同专家通常分布在不同GPU上,token路由需要跨设备传输数据,这引入了All-to-All通信瓶颈,可能抵消稀疏计算带来的效率增益。DeepSeek在V3阶段就针对这些问题进行了深入优化,例如采用无辅助损失的负载均衡策略(避免辅助损失对主任务梯度的干扰),以及优化的EP(Expert Parallelism)并行方案,这些技术积累为V4-1 Flash的552B规模MoE提供了坚实的工程基础。
这种"大参数、低激活"的设计,正是DeepSeek此前几代模型能够在保持高性能的同时压低推理成本的关键。对于开发者和企业用户而言,这意味着可以用更低的成本获得接近甚至超越顶级稠密模型的表现。
百万级上下文窗口:长文档处理利器
支持最高100万tokens的上下文,是V4-1 Flash的另一大杀手锏。百万tokens的容量意味着模型可以一次性处理整本书籍、超长代码库、大规模文档集合,甚至是完整的项目工程。以常见的中文文本为例,100万tokens大约对应150万-200万个汉字,相当于数十本标准书籍的体量。
要理解百万级上下文窗口的技术难度,需要了解标准Transformer自注意力机制的计算复杂度为O(n²)——即上下文长度每翻一倍,计算量增长四倍,显存占用也急剧膨胀。要实现百万级tokens的上下文,需要一系列工程和算法层面的深度创新:包括稀疏注意力(Sparse Attention)、线性注意力近似、FlashAttention等高效注意力计算方法,以及RoPE(旋转位置编码)的长度外推技术如YaRN、NTK-aware Scaling等。DeepSeek在此前的模型中已经展示了对这些技术的深入掌握。
上下文窗口的扩展经历了近年来的快速演进:GPT-3时代仅支持2048 tokens,到GPT-4扩展至128K,再到Claude 3支持200K,如今DeepSeek直接推至百万级别。这一演进背后反映了真实商业需求的强力驱动——企业级RAG(检索增强生成,Retrieval-Augmented Generation)应用中,长上下文可以减少对外部检索系统的依赖,将更多相关文档直接纳入上下文窗口进行端到端推理;法律和金融行业需要模型一次性理解数百页合同或财报进行条款分析和风险评估;软件工程场景中,开发者希望模型能理解整个代码仓库的架构而非局限于单个文件的片段。百万级上下文本质上是在重新定义人机交互的信息带宽上限,使AI从"片段式理解"走向"全局式认知"。
对于需要长文档理解、代码分析、多轮复杂对话的应用场景,超长上下文能够大幅减少信息切割带来的语义损失,让模型真正"看得全、记得住"。不过,百万级上下文并不仅仅是数字指标的提升,更关键的是"有效上下文"——即模型能否真正利用远距离的信息进行推理,而不是出现所谓的"Lost in the Middle"现象(研究表明,许多模型对中间位置信息的利用效率显著低于首尾位置)。这也是当前主流大模型竞争的核心战场之一,Google的Gemini、Anthropic的Claude都在这一维度持续发力。
原生多模态能力:文本与图像融合理解
V4-1 Flash被定位为多模态模型,意味着它不仅能处理文本,还能理解图像等多种模态的信息。多模态能力的加入,让模型的应用边界从纯文本交互扩展到视觉理解、图文混合推理等更广阔的领域。
当前主流的多模态大模型架构通常包含三个关键组件:视觉编码器(如ViT系列,即Vision Transformer,负责将图像分割为patch并转化为一系列视觉token)、模态对齐模块(如线性投影层或Q-Former,负责将视觉token映射到语言模型能理解的表征空间)、以及语言模型主干(统一处理文本和视觉信息进行推理)。这一架构范式的核心挑战在于如何让不同模态的信息在统一的语义空间中实现高效融合,避免模态之间的信息损失。OpenAI的GPT-4o、Google的Gemini系列、以及Anthropic的Claude都在多模态方向持续迭代。DeepSeek此前的VL(Vision-Language)系列模型已经在视觉理解方面积累了丰富经验,V4-1 Flash的多模态能力很可能是这一技术路线的进一步深化和升级。
多模态技术的产业化正在加速推进,但仍面临若干核心挑战。在训练数据层面,高质量的图文配对数据远比纯文本数据稀缺——互联网上虽然存在海量图文内容,但噪声大、标注质量参差不齐,高质量数据集的构建成本远高于文本语料。在评估层面,多模态能力的基准测试尚未形成统一标准——MMMU(多学科多模态理解)、MMBench、MathVista等评测各有侧重,单一基准难以全面反映模型的真实多模态理解能力,这使得不同模型之间的横向对比变得复杂。在应用落地层面,医学影像分析、工业质检、自动驾驶场景感知等垂直领域对多模态模型的精度和可靠性提出了极高要求,这些场景中"够用"与"可信赖"之间仍存在显著差距。V4-1 Flash的多模态能力若能在这些高价值场景中展现优势,将具有巨大的商业潜力。
从模型命名中的"Flash"来看,DeepSeek很可能希望这一版本在保持强大能力的同时,兼顾响应速度和推理效率——"Flash"通常暗示着轻量化、快速响应的产品定位,类似Google Gemini Flash的命名逻辑。在Gemini产品线中,Flash版本通常以牺牲少量极限能力为代价,换取数倍的推理速度提升和大幅降低的调用成本,面向高吞吐量的生产环境场景。这种产品策略反映了行业的一个重要趋势:在模型能力逐渐趋同的背景下,推理效率和部署成本正在成为决定模型商业竞争力的关键因素。
DeepSeek V4-1 Flash为何值得关注
推理成本与模型性能的再平衡
DeepSeek一贯以"性价比"著称。此前的DeepSeek V3、R1等模型,都以远低于国际同行的训练与推理成本,实现了具有竞争力的性能表现,一度引发资本市场对AI算力投入合理性的重新审视。
DeepSeek能够持续实现低成本的背后,有多重因素支撑。其母公司幻方量化(High-Flyer)本身是国内顶尖量化对冲基金,拥有大规模自建算力基础设施,据报道其GPU集群规模超过万卡级别,这使得训练成本中的硬件租赁费用被大幅摊薄。更关键的是,DeepSeek在训练工程层面进行了大量底层创新,包括FP8混合精度训练(将部分计算从FP16/BF16降低到FP8精度,在几乎不损失模型质量的前提下将计算效率近乎翻倍)、高效的通信优化策略(如DualPipe流水线并行,减少多卡训练中的通信开销和流水线气泡)等,将硬件利用率推向极致。这种工程优化能力在当前国际地缘政治背景下具有特殊意义——面对先进芯片获取受限的现实,通过软件和算法层面的极致优化来弥补硬件代际差距,DeepSeek展示了一条"以智补力"的可行路径。
V4-1 Flash延续了这一思路:MoE架构 + Flash定位,直指"高性能、低成本"这一行业痛点。如果实测性能符合预期,它很可能再次改变开发者对模型选型的成本预期。
开源生态的持续贡献
DeepSeek过往多款模型均采取了相对开放的策略,为全球开发者社区提供了宝贵的技术资源。如果V4-1 Flash同样开放权重或提供友好的调用方式,将进一步巩固其在开源大模型生态中的地位,也为学术研究和中小企业应用降低门槛。
当前全球开源大模型生态呈现出明显的多极格局:Meta的LLaMA系列占据基础模型的主导地位,阿里的Qwen系列在中文场景表现突出,Mistral AI在欧洲市场持续耕耘。DeepSeek通过开放模型权重并采用相对宽松的许可协议,已经成为开源社区中不可忽视的重要力量。开源策略的价值不仅在于赢得社区好感,更在于构建技术生态壁垒——当大量下游应用、微调模型和工具链基于DeepSeek架构构建时,其技术标准和设计理念就会成为事实上的行业基准,形成强大的生态锁定效应。Hugging Face平台上DeepSeek相关模型的下载量和衍生模型数量,已经充分证明了其生态影响力。
DeepSeek的技术路线与竞争格局定位
DeepSeek的崛起深刻改变了全球大模型竞争格局。在V4-1 Flash之前,DeepSeek已经通过V2的MoE创新、V3的工程效率突破、R1的强化学习推理能力,形成了差异化的技术路线。与OpenAI侧重闭源商业化、Google依托搜索和云服务的全栈基础设施、Anthropic聚焦AI安全与对齐研究不同,DeepSeek走出了一条"极致工程效率+开放生态"的独特路径。这条路径的核心竞争力在于:通过底层训练框架和模型架构的联合优化,在相同算力预算下榨取更高的模型能力上限,然后通过开源策略快速建立社区影响力和生态规模。这种模式对资源相对受限的中国AI企业具有重要的参考意义,也为全球AI产业的降本增效提供了有力的证明样本,证明了前沿AI研究并非只能走"算力军备竞赛"的单一道路。
理性看待:仍需等待实测验证
补充一点,目前关于V4-1 Flash的信息主要来自社区的初步传播,具体的基准测试成绩、实际推理成本、开源许可细则等关键数据仍有待官方进一步披露和第三方独立验证。
552B参数与百万上下文的组合固然亮眼,但真实场景下的表现——包括长上下文的实际有效利用率(是否存在"Lost in the Middle"等信息衰减问题)、多模态任务的准确性(在细粒度图像理解、复杂图表解析等任务上的表现)、以及推理延迟(首token延迟和生成吞吐量的实际数据)——才是检验模型价值的最终标准。此外,MoE架构虽然降低了计算成本,但其较大的总参数量对显存和存储的需求依然不容忽视——552B参数即使以FP8精度存储也需要超过550GB显存,这意味着本地部署至少需要多张高端GPU的集群配置,对于资源有限的团队而言仍是不小的门槛。量化压缩(如GPTQ、AWQ等方案)可以在一定程度上缓解这一问题,但量化带来的精度损失及其对MoE路由质量的影响仍需要仔细评估。建议开发者在官方技术报告和更多实测数据发布后,再做全面评估。
无论如何,DeepSeek的每一次发布都在为国产大模型注入新的想象空间。V4-1 Flash是否能再次"搅动市场",值得我们持续关注。
核心要点
核心要点
相关推荐

GitHub日报·11月04日: Agent 生态大爆发,技能包与记忆层成新战场

My precious RAM:内存条被咬下主板引热议
Reddit热帖“My precious RAM”记录了一条内存条被从主板上咬下来的意外事故。本文还原事件、分析传播点,并给出硬件安装与防护的实用提醒。

深入PostgreSQL内核:一本免费开源的数据库原理指南
《The Internals of PostgreSQL》是一本免费在线书籍,系统讲解PostgreSQL的进程架构、存储布局、查询处理、MVCC并发控制和WAL日志机制,适合DBA和后端工程师深入理解数据库内核原理。