DeepSeek V4.1 Flash深度解析:编码器架构如何把推理成本压到几分钱
DeepSeek V4.1 Flash以混合编码器架构将推理成本压至约0.27美元,同期OpenAI千年难题突破与Mistral巨额融资引发行业热议。
本文围绕DeepSeek V4.1 Flash的发布展开技术拆解:该模型采用前20层因果编码器加后20层解码器的混合架构,叠加KV缓存从3500字节压缩至890字节的优化,实现每任务约0.27美元的极低成本,在Artificial Analysis基准上超越前代Pro版本。实测中其与GLM 5.3 Flash势均力敌,前者代码质量略优。文章同时梳理了本周三大热点:OpenAI以万个智能体88小时为纳维-斯托克斯方程找到反例,却因涉嫌提前接触研究者Codex对话内容而陷入学术伦理争议;Anthropic CEO呼吁放缓前沿竞速,以递归自我改进风险为由提出外部审计与国际协调,但博主认为其动机与监管俘获利益挂钩;Mistral完成欧洲科技史最大融资超30亿美元,却因转向提供中国开源模型引发主权质疑。博主核心观点:开源小模型已足以承担大量商业工作,真正的"主权"在于本地推理能力而非模型研发。
本周AI圈最值得关注的事件,莫过于DeepSeek再度出手,推出了V4.1 Flash模型。它凭借一套全新的高效架构,在保持高智能的同时,把运行成本和速度都拉到了一个令人咋舌的水平。本文基于一位法语AI博主的实测与技术拆解,梳理这款新模型的核心突破,并延伸讨论本周OpenAI攻克千年数学难题引发的争议、Anthropic呼吁放缓前沿以及Mistral创纪录融资等热点。
DeepSeek V4.1 Flash:更小、更便宜、更快
DeepSeek的发布节奏一向稀疏,但每一次都举足轻重——它往往为中国开源模型市场设定新标准。发布之后的数月内,GLM、Kimi等竞争对手通常会吸收其架构创新,通过蒸馏云端数据应用到自家模型上。
从技术参数看,V4.1 Flash在Artificial Analysis基准上拿到40分,紧随GLM 5.3 Flash之后,同时超越了DeepSeek此前最强的V4 Pro(包括月初发布的版本)。换句话说,这是一个体积更小、运行更省、性能却更强的模型。
最惊人的还是每任务成本。据博主测算,多数云端模型完成一项任务的成本约在8美元,前沿模型约5美元,而DeepSeek只需约0.27美元(约几毛人民币)。这让它稳坐市场最便宜模型的位置。
实测对比:DeepSeek vs GLM 5.3 Flash
博主设计了一个颇有巧思的"元演示"实验:让AI直接在他的生产环境网站上,生成一个动态讲解DeepSeek新架构创新的页面,要求视觉化、交互性强、内容详尽,并自行验证渲染效果后发布。整个任务在极简的PiAgent框架(只给智能体终端工具)上运行。
DeepSeek完成这项任务的花费约0.3欧元,而GLM 5.3 Flash速度更快、但成本无法精确统计。
两个模型的产出都相当出色。GLM生成的页面从引言的共情式文案,到从原始论文精准提取的配图、逐层可视化的动画模拟器,博主给出了"9分"的评价,并透露它已成为他日常的主力模型。DeepSeek的产出同样亮眼,甚至主动为网站新增了侧边导航栏,代码质量略胜一筹,只是图示的教学性稍逊。
博主的结论是:两款模型"势均力敌"——DeepSeek在代码质量上略优,GLM在语言智能上略强。而真正的核心信息在于:既然开源模型只需几分钱、能部署在欧洲服务器上、还有更快的token吞吐,为何还要为ChatGPT、Claude这类订阅每月支付200欧元?他认为,即便是入门级模型,如今也足以承担商业提案、客服、建站等大量第三产业工作。
架构揭秘:编码器回归带来的效率革命
要理解V4.1 Flash为何如此省钱,必须打开引擎盖看架构。
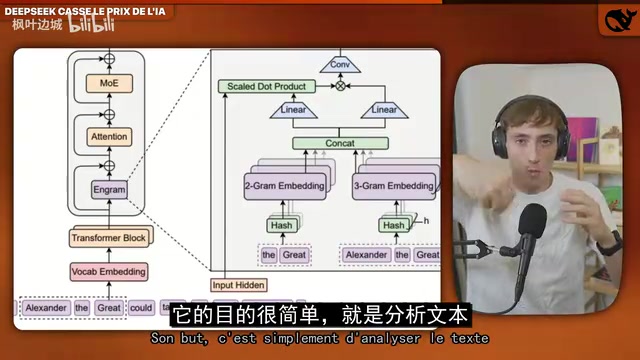
通常的大模型是"仅解码器Transformer"(Decoder Only),它只分析前文、预测下一个词,每预测一个词都要经过全部层。而Transformer最初的经典论文其实是"编码器-解码器"结构(Encoder-Decoder),比如早期Google翻译就是用编码器处理法语、解码器输出英语。后来业界普遍抛弃了完整的编码器-解码器结构。
DeepSeek的做法是把编码器请了回来。据博主拆解,模型共40层:前20层是因果编码器,仅用于理解句意,只激活80亿参数;后20层是解码器,用于预测下一个词,激活160亿参数。仅这一改动,粗略估算就带来约25%的推理提速——因为要做的计算少了约四分之一。
更关键的是显存优化。他们在KV缓存(每个token用于与后续token比较的键值)的存储上做了大量创新:在不同层之间交替,有些阶段精确索引所有token,有些阶段大幅减少索引并复用先前计算。结果是每个token的存储量从上一代的3500字节降到仅890字节。
这意味着,存储一段100万token的对话,现在只需不到1GB内存,而以往更大的模型至少需要3.7GB。由于RAM极其昂贵,这一改进直接大幅压低了推理成本,DeepSeek也据此再度下调了价格。
KV缓存(Key-Value Cache)是理解这一优化的关键概念。在Transformer的注意力机制中,每个token在生成时需要与序列中所有前置token进行相关性计算,这要求为每个token存储一对"键"(Key)和"值"(Value)向量。随着上下文长度增加,这些向量的总存储量线性膨胀,是大模型推理显存占用的主要来源之一。以往模型为了维持精确的注意力,需要在每一层都保留完整的KV对;DeepSeek V4.1 Flash的创新在于通过层间交替策略,让部分层共享或复用先前层的KV计算结果,而非重新计算,从而在精度损失极小的前提下,将每token的缓存体积压缩到原来的约四分之一。这一优化对于长上下文场景(如处理长文档或多轮对话)的成本降幅尤为显著,也是其定价能远低于同等能力竞品的核心工程原因。
OpenAI攻克千年难题:荣耀还是掠夺?
DeepSeek之外,本周另一大事件充满争议:OpenAI宣布用1万个AI智能体、耗时88小时,为纳维-斯托克斯方程(Navier-Stokes,克雷数学研究所七大"千年难题"之一)找到了一个反例。
这道自1845年以来天天被工程界使用、却从未被严格数学证明的方程,其求解有两条路——要么证明它在所有情况下都成立,要么找出一个反例。OpenAI选择了后者,通过施加外力让流体旋转形成涡旋,涡旋中心收缩拉伸,速度趋于无穷而黏性失控,从而出现奇点。也就是说,答案"很可能是否定的"。
争议不在于结果对错,而在于科研方式的颠覆。据博主梳理:两位研究者Tristan Buckmaster与Levent(Anthropic员工)已就同一思路(强制奇点)钻研近一年,8月15日在欧拉方程上找到奇点,写成245页论文却尚未发表。OpenAI闻风后于9月1日启动万个智能体,几天内就抢先给出更复杂方程的反例。
更微妙的是,两位研究者在研究过程中一直用Codex测试模拟,意味着OpenAI理论上能接触到他们的全部研究内容。OpenAI先承认"模型可能匿名地在这些内容上训练过",几小时后又改口称"绝无此事",反而显得更可疑。此外,OpenAI只邀请Buckmaster合作发论文,却拒绝纳入来自竞争对手Anthropic的Levent,引发公开指控。
博主指出,这暴露了一个博弈论困境:只要研究者继续与AI对话求解,实验室就掌握了他们的全部思路,从而可能凭借远超对手的算力抢先"证明"。长此以往,没人再有动力分享。尽管如此,一个四年前连巴黎是哪国首都都答不出的AI,如今能完成此类推导,本身确实令人震撼。
纳维-斯托克斯方程(Navier-Stokes Equations)由法国工程师纳维和英国数学家斯托克斯分别于19世纪建立,是描述黏性流体(如水、空气、血液)运动的一组偏微分方程,至今广泛应用于航空动力学、天气预报、海洋建模等领域。其"千年难题"版本的核心问题是:在三维空间中,给定合理的初始条件,方程的光滑解是否永远存在且有界(即不会在有限时间内出现速度趋于无穷的"奇点")?这一问题的难点在于,流体的湍流行为极度复杂,现有数学工具难以同时处理非线性项与能量耗散之间的相互作用。克雷数学研究所为此悬赏百万美元。OpenAI此次的工作并非"证明方程成立",而是通过构造特定的外力条件,演示了方程在某种情形下可能产生奇点,即给出一个反例——若该结果经同行评审确认,意味着方程在最一般意义上不具备全局光滑解,将从根本上改变数学界对流体模拟极限的认知。
Anthropic呼吁放缓、概念空间训练与Mistral融资
本周还有几条值得留意的动态。
Anthropic CEO Dario Amodei发文《We must pause the frontier》,呼吁放缓前沿模型竞速。理由有二:一是递归自我改进正在显现——他称如今超过90%的下一代Claude模型由前代模型设计,一旦跨过这道门槛,改进速度可能快10到20倍,直到人类再也读不懂这些创新;二是他对OpenAI相关安全事件的担忧。他提出三条措施:在每个实验室嵌入外部审计员、呼吁各民主国家协调标准、以及与中国就自我改进速度达成全球协调。
博主对此持保留态度,认为后两点在地缘政治上几乎不可行,而制造恐惧叙事恰恰服务于这类公司的商业模式——因为它们缺乏真正的护城河,随时可能被开源实验室以极低成本追上,监管俘获才是其真正的竞争优势。
研究层面,一篇名为"NCP Arc Preview"的论文提出:不仅训练模型预测下一个token,还增加一个预测"下一个概念"的训练目标。具体做法是将token按4×4分组,映射为概念向量(由32段、每段128维表示),在训练时先预测下一个概念、再据此引导token预测。相比传统因果训练只训练token预测、寄望逻辑"顺带"提升,这种方式显式训练逻辑相关性,为提升模型创造力提供了新思路。
最后是资本大事:法国Mistral完成D轮融资,金额超30亿美元、估值超210亿,由三星领投,BlackRock、卢森堡基金、ASML与英伟达跟投,创下欧洲科技史最大融资纪录。争议在于Mistral近期开始在平台上提供中国开源模型、更像推理服务商而非前沿实验室,被质疑背离了"法国主权模型"的初心。
博主对此看法务实:真正的主权在于"本地拥有推理能力"——即在法国建设数据中心,就像掌握自己的能源基础设施一样掌握智能基础设施。企业客户真正需要的,是通过微调小模型、以百倍更低的成本、在符合GDPR的欧洲服务器上跑生产级工作流(如客服工单分类路由)。这正是Mistral的营收所在,也是其商业逻辑成立的关键。
"递归自我改进"(Recursive Self-Improvement)是AI安全领域长期讨论的核心风险场景之一:若一个AI系统能够设计出比自身更强的后继版本,而后继版本又能设计出更强的下一代,改进速度就会呈指数级加速,直至超出人类理解和控制的范围。Dario Amodei声称90%以上的下一代Claude已由前代模型参与设计,意味着这一循环已初步形成闭环。这与AI安全研究者此前描述的"智能爆炸"(Intelligence Explosion)场景高度吻合。值得注意的是,"递归自我改进"是否真正意味着不可控加速,学界存在较大分歧——反对者认为,模型设计本身仍受算力、数据和人类审查的硬约束,不会自发突破这些瓶颈;支持者则认为,一旦模型能够自主优化训练目标本身,外部约束的效力将大幅削弱。这也是Amodei呼吁引入外部审计的技术背景。
相关推荐
厦门大学AI编程课落地实践:从教材到教学的全解析
厦门大学林子雨副教授分享《AI编程与智能体开发》课程建设实践,涵盖AI编程三段演进、Claude Code生产级拐点、三种编程方法论及教材设计,详解免费可复现的高校教学落地方案。
DeepSeek研究员自白:亲手训练的AI即将取代自己
DeepSeek V4.1核心算子编写者刘胜宇发文自白:亲手训练的AI最快半年到一年将取代自己写算子的能力。他为何仍坚持优化模型?又为何担忧AI把世界推向赛博朋克式极端并选择开源?
n8n 自动化实战:AI 工作流如何为中小企业降本增效
本文基于一线从业者的实战分享,讲解如何用 n8n 与 AI 工具构建工作流自动化,涵盖多平台消息聚合、AI 自动回复、批量数据录入与智能校验,帮助中小企业降本增效。