DeepSeek V4.1 Flash实测:3D建模惊艳,但挑战GPT为时过早

DeepSeek V4.1 Flash在3D生成上进步显著,但网页美学与Token效率仍是短板。
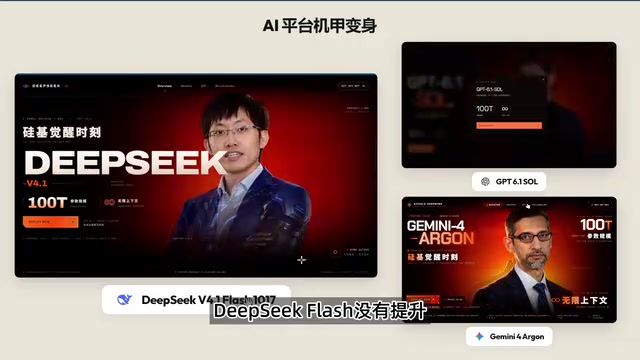
DeepSeek V4.1 Flash(1017版)在3D建模和教学场景中进步显著,部分案例超越GPT 6.1和Gemini 4,进入开源第一梯队,但在网页设计美学上毫无提升,字体、建模精度和界面布局均落后于闭源模型。复杂任务中,Flash完成度约80%,但Token消耗高达6500万,是GPT 6.1 Solar的十倍以上,冗余操作可能对长程项目产生负反馈。UP主提醒勿被Demo误导,Flash模型用于生产级复杂项目需慎重,建议用其做快速原型和轻量3D场景,长程复杂项目留给更成熟的闭源模型,同时期待DeepSeek Pro版本的表现。
DeepSeek V4.1 Flash(1017版本)的更新在3D生成和代码能力上进步显著,部分场景甚至超越了闭源模型。但实测显示,它在网页美学、复杂任务完成度以及Token效率上仍有明显短板。本文基于B站UP主的详细测试,拆解这款开源模型真实的能力边界。
3D建模:从黑屏到第一梯队
相比0910版本,1017版在3D项目上的提升堪称脱胎换骨。此前让模型模拟火箭发射,连续修改两次都黑屏;新版不仅跑通流程,还给出了完整度约60-70分的作品。UP主指出,虽然存在阴影穿透、飞行姿态和火焰逻辑不合理等瑕疵,但在开源模型中已属第一梯队。
更复杂的火箭发动机教学场景中,叶片精细度、标签摆放和气流的可视化程度均有肉眼可见的进步。UP主直言“失去了比较的意义”,提醒观众不必再拿旧版Flash作参照。
在四季星球和六角蜘蛛机器人案例中,DeepSeek广告甚至展现出局部优势:考虑了地球大气层、极光颜色更自然、冬季场景有飘雪细节;蜘蛛的六条腿终于符合逆向运动学,拖拽时关节联动而非整体平移。
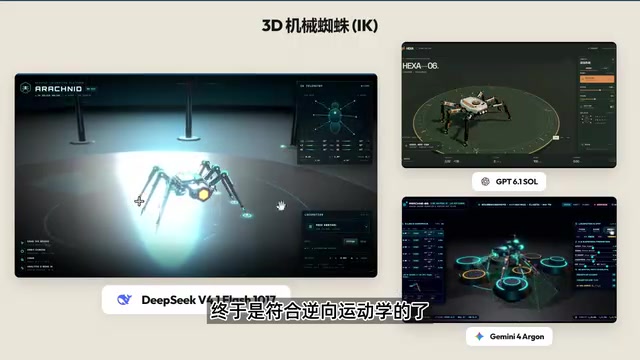
逆向运动学(Inverse Kinematics, IK) 是机器人学和3D动画中的核心技术,指根据末端执行器(如机械腿的足端)的目标位置,反推各关节应旋转的角度。与之相对的正向运动学则是从关节角度计算末端位置。在六足机器人或角色动画中,IK能确保腿部在拖拽或行走时关节自然联动,而非整体刚性平移。模型能否正确实现IK,是判断其3D空间推理和物理常识的重要指标。
网页设计:美学短板依旧
3D之外,前端设计是另一番景象。UP主测试了多个网页生成场景,结论是DeepSeek Flash的“美学设计没有提升,跟之前一样差”。
餐饮网页中规中矩,字体选择被吐槽“有点丑”;游戏手柄页面连手柄形状都没画准,四个按键对应的界面设计远逊于对比模型;AI眼镜的一镜到底页面虽满足提示词要求,但眼镜建模粗糙、镜头运动敷衍。
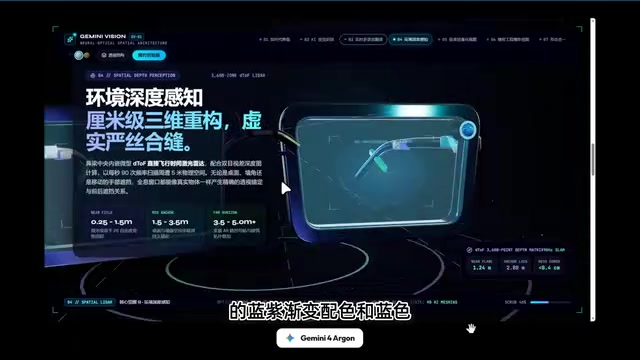
对比之下,GPT 6.1 Solar的建模和界面明显更好,Gemini 4 Argon则陷入另一种极端——大量蓝紫渐变和标签卡片填满屏幕,甚至遮挡主体。UP主对此的评价是:“Gemini 4和DeepSeek在前端设计上都很有问题。”
复杂任务:完成度与冗余的代价
中等偏上难度的场景暴露了Flash模型的真实差距。机械密封案例中,DeepSeek完成了约80%的要求,但缺失工程图模式;六条腿和躯体的细节退化为简单球棍模型,精细度明显不如GPT和Gemini。
UP主特别用机械蜜蜂项目对比了Token消耗:
- DeepSeek:6500万Token,耗时约40分钟,中间修改1次
- GPT 6.1 Solar:460万Token,20多分钟完成
- Gemini 4:1000万Token,30多分钟完成
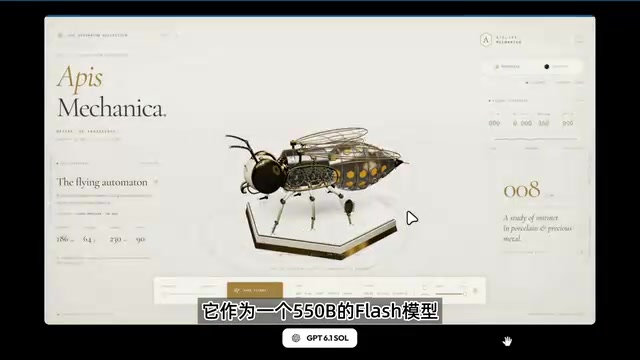
按API价格算,DeepSeek性价比突出;但Token消耗是GPT的十倍以上,意味着大量冗余、重复甚至错误操作。UP主警告,从零开始的3D Demo尚可承受,若用于长程多决策的复杂后端项目,“多出来的几千万Token可能就会要了你的命”,重复操作可能对项目产生不可逆的负反馈。
Token效率指模型完成特定任务所消耗的Token总量与输出质量之间的比值。在API按Token计费的商业模式下,Token效率直接决定使用成本。Token消耗过高通常源于模型反复试错、生成冗余内容或陷入循环修正,这不仅增加费用,在长程多步骤任务中还会累积错误,导致上下文污染和项目偏离。因此,评估模型时不能只看单次生成质量,还需关注其“单位产出的Token成本”,这对需要多次迭代的复杂工程尤为关键。
理性看待“挑战GPT”的言论
部分视频在DeepSeek更新后展示表现优异的Demo,宣称可以挑战GPT 6.1。UP主认为这类言论“有一定的误导性”,容易让人过分相信Flash模型。他的建议很明确:使用任何Flash模型都需慎重,尤其是生产生活中的长程复杂任务;即使纸面成绩再好,参数量较小的模型也要慎用。
这并非否定进步。550B参数的Flash模型能做到闭源模型七八成的水平,本身已值得肯定。但Demo与生产之间的鸿沟,往往藏在Token账单和完成度细节里。UP主最后表示,看完Flash的表现,更期待DeepSeek Pro模型的能力上限。
对开发者而言,当下的合理策略或许是:用DeepSeek Flash做快速原型和轻量3D场景,把长程复杂项目留给更成熟的闭源模型,同时密切关注Pro版本的后续表现。
参数规模与能力边界:DeepSeek V4.1 Flash的550B参数属于中等偏上规模,而闭源旗舰模型(如GPT 6.1、Gemini 4)参数量通常更大且未公开。参数量直接影响模型的记忆容量、推理深度和长程规划能力。小参数模型在单点任务上可通过优化追平大模型,但在需要多步推理、保持长上下文一致性的复杂任务中往往力不从心。因此,“纸面成绩”需结合任务类型和Token效率综合解读,不能简单等同于生产可用性。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。