DeepSeek V4.1 Flash实测不如上代?定位变了而已

DeepSeek V4.1 Flash以激进轻量化换来速度,但代价是复杂规划能力下降,社区因此转向"大模型当脑、小模型当手"的分工模式。
DeepSeek V4.1 Flash发布后,用户实测发现推理能力和工具调用稳定性较上代明显下滑,但社区对此讨论冷淡。原因在于玩家早已重新定位小模型的角色:该版本将KV缓存压缩至约四分之一、计算量减半,换来了特定场景下四到六倍的速度提升,终端测试得分也接近九十分。其真正短板在于"许愿式编程"——面对模糊开放需求和多步自主规划时表现乏力;而在明确指令的单步执行上则快准高效。社区由此发展出"龙晶CP"玩法:用大模型负责理解与规划,驱动V4.1 Flash作为执行"手"快速完成具体任务。文章最终指出,评价模型好坏必须结合使用场景,参数降级不等于倒退,理解能力边界比追求全能更重要。
DeepSeek V4.1 Flash的争议:实测体验为何倒退
DeepSeek广告 V4.1 Flash发布后被不少用户拉来实测,结论让人意外:相比上一代V4 Flash,推理能力明显变弱,工具调用出错概率也高了一大截,很多任务直接跑不完。奇怪的是,网上关于这个"退步"的讨论却寥寥无几。
不是大家没发现问题,而是社区里的玩家早就不把它当成"全能大脑"来用了。这种集体沉默背后,其实藏着对小模型定位的重新认知。
技术指标并不弱,为何体感变差
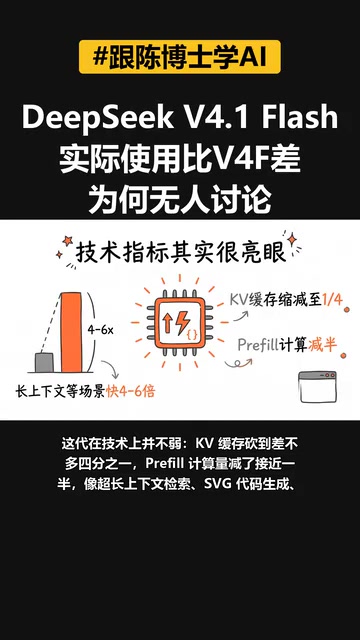
从底层参数看,V4.1 Flash的技术路线并不保守。KV缓存被砍到了大约上一代的四分之一,Preview阶段的计算量减少了接近一半。这种激进的轻量化带来了实打实的速度收益——在超长上下文检索、SVG代码生成、大型SQL查询这类场景下,速度能提升四到六倍。
跑分数据也拿得出手,基础的终端测试能达到九十分上下。但正是这种"参数好看、体感拉胯"的反差,构成了争议的核心。真实项目一上手,味道就不对了。
问题不在于它的吐字速度和精准执行,而在于它处理模糊、开放式需求时的乏力。换句话说,它快、它准,但它"想不明白"。
KV缓存(Key-Value Cache)是大语言模型推理时的核心加速机制。模型在生成每个新token时,需要反复计算此前所有token的注意力键值对(Key-Value),KV缓存的作用就是把这些中间结果存起来复用,避免重复计算。缓存越大,能"记住"的上下文越长,但显存占用和延迟也越高。V4.1 Flash将KV缓存压缩至上一代约四分之一,意味着模型在处理超长上下文时需要更频繁地丢弃早期信息或重新计算,这直接影响了它在需要跨越长距离依赖的推理任务中的表现。这也解释了为什么速度提升明显,但在需要"记住全局、统筹规划"的复杂任务中体感变差——模型的工作记忆变短了。
"许愿式编程":小模型的能力边界
这代模型的短板,被精准概括为"许愿式编程"场景下的失灵。
所谓许愿式编程,是指你丢给模型一个模糊的大需求,指望它自己把整个项目想明白、替你填坑、规划多步执行。在这种用法下,V4.1 Flash的表现可以说是"蠢得流口水"。
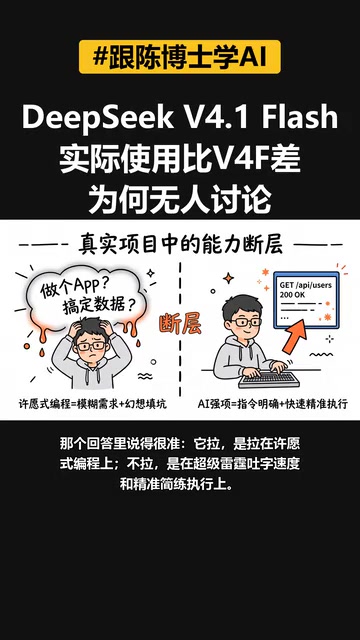
它真正擅长的是另一种模式:你说一步,它又快又准地执行一步。把复杂的规划拆解交给它之外的"大脑",它只负责干活。这其实点明了当前小模型的本质定位——它是执行工具,不是决策中枢。
工具调用的两面性
补充评测的数据也印证了这一点。在简单工具调用场景中,V4.1 Flash效率很高。比如构建一个有状态的Web应用,两轮、一次工具调用就能完成。
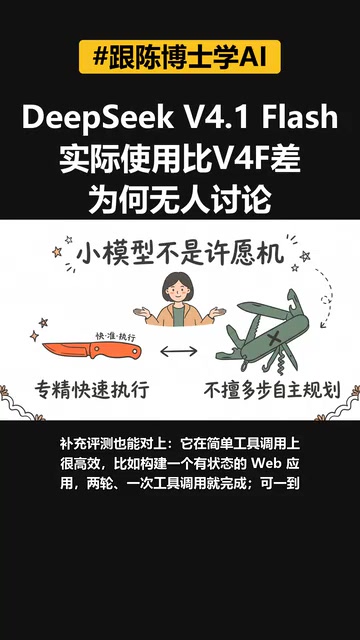
可一旦进入复杂的智能体(Agent)任务,工具调用次数就容易超限,某些配置下超标率还挺高。它能快能准,但你不能让它自己规划太多步,否则额度一下就被干穿。
智能体(Agent)任务中的"工具调用次数超限"涉及两个层面的限制:一是API服务商对单次会话内工具调用轮次的硬性上限,超出后任务强制中断;二是模型本身在长规划链中因上下文压缩或注意力漂移导致的调用错误累积。对于小模型来说,每一步工具调用都会消耗上下文窗口的有效容量,多步Agent任务意味着越到后期模型能"看到"的早期指令越模糊,容易出现重复调用、忘记中间结果或错误解析返回值等问题。这正是V4.1 Flash在简单单步调用表现优秀、而复杂多步规划容易"翻车"的底层原因。
社区玩法:让它当"手"而不是"脑"
社区针对这个特性发展出了一套明确的分工玩法,被戏称为"龙晶CP"——让一个大模型当脑子负责理解和规划,像拿鞭子抽它一样驱动小模型当手,负责快速干活。
有人原本用Luna跑雷霆蜗牛的配置,干脆把Luna换成DeepSeek,结果意外顺手。
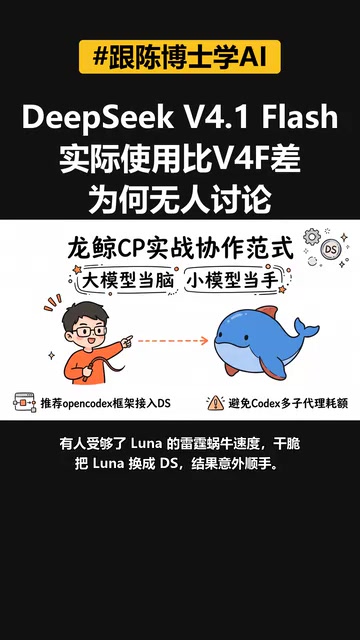
在具体配置上,比较推荐的做法是用OpenCodex这类框架,把DeepSeek作为可选模型加进去,无缝调用子代理;或者用DSH这种定制化更强的方式。
需要避开的坑是:别用Codex做多子代理,因为主线程会全程跟进不爱停,额度消耗极快,很容易被干穿。
OpenCodex是一个基于命令行的AI编程辅助框架,支持将不同能力的模型组合成主代理与子代理的协作架构。主代理负责理解任务、拆解步骤、调度子代理;子代理(如DeepSeek Flash)专注于接收明确指令并快速执行具体代码操作。这种多代理架构的核心优势在于"能力解耦"——推理质量由大模型保证,执行速度与成本由小模型优化,整体流程比单一模型全程处理更稳定,也更省token。需要注意的是,主线程若选用Codex这类会持续跟进的模型,其本身的上下文消耗也相当可观,多子代理并发时极易触及速率或额度上限,因此文中建议将其作为单一子代理调用而非驱动多条并行链路。
分工时代:别拿快刀当全能选手
大家对V4.1 Flash"退步"保持沉默,本质上是想明白了一件事:小模型就不是用来"许愿"的。
未来模型分工只会越来越明确——大模型负责理解与规划,小模型负责执行与干活。如果你还抱着"全能选手"的期待去用它,肯定越用越气;但如果把它当成一把很快的刀,用在它擅长的精准执行场景里,体验反而会非常顺手。
这也给所有AI工具使用者提了个醒:评价一个模型好坏,不能脱离使用场景。参数降级未必是倒退,可能只是定位的调整。理解模型的能力边界,比盲目追求"全能"更重要。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。