DeepSeek V4.1 Flash实测:开源模型逼近闭源旗舰
DeepSeek V4.1 Flash 1017以极低成本实现智能体编程与3D生成大幅跃升,但速度与质量仍非全面领先。
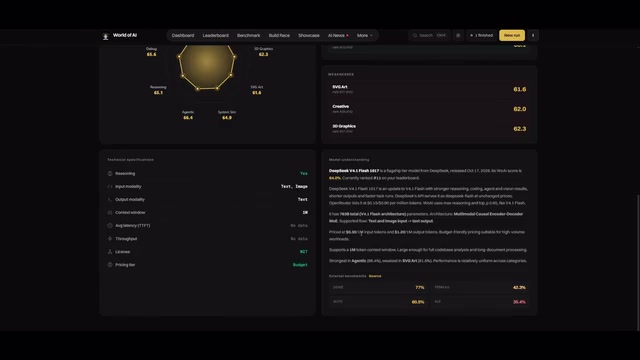
DeepSeek推出V4.1 Flash 1017版本,定位为同成本下的帕累托改进。官方基准显示Terminal Bench 4.0从31.2%升至42.3%,超过GPT-5.6 Sol,HLE推理从36.8%升至42.6%;定价为输入0.30美元、输出1.20美元每百万token,支持100万token上下文。模型重点转向智能体编程,采用带自反馈的强化学习,并开放搜索与抓取API(每千次0.75美元)。实测速度约244 token/秒,3D生成与前端开发进步显著。横向对比显示其成本常低数倍至数十倍,但耗时长、部分功能需多轮提示,适合预算敏感、可接受等待的团队。
DeepSeek在沉寂一段时间后推出了V4.1 Flash(1017版本),官方将其定位为一次"帕累托改进"——在同等或更低成本下实现更好的性能。据B站UP主WorldofAI的完整实测,这款模型在终端编程、3D生成和前端开发等任务上表现出色,部分指标甚至超越了GPT-5.6 Sol等闭源旗舰。但它并非全新架构,而是9月10日发布的V4.1 Flash的迭代升级,过去两个月里DeepSeek已对该系列进行了多次打磨。
性能跃升:基准测试与成本控制
从官方公布的基准来看,进步幅度相当可观。在Terminal Bench 4.0上,得分从31.2%提升至42.3%,超过了GPT-5.6 Sol的39.9%;在DeepSafe 1.1上拿到77%,据DeepSeek广告社区对比数据,这一成绩领先于GPT-5.6 Sol、Claude Opus 5和GLM 5.3。HLE推理测试则从36.8%提高到42.6%,显示出推理能力的明显增强。
定价方面,该模型输入为每百万token 0.30美元,输出为每百万token 1.20美元,支持100万token上下文窗口。WorldofAI评价称,这使其成为当前最好的开源模型之一,但模型体量过大,实际上无法在本地运行。在WorldofAI自建的基准测试中,该模型综合排名约第10至11位,虽未进入前十,但在智能体编程能力上表现突出。
Terminal Bench 4.0 是一个面向终端环境(命令行)的智能体编程基准,测试模型能否在真实 shell 中完成文件操作、脚本编写、依赖安装、调试排错等多步骤任务,评分通常以任务通过率计。与偏重函数级代码补全的 HumanEval 类基准不同,它考察的是长程规划、工具调用与错误恢复能力,因此更贴近"端到端完成项目"的实际使用场景。
HLE(Humanity's Last Exam) 是由学术与产业界联合构建的高难度跨学科试题集,覆盖数学、物理、人文等领域的专家级问题,设计初衷是提供在现有基准趋于饱和后仍具区分度的评测。其题目多为多步推理与冷门知识结合,模型得分普遍偏低,因此从 36.8% 到 42.6% 的提升在绝对值上并不算小。
智能体能力:从写代码到完成项目
DeepSeek此次将重点放在智能体编程和项目开发上,采用带自反馈的强化学习来提升模型完成完整项目的能力——无论是生成游戏、构建应用还是3D建模任务。WorldofAI指出,这一转变意义重大:模型不再只是生成基础代码,而是能端到端完成复杂开发流程。
配套动作是DeepSeek开放了搜索与抓取API,由其自建搜索基础设施支撑,官方称可处理全球每日数亿次请求,两个端点均按每千次调用0.75美元计费。通过CloudCode、Codex或DeepSeek Harness等服务端工具发起的搜索与抓取调用,在10月31日16:00 UTC前免费。UP主建议搭配Harness使用,认为这是发挥该模型能力的最佳组合,因为Harness围绕DeepSeek模型优化了工具调用、上下文管理和代码执行,让模型能持续测试、识别错误并迭代输出。
带自反馈的强化学习(self-feedback RL)指模型在训练中生成完整解后,由执行环境或验证器给出可自动判定的反馈信号(如测试是否通过、程序能否运行、渲染是否成功),再据此优化策略,而无需人工标注每一步。相比只对最终答案做奖励的稀疏信号,这种范式让模型学会自我试错、定位错误并迭代修改,是当前提升智能体长程任务能力的主流路线之一。
实测表现:速度惊人,3D与前端出彩
WorldofAI在多个小时的高强度测试中发现,该模型速度极快,报告值约为每秒244个token,早期测试甚至接近每秒300个token。UP主称这可能比GPT-6.1 Sol的超快模式还快,而智能水平与GPT-5.6 Sol相当,部分基准甚至实现反超。
3D生成是进步最明显的领域。与两个月前的原版V4.1 Flash对比,新版生成的3D场景质量堪称"天壤之别"。在前端开发测试中,排版、动态效果、细微动画和滚动触发都相当流畅。一个360度产品查看器的输出质量被指"模仿了OpenAI的生成风格",UP主提到该模型在某些深度推理回答中会自称是OpenAI模型,引发了对蒸馏训练的猜测——他认为DeepSeek团队很可能蒸馏了OpenAI模型,但也强调这是各家模型提供商的普遍做法。
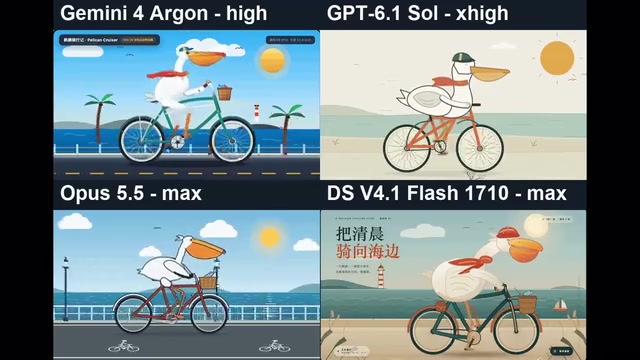
在鹈鹕骑自行车SVG的经典测试中,各模型均开启最高推理档位,Claude Opus在视觉风格上明显最佳,DeepSeek的输出质量尚可。另一项与Opus 5.5的对比里,Opus以更好的动画、音效和细节胜出,但DeepSeek仅花费0.23美元,而Opus花费6美元,成本相差约26倍;代价是DeepSeek耗时1小时,Opus只需20分钟。
体素艺术生成测试中,模型在单个文件中生成了超过200万个体素的中世纪王国场景,耗时约25分钟,API成本仅5美元,还支持昼夜循环和添加飞龙等侧栏功能。与GPT-6 Luna的3D特斯拉Roadster场景对比中,DeepSeek花费0.89美元,比Luna的1.07美元便宜约17%,但UP主认为Luna的输出质量略好。
模型蒸馏指用一个能力更强的大模型(教师)生成的输出或分布,去训练另一个较小的模型(学生),使其以更低成本逼近教师的表现。业界常用做法包括对教师生成的推理轨迹做监督微调,或用其输出分布做软标签训练。由于蒸馏依赖教师模型的输出,学生模型有时会继承教师的措辞习惯甚至自我身份表述,这也正是文中"模型自称是 OpenAI 模型"引发猜测的原因。需要说明的是,蒸馏本身是普遍且合规性存在争议但广泛使用的训练手段。
性价比突出,但并非全面领先
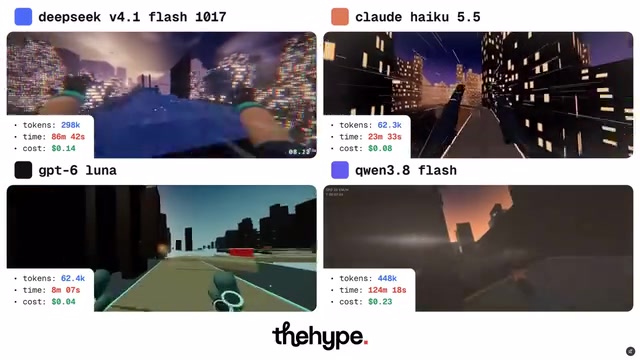
多模型横向对比揭示了更复杂的图景。在单HTML文件第一人称跑酷游戏测试中(4个阶段、1轮修复),DeepSeek的视觉效果被报告为最佳,成本0.14美元,但耗时1小时30分钟;而Claude Haiku只花8美分、用时更短,功能性反而更好。与GPT-6.1 Sol Ultra的对比中,DeepSeek成本便宜约90%(0.44美元),两者耗时相近,且DeepSeek能调用网络工具收集参考资料,这是构建复杂项目时的显著优势。
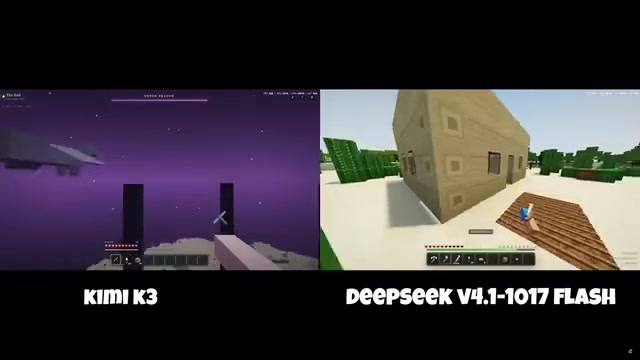
与Kimi K3的Minecraft沙盒对比最能说明取舍:Kimi耗时2.5小时、花费35美元,输出了更丰富的维度和图形质量;DeepSeek耗时1.5小时、仅花0.80美元,便宜近44倍,但许多功能实现上明显吃力,需要多轮提示才能接近。在SVG测试中,Gemini 4 Argon用13分钟、1.20美元完成,DeepSeek耗时50分钟、仅0.40美元,最终画面接近,部分水域细节甚至更好,但Gemini整体场景和速度更优。
更极端的案例是DeepSeek V4.1配合Hermes Agent调用Blender,耗时约7小时完成3D项目,成本仅1.83美元。UP主建议可以将此类长任务放在夜间运行。视频生成方面,模型表现同样不错,瓶颈主要在于素材生成耗时。
值得尝试,但需管理预期
WorldofAI的结论是,V4.1 Flash 1017是近期最令人印象深刻的Flash级模型之一,编程能力、3D生成和性价比都相当突出,目前可通过官方聊天免费试用。但它并不完美:速度有时偏慢,部分任务质量与顶级闭源模型仍有差距,需要多轮提示才能达到理想效果。对于预算敏感、能接受较长等待时间的开发者和团队来说,这款开源模型提供了一个极具吸引力的选项——用远低于前沿闭源模型的成本,换取接近的产出质量。
相关推荐
别急着让AI写代码:4个Skills把设计变成可执行任务
20年经验工程师分享:AI编程时代人类该专注设计与规划,而非写代码。用architecture.md锚定架构,配合设计、架构评审、HTML文档、规划四大Skills,把技术方案自动拆解为可执行任务,提升软件开发质量。
AI革命早期史:谷歌、马斯克与那场改变一切的竞赛
从谷歌收购DeepMind到ChatGPT的意外爆红,The Vergecast访谈Kevin Roose新书,揭秘AI革命早期那些改变世界的决定:谷歌为何错失先机、数据原罪如何形成、以及AGI定义之争。
恐怖模式下的Gmod TTT:吸血鬼与狼人新角色实测
Yogscast万圣节特别版Gmod TTT实测:吸血鬼转化机制、狼人银弹弱点、法国人法棍穿墙击杀,以及角色轮抽带来的策略变化。附对局中的平衡性反馈。