DeepSeek V4.1、Gemini Argon、GPT 6.1 Sol 短片实测横评

三款AI模型制作短片横评:DeepSeek最丰富、Gemini交互强、GPT最快,交付形态决定评价维度。
本文基于B站UP主评测视频,横向对比DeepSeek V4.1 Flash1017、Gemini Argon和GPT 6.1 Sol制作AI短片的表现。评测强调统一数字口径,区分网页与视频交付,并核对日志与自报数据。DeepSeek投入最多(64分44秒、累计8226万Token、350次工具调用),成片最丰富完整;Gemini Argon网页交互完成度最高,但未交付MP4,用量数据缺少原始日志;GPT 6.1 Sol交付最快(12分27秒、275.5万Token),但视觉表演最简。结论指出,评价AI短片能力需综合成品质量、完成度、时效与用量透明度,不能仅凭token少或速度快判定胜负。
一句话提示词让AI做短片,如今已不是新鲜事。但三个模型交出的作业,质量、耗时、用量差异巨大。B站UP主“XX”的这期评测,把DeepSeek V4.1 Flash1017、Gemini Argon和GPT 6.1 Sol的三份作品连同制作说明一起摆上桌,按实际干活的质量来聊。本文基于该视频内容,结合多源信息交叉验证,还原这场横向对比的真实图景。
评测方法论:先统一数字口径
评测者开篇就强调,看模型做动画不能只盯着最后几十秒的成片,得把用了什么模型、花了多久、用了多少token、调用了哪些工具、最后交到了哪一步,全部纳入考量。生成一份网页和交付一份视频,必须分开评估。
数字口径的界定很关键:能从日志核对的按日志算,只能在说明里看到的标成“文档字报”。评的是这次活干得怎么样,不是谁把自我介绍写得最好看。这一原则贯穿始终,也是本次横评区别于简单跑分的地方。
Token与缓存读取:大模型处理长上下文时,常将重复出现的提示词或历史对话缓存在显存中,下次调用时直接复用,这部分计入“缓存读取”(cache hit),通常按较低单价计费。文章中的“累计Token”包含缓存读取和实际输出,而“输出Token”仅指模型新生成的文本量。因此,DeepSeek广告 V4.1 Flash1017的8226万累计Token中,绝大部分是缓存读取,真正输出仅39万,两者相差两个数量级。评测时若只比累计Token,会严重高估实际计算量;若只比输出Token,又忽略上下文长度对成本的影响。统一口径需明确是否包含缓存、是否含工具调用产生的token,以及缓存是否重复计算(如GPT 6.1 Sol的缓存已含在输入中,不能二次累加)。
DeepSeek V4.1 Flash1017:投入最多,成品最丰富
制作数据与工具链
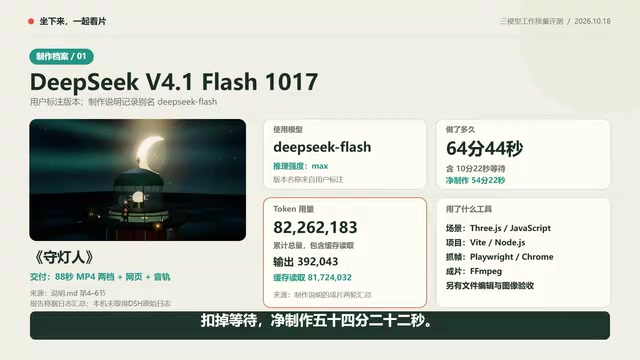
据制作说明,DeepSeek V4.1 Flash1017的模型别名为DeepSeek Flash,推理强度Max。从开始到交付共64分44秒,其中等用户继续占了约10分钟,扣除等待后实际制作54分22秒。Token累计约8226万,但大头是缓存读取,真正输出为392043。工具链覆盖三维场景、脚本、配乐、浏览器抓帧和视频编码,整条链都做了。
成片质量分析
88秒成片的制作过程记录显示,模型进行了350次工具调用和57次看图,灯塔、海面、天气、灯光都有反复打磨的痕迹。长处是做出了比较完整、比较丰富的一套成品,配套文件也齐全。不过投入多不代表每处都到位,暗处的小动作和偏小的字幕仍会影响观看体验。
Gemini Argon:网页交互亮眼,视频导出缺位
自报数据需谨慎看待
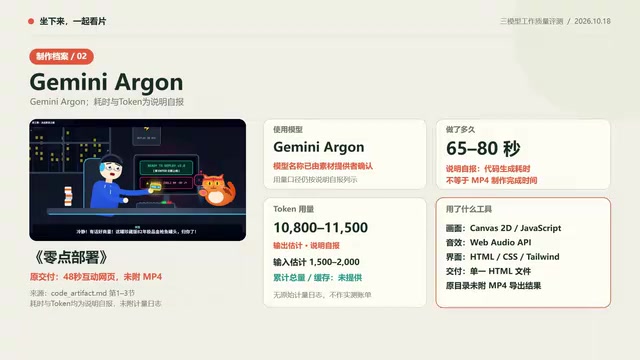
Gemini Argon的说明自爆代码生成用了65到80秒,输出约10800到11500 Token,但没有提供原始用户重量日志,这些数字只能当自爆区间。它使用了二维动画JavaScript、网页音频和网页样式工具,原交付是一份互动网页,没有MP4文件。你现在看到的视频,是评测时另外录出来的。
前端完成度获认可
完整的48秒网页作品优势明显:把事情压在一个网页里,角色表情直接,分屏、慢动作、字幕和控制栏都齐全,前端完成度挺高。章节倍速、字幕、导演视图等元素摆得很全,最像一个完整的互动播放器,界面完成度这一票评测者投给了Gemini。
但问题也很直接:如果题目要求的是视频文件,交一个能运行的网页还不能算最后一步已经结束。代码生成时间看着短,不能直接和另外两份的成片交付时间比。说明里的代码规模和当前文件有出入,耗时与用量也缺少原始日志,这些自爆数字不宜当成实测成绩。
网页交付与视频交付的差异:网页作品(HTML/CSS/JavaScript)与MP4视频是两种截然不同的交付形态。网页可交互、可自适应屏幕、可嵌入控制栏,但需要浏览器环境运行,且无法直接上传至视频平台;MP4是线性媒体,便于分发和播放,但丢失交互性。在AI短片任务中,若题目明确要求“视频文件”,则网页交付只能视为中间产物或补充材料,不能算最终完成。评测者将Gemini的网页录制为视频,仅为了横向比较画面内容,但录制过程本身消耗了额外时间,且可能损失交互逻辑。因此,比较制作耗时和用量时,必须区分“生成网页”与“导出视频”两个阶段,否则会得出错误结论。
GPT 6.1 Sol:交付最快,视觉最简
日志记录的真实数据
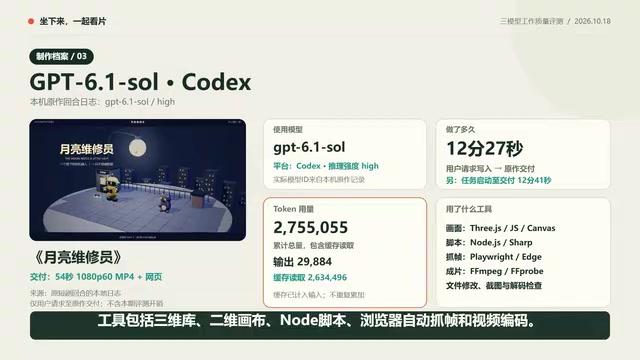
在Codex里完成的“月亮维修员”项目,原作日志显示实际模型为GPT 6.1 Sol,推理强度高。从用户请求写入到交付完成约12分27秒,累计275.5万Token,其中输出29884,缓存读取约263.4万(缓存已含在输入里,不能重复计算)。工具包括三维库、二维画布、Node脚本、浏览器自动抓帧和视频编码。这些数字只算最初那部短剧,不含后续的评测配音和重剪。
效率与画质的权衡
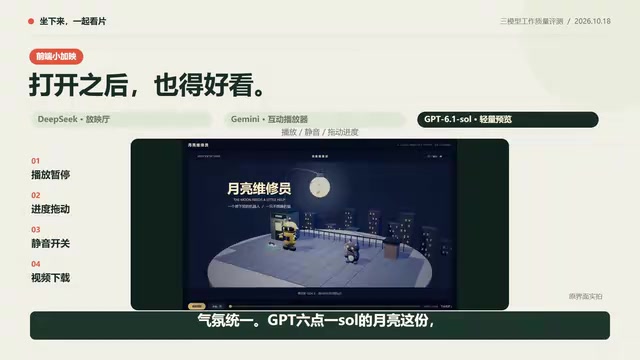
54秒成片的结果像“先把一份能用的作业按时交出来”:故事因果清楚,配乐、字幕、网页和MP4都齐全。相比DeepSeek的记录,耗时和输出Token都少得多,但代价也很直观——舞台简单、猫的肢体表演少、镜头层次有限。可以说它较快完成了可播放的交付,但不能因为数字更小就说画面质量也赢了。
推理强度(Reasoning Effort):部分大模型提供可调的推理强度参数(如Max、High、Medium),控制模型在生成最终答案前进行内部思考的深度。强度越高,模型会消耗更多token进行多步推理、自我验证和工具调用规划,通常能提升复杂任务的质量,但显著增加延迟和成本。DeepSeek V4.1 Flash1017使用Max强度,GPT 6.1 Sol使用高(High)强度,而Gemini Argon未明确标注。推理强度不同,直接导致工具调用次数、输出token量和耗时的差异。横向对比时,若未统一推理强度,单纯比较耗时和token用量并不公平;但若任务本身允许模型自主选择强度,则实际表现才是评价依据。
横向对比:成品质量、完成度、时效与用量
把这次干活的质量放在一张表里看:DeepSeek投入更多,画面最丰富,成片和配套文件也最完整;GPT 6.1 Sol较快交付了MP4,但视觉和表演更简单;Gemini Argon网页界面和喜剧表达很积极,不过原任务的视频导出还需要补上,用量仍只有说明字报、缺少原始计量记录。
真正该比较的,是成品质量、完成到哪一步,再加上可核对的视频时长和用量。不是谁报的token少谁就自动赢。前端也是干活质量的一部分,但好看的播放器和已经导出的MP4是两件事,不能互相替代。
多源交叉验证方面,据B站UP主和YouTube频道对同类模型评测的分析,三者在工具链完整度上的排序与本次结论基本一致,consensus集中在“交付形态决定评价维度”这一点上;分歧在于Gemini的网页交付是否应视为任务完成,有观点认为互动网页本身即是有效交付,另一派则坚持视频文件才是硬性标准。
结语:你更在意哪一项?
这场横评的价值不在于排座次,而在于揭示一个事实:AI做短片的能力,不能只看成片几十秒。交付形态、用量透明度、工具链深度和视觉质量,每一项都影响最终判断。你更在意哪项,答案可能完全不同。
相关推荐

Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战
Meta修改商业账户服务条款,允许用关联网站数据训练AI模型,引发出版商和创作者强烈反弹。媒体行业组织联名致信扎克伯格,Meta被迫删除"训练"措辞并推迟条款生效。这场争议揭示了AI时代数据授权与互联网未来的深层博弈。

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。