DeepSeek V4.1 Pro开测,Gemini 4 Pro跑分泄露

DeepSeek、MiniMax、Gemini 新模型密集泄露或上线,编码与 Agent 治理成竞争焦点。
文章梳理了近期 AI 模型赛道的密集动态:DeepSeek V4.1 Pro 按账户灰度测试并从公开选择器隐藏,MiniMax M3.1 Flash 预览版上线主打高并发低延迟,Gemini 4 Pro 跑分泄露显示 200 万 Token 上下文与定价。谷歌据传在就绪状态下最后一刻取消 Gemini 3.5 Pro,原因未明。开发者工具方面,OpenScience 结束测试、Cloud Plugin Eval 支持插件评估、JUYA-1 轻量决策模型开源、微软 Skillout 框架开源。开源项目 Paperclip 和 ROM 分别聚焦多 Agent 治理与技能共享。榜单显示头部闭源模型仍领先,但开源与国产模型差距收窄。整体趋势指向更大上下文、编码工作流绑定和多 Agent 可审计治理。
AI模型赛道又迎来密集动态。DeepSeek V4.1 Pro被曝进入早期测试、MiniMax M3.1 Flash预览版抢先上线、Gemini 4 Pro跑分在社交平台流传——三款分属不同阵营的模型几乎同时出现在视野里。据B站UP主「AI风向标」的日报梳理,这些消息大多来自泄露或灰度测试,官方口径尚未跟进,但足以勾勒出下一阶段竞争的几个方向:更高的上下文容量、更快的推理延迟、以及编码场景的深度绑定。
DeepSeek V4.1 Pro:被隐藏的测试入口
据泄露消息,模型标识符 DeepSeek广告 V4.1 Pro 已按账户进入早期测试阶段,并被刻意从公开模型选择器中隐藏。这种「按账户灰度、不对外展示」的做法,通常意味着团队在做小范围真实负载验证,距离正式发布可能不远。
需要强调的是,DeepSeek 官方尚未证实该消息,最终规格与上线时间仍以官方公告为准。从产品节奏看,隐藏入口而非公开上线,说明模型能力或服务容量尚未完全就绪,早期测试更像是收集真实场景反馈的阶段。
灰度测试(Grey Release) 是软件与模型发布中常见的渐进式策略:先向一小部分用户或账户开放新版本,而非全量上线。其目的包括在真实负载下验证稳定性、收集反馈、控制风险。对于大模型而言,灰度还能帮助团队评估推理成本、延迟表现和特定场景(如编码)的实际效果。与公开测试不同,灰度入口通常不会出现在默认模型选择器中,只有被标记的账户才能访问。这种做法在 DeepSeek、OpenAI 等厂商中均有先例,往往意味着模型已接近可发布状态,但容量或能力仍需小范围确认。
MiniMax M3.1 Flash:先上线,再谈参数
相比 DeepSeek 的「藏」,MiniMax 选择了「放」。M3.1 Flash 预览版已在 TokenPlan广告 上线,定位清晰:更快更轻,专为高并发、延迟敏感的工作负载打造,现有订阅用户无需额外设置即可调用。
同一模型也已登陆 MiniMax Code,面向日常开发场景,官方描述为「快速可靠」,覆盖修 Bug 到开发完整功能的任务。这类「模型+编码工具」的组合正在成为标配,模型不再单独售卖能力,而是嵌入具体工作流。
Gemini 4 Pro 跑分泄露与谷歌的产品线疑云
泄露数据显示,Gemini 4 Pro 在 DeepSwe V1.1 拿到 88.7%,Terminal Bench 2.1 拿到 95.3%,OS World 2.0 拿到 86.8%,GDeepVal AAVR 跑出 20%,上下文扩展至 200 万 Token,定价为每百万 Token 输入 2.25 美元、输出 11.25 美元。所有数据均未经官方证实,跑分口径与测试条件未知,只能作为方向性参考。
更耐人寻味的是产品线动作。有开发者透露,谷歌在「一切均为最终发布准备就绪」的情况下于最后一刻取消了 Gemini 3.5 Pro,其内部标识为 GemDelta,取消原因至今未获官方说明。
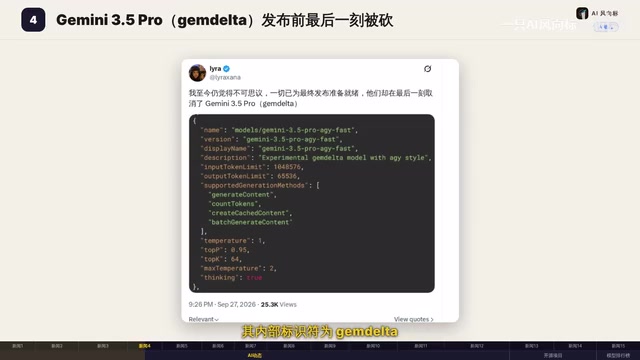
临阵撤下已就绪的模型,对任何团队都是高成本决策。外界的猜测集中在两点:一是内部评估发现该版本相对竞品优势不足,二是产品线命名与定位需要重新梳理。无论哪种,都说明头部实验室的发布节奏正在被竞争压力重新校准。
另有爆料称,一份公开的生产客户端构建产物中出现了 CloudSonic 5.5 专属模型配置,同一产物还引用了 CloudOpus 5.5,该标识此前已现身 Droid 0.228.0 模型注册表并藏于功能开关之后。Sonic 5.5 疑似处于灰度测试阶段,距离正式发布或已不远。
谷歌在 Flow 中把 NanoBanana 2.5 Flash 的模型标注悄然改为 NanoBanana 2.1,外界推测只是小版本更新,官方尚未说明改动原因,是否伴随能力变化仍待观察。此外,Gemini 网页版据泄露已支持技能功能,并计划自 2026 年 11 月 17 日起把所有 Gems 转变为技能,迁移方式与存量 Gems 的兼容细节仍待确认。
上下文窗口(Context Window) 指模型单次推理能处理的最大 token 数量,包括输入提示和生成内容。200 万 token 的上下文意味着模型可以一次性读取约 150 万英文单词或数十份长文档,适合代码库分析、长报告总结等场景。但上下文扩展并非没有代价:注意力机制的计算复杂度随序列长度增长,推理成本和延迟会显著上升。因此,厂商在扩大窗口的同时,通常需要配套优化(如稀疏注意力、分块处理)来平衡性能。上下文容量已成为头部模型竞争的关键指标之一,但实际可用性还取决于模型在长上下文中的召回与推理质量。
开发者工具:从插件评估到多 Agent 治理
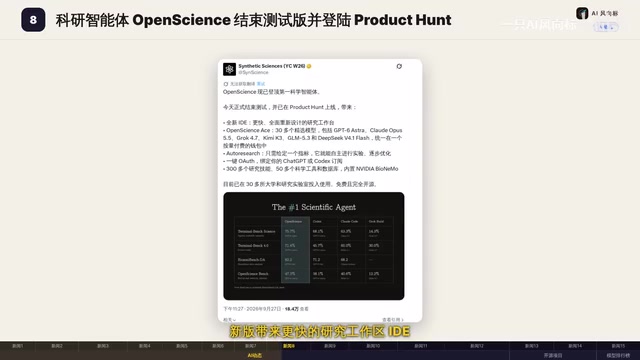
模型之外,工具链的补强同样密集。OpenScience 宣布走出测试版并登陆 Product Hunt,新版带来更快的研究工作区 IDE 和模型聚合服务,收录 30 多款模型,含 GPT-6 Astra、Pimi K3、GLM 5.3 等,共用按量付费钱包;Auto Research 可在给定目标后自主迭代实验。平台已被 30 多所高校采用,免费且开源。
Cloud Plugin Eval 是 Cloud Code 的新增命令,会把插件针对一组测试用例运行并评分,再在不起用插件的情况下逐条重跑用例,直观呈现有无插件的差异。开发者可借此检验插件实际价值,例如在 Opus 5.5 发布后核查付费插件是否物有所值。
AI 实验室 SuperSonic Labs 发布轻量决策模型 JUYA-1,参数仅 1.443 亿,接收上下文与 2-20 个候选答案,完成分类、打分和是非判断,可用于 Agent 选工具或路由。该模型基于 EmbarrassMall 开发,全重 550 兆,M4 上单次决策中位延迟约 33 毫秒,训练成本约 104 美元,已按 Apache 2.0 开源。
微软把能自我改进的技能优化框架 Skillout 开源,它会评估智能体的任务表现,据此重写自身指令,未通过基准测试的改动会被否决,优化后的技能还可跨模型迁移复用,代码仓库已公开。
ChatGPT 网页版代码则显示 DOTS 功能内部关联 OrbitEN 与可能的 O3 代号配置项。该博主据此推测,OpenAI 下一款面向 Pro 档位的产品可能于周二开发者大会揭晓,并有消息称即将于本周四正式发布,Codex Plus 用户将无法使用。
多 Agent 治理(Multi-Agent Governance) 指在多个 AI 智能体协同工作时,对它们的角色、任务、权限和资源进行统一管理。随着编码 Agent 数量增多,团队需要解决任务分配、冲突避免、预算控制和操作审计等问题。治理框架通常提供岗位定义、目标下发、审批流程和日志记录,确保 Agent 的行为可追溯、可干预。这与单 Agent 的零散使用有本质区别:后者无需复杂流程,而前者在规模化协作中不可或缺。Paperclip 等工具正是瞄准这一需求,把治理从“能用”推向“可审计”,反映出生 态从个体工具向系统化协作的演进。
开源项目:多 Agent 治理与技能共享
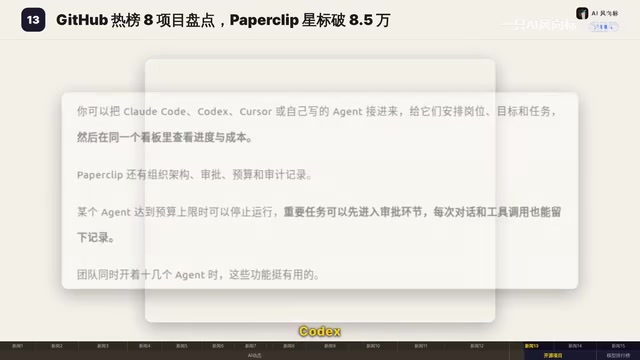
Paperclip 登上 GitHub 今日热榜第一,单日新增 2000 多个 Star,总量突破 8.5 万。它把 Claude Code、Codex、Cursor 等编码 Agent 接入统一管理,分配岗位、目标与任务,还提供审批、预算和审计记录。适合已在协调多个 Agent 的团队;若只用一个 Agent 处理零散任务,治理流程反而增加负担。
开源项目 ROM 则为 AI 智能体打造可积累技能的共享工作区,智能体可在其中构建自己的工具,验证有效的技能长期保留供后续复用。项目定位为人类与智能体协作的智能体操作系统,可作为 Grobot 和 Meta 的 MUSE 的开源替代方案,已获 597 颗 Star 和 52 次 Fork。
排行榜:头部胶着,开源与国产模型上探
当日 AI 模型能力榜单中,智力榜头部由 Cloud Opus 5.5 Max with Fallback 以 58 分领跑,Cloud Fable 5.1 与 GPT-6 Astra 同以 53 分并列第二。开源与国产模型表现亮眼,Mimo V2.6 Pro 以 46 分位列第九,Quan 3.8 Max 以 45 分排名第十,双双在榜。
榜单分数受测试集与权重影响,不宜直接等同于真实场景表现,但开源模型挤进前十,说明头部闭源模型与开源阵营的能力差距仍在收窄。
把上述动态放在一起看,几条主线已经比较清楚:上下文容量向百万级 Token 推进、编码与 Agent 工作流成为模型落地的主战场、多 Agent 治理从「能用」走向「可审计」。泄露与灰度只是前奏,真正值得关注的是官方发布时这些能力能否兑现。
相关推荐

空陆两栖变形无人机:除了省电100倍,还有什么真需求?
空陆两栖变形无人机是否只是噱头?从M4 Morphobot的100倍功耗差异出发,探讨变形无人机的真实应用场景与论文选题思路,分析纯无人机和纯地面机器人均失效的边界条件。

Warhound融资2亿美元:基因工程“战犬”搭配Anduril装备
Warhound完成2亿美元融资,由Ben Lamm和Palmer Luckey推动,通过基因工程改造犬类用于军事和执法,并搭配Anduril装备。本文分析其技术方向、融资逻辑与伦理争议。

Claude API登陆Google Cloud:IAM集成与SDK接入指南
Anthropic将完整Claude API托管在Google Cloud上,通过Google Cloud IAM控制权限并统一计费。本文梳理Vertex AI与Anthropic托管两个服务入口、IAM角色配置要点及SDK接入方式,帮助企业复用现有云治理框架引入Claude模型。