DeepSeek V4 vs GLM-5.1 vs GPT 5.5 编程实测:真实项目开发谁更强?
真实项目实测GLM-5.1、DeepSeek V4 Pro和GPT 5.5编程能力,GLM-5.1表现最稳定。
B站UP主用维护近一年、拥有7000用户的浏览器插件SAR-BASE作为测试项目,对GLM-5.1、DeepSeek V4 Pro和GPT 5.5进行真实编程能力对比。任务是实现多语言字幕导出功能。结果显示GLM-5.1一次通过所有功能且任务分解清晰,DeepSeek V4 Pro和GPT 5.5基础功能正常但UI样式有瑕疵,GPT 5.5还存在开发速度慢的问题。3D页面生成测试中GLM-5.1同样得分最高。文章强调一次通过率比跑分更重要。
跑分之外,真实项目才是AI编程的试金石
DeepSeek广告 V4 和 GPT 5.5 几乎同时发布,跑分数据和编程能力都相当亮眼。但做过开发的人都知道,跑分是一回事,真实项目开发又是另一回事。基准测试中的高分并不意味着在复杂工程场景下也能游刃有余。
AI编程领域常用的基准测试包括 HumanEval、MBPP、SWE-bench 等。HumanEval 主要考察模型生成独立函数的能力,题目通常是自包含的算法问题;SWE-bench 则更进一步,要求模型在真实 GitHub 仓库中修复 issue。但即便是 SWE-bench,其测试环境仍然是标准化的,与开发者日常面对的场景——需要理解业务上下文、维护代码一致性、处理 UI 交互细节、确保不引入回归 Bug——仍有显著差距。这也是为什么跑分高的模型在实际项目中未必表现同样出色。
为了验证这三款模型的真实编程能力,B站UP主阿超用自己维护了近一年、拥有7000多正式用户的浏览器插件 SAR-BASE 作为测试项目,同时加入了3D页面生成测试,对 GLM-5.1、DeepSeek V4 Pro 和 GPT 5.5 进行了一场硬核实测对比。
测试环境与任务设计
测试项目背景
SAR-BASE 是一款用于批量下载视频字幕、作为AI知识库资料的浏览器插件。当前存在一个用户反馈已久的痛点:视频明明有多种语言字幕,但插件只支持导出中文字幕。这次测试的核心任务就是让三个大模型来解决这个多语言字幕导出问题。
浏览器插件(Browser Extension)的开发涉及多个技术层面:Manifest 配置文件定义权限和资源、Content Script 注入目标网页 DOM、Background Service Worker 处理后台逻辑、Popup/Options 页面提供用户交互界面。不同组件之间通过 Chrome Message API 进行通信。这种架构意味着一个功能的修改往往需要跨多个文件协调,且必须遵守浏览器的安全沙箱限制。对于 AI 编程助手而言,理解这种分层架构并在修改时不破坏已有的消息通信链路,是一项相当有挑战性的任务。
测试方案
具体的开发任务包括:
- 在表格中新增字幕语言列
- 接入相关的字幕语言获取接口
- 实现多语言字幕的选择与导出
- 关键要求:新增功能不能破坏已有功能
工具选择上,GLM-5.1 和 DeepSeek V4 Pro 均通过 VS Code 中的 Cloud Code 插件进行开发,GPT 5.5 则使用 Codex 插件(因为体验更原生)。三者使用完全相同的提示词和需求描述,确保对比的公平性。
Cloud Code 是 VS Code 中支持多模型接入的 AI 编程插件,开发者可以在同一界面中切换不同的大模型后端,实现代码生成、重构和调试等功能。Codex 则是 OpenAI 专门为 GPT 系列模型打造的编程代理插件,它采用异步任务模式——开发者提交需求后,Codex 会在云端沙箱环境中独立完成代码修改,再将结果以 Pull Request 的形式返回。这种架构差异直接影响了开发体验:Cloud Code 更接近实时对话式编程,而 Codex 更像是委托一个远程开发者完成任务,这也部分解释了 GPT 5.5 耗时较长的原因。
三大模型真实项目编程能力对比
GLM-5.1:一次通过,开发体验最佳
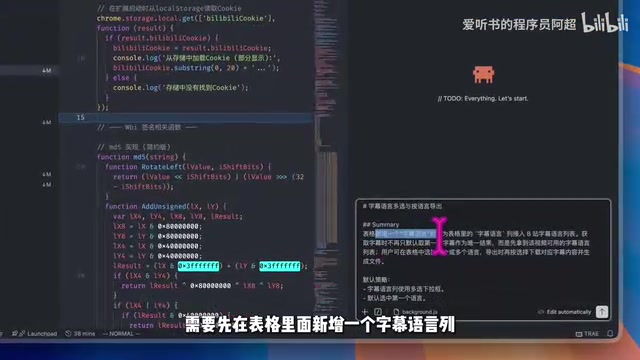
GLM-5.1 的表现可以用"教科书级别"来形容。它首先给出了一个清晰的 To-Do 列表,将整个任务分解为多个步骤,然后逐步执行。开发者可以清楚地看到每一步在做什么,整个思考链路非常透明。
在软件工程中,任务分解(Work Breakdown Structure)是项目管理的基础实践。当 AI 编程助手在执行复杂任务前先输出一个清晰的 To-Do 列表时,它实际上是在做两件事:一是向开发者展示其对需求的理解是否正确,提供了一个人工校验的窗口;二是为自身的执行过程建立了一个结构化的路线图,降低遗漏功能点的概率。这种"先规划后执行"的模式类似于 Chain-of-Thought(思维链)推理在工程场景中的应用,对于涉及多文件修改的复杂任务尤为重要。
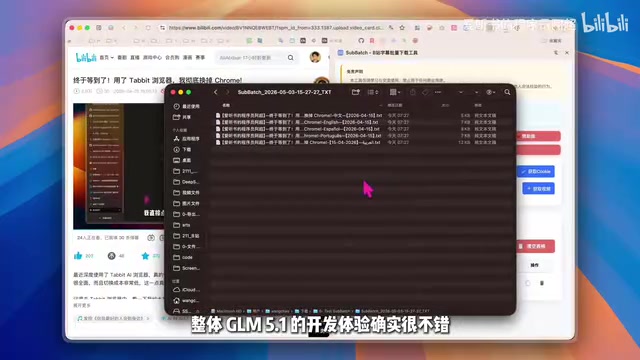
实测结果:
- ✅ 字幕语言列正常显示
- ✅ 字幕获取成功,中文、英文及其他语言选项完整
- ✅ 多语言全选导出功能正常
- ✅ 未破坏已有功能
一次性完成,所有功能实现到位,没有任何问题。 这在复杂的真实项目迭代中是非常难得的。
DeepSeek V4 Pro:基础功能OK,UI细节待打磨
切换到 DeepSeek V4 Pro 后,一个明显的差异立刻显现:它没有给出 To-Do 列表,开发者无法清楚地知道它具体在做什么、计划分几步完成。这在实际开发协作中会带来一定的不确定感。
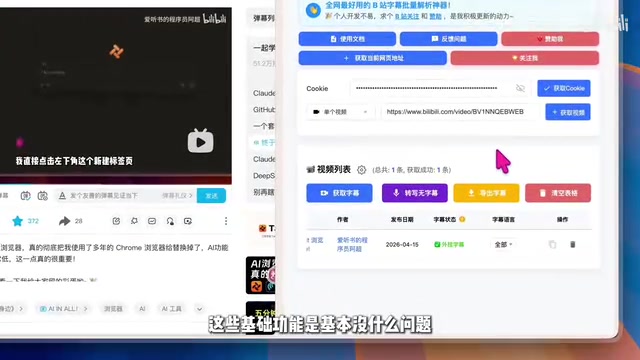
实测结果:
- ✅ 字幕语言列正常显示
- ✅ 字幕获取成功
- ✅ 导出的字幕内容没有问题
- ⚠️ 下拉框样式存在问题:5种语言只能看到3种,且无法滑动查看
基础功能完全没问题,但在UI细节处理上还需要额外调整。对于一个有7000用户的正式产品来说,这类样式问题虽然不影响核心逻辑,但会直接影响用户体验。
GPT 5.5:逻辑清晰但开发速度较慢
GPT 5.5 通过 Codex 插件进行测试,整体思考链路相对清晰,功能点罗列也很完整。但有一个显著的问题——耗时约15分钟才完成代码修改,相比前两者明显更慢。
实测结果:
- ✅ 字幕语言列正常显示
- ✅ 字幕获取成功
- ✅ 导出的字幕内容没有问题
- ⚠️ 下拉框样式同样存在问题:被其他元素遮挡
整体逻辑没有太大问题,但和 DeepSeek V4 Pro 类似,在样式细节上也需要二次调整。
下拉框被遮挡、文字重叠等 CSS 样式问题是 AI 编程助手的常见短板。这背后有深层原因:大模型在训练时主要学习的是代码的逻辑结构和语义关系,而 CSS 的视觉表现高度依赖于上下文——同一段 CSS 代码在不同的 DOM 结构、不同的父元素 overflow 设置、不同的 z-index 层叠上下文中可能呈现完全不同的效果。模型很难仅通过代码文本推断出最终的视觉渲染结果。这也是为什么在真实项目中,逻辑功能往往能一次通过,但样式细节却频繁需要二次调整。
3D页面生成能力对比测试
除了真实项目开发,测试还包含了一个前端3D生成任务:用同一个提示词生成可运行的单HTML页面——3D智慧城市监控大屏。
单 HTML 文件实现 3D 智慧城市监控大屏,通常依赖 Three.js 或 Babylon.js 等 WebGL 框架。这类任务考验模型在多个维度的能力:3D 几何建模(建筑物、车辆的网格生成)、材质与光照设置、动画系统(车辆移动路径)、相机控制(拖拽交互)以及数据可视化面板的叠加。性能开销主要来自 GPU 渲染管线中的 Draw Call 数量、几何体面数和实时阴影计算。
GLM-5.1 拿下9.8分
- 房屋建模和汽车动态效果实现出色
- 拖拽交互非常丝滑流畅
- 整体完成度最高
DeepSeek V4 得分9.0
- 3D场景基本完整
- 车辆移动速度过快,不够自然
- 左下角实时事件区域文字重叠
- 拖拽流畅度不如 GLM-5.1
GPT 5.5 获得9.5分
- 整体完成度较高
- 但运行时电脑明显卡顿,性能开销较大
- 拖拽交互不够丝滑
GPT 5.5 生成的页面导致电脑卡顿,很可能是因为模型没有对几何体进行合并优化(Mesh Merging)或未合理控制渲染循环中的计算量。这反映了当前大模型在代码生成时普遍缺乏性能意识——它们能写出功能正确的代码,但不一定能写出高效的代码。
综合评价:哪款AI编程助手更值得选?
| 维度 | GLM-5.1 | DeepSeek V4 Pro | GPT 5.5 |
|---|---|---|---|
| 真实项目开发 | ⭐⭐⭐⭐⭐ 一次通过 | ⭐⭐⭐⭐ 样式有瑕疵 | ⭐⭐⭐⭐ 样式有瑕疵 |
| 任务分解透明度 | 清晰的To-Do列表 | 无明确分解 | 较清晰 |
| 开发速度 | 快 | 快 | 较慢(约15分钟) |
| 3D生成能力 | 9.8分 | 9.0分 | 9.5分 |
| 已有功能保护 | 未破坏 | 未破坏 | 未破坏 |
从这次实测来看,GLM-5.1 在真实项目开发和3D生成两个维度上都表现最为稳定,一次性完成且没有需要二次修复的问题。GPT 5.5 整体能力也很强,与 GLM-5.1 可以说"打得有来有回",但在开发速度和性能优化上还有提升空间。DeepSeek V4 Pro 基础实力完全没问题,但在细节处理上还需要进一步打磨。
在实际开发流程中,"一次通过率"(First Pass Yield)的重要性远超表面看起来的程度。每一次代码修复都意味着额外的上下文切换成本:开发者需要重新阅读 AI 生成的代码、定位问题、描述修复需求、验证修复结果。研究表明,程序员在被打断后平均需要 15-25 分钟才能恢复到之前的专注状态。因此,一个一次通过率为 90% 的模型,其实际生产力可能远超一次通过率为 70% 但跑分更高的模型。
你可能没注意到,这只是一个特定场景下的测试,不同的项目类型和需求复杂度可能会得出不同的结论。但至少在真实复杂项目迭代这个最贴近开发者日常的场景中,这次测试提供了一个有价值的参考。对于正在选择AI编程助手的开发者来说,稳定性和一次通过率可能比跑分数据更值得关注。
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。