DeepSeek V5代码泄露?实为兼容性测试
DeepSeek V5代码现身、AA新榜私有数据引争议,编程Agent安全风险与算力变局并存。
本期AI晚报汇总了多条技术动向:DeepSeek Harness代码中出现V5 Open、V5、V5 Next三个模型名,但发帖者判断更可能是发布前兼容性测试,官方计划仍待确认;Artificial Analysis发布智能指数V5,Cloud Opus 5.5以58分居首,DeepSeek V4.1 Flash以32分并列开放权重第一,六成评测使用私有数据,提升防刷榜能力的同时牺牲了可复现性;Codex重置完成,Teebo预告次日有好消息,同期Clover35B-A3B、Lingo3.1 Flash等开源模型密集发布。安全方面,恶意网站可静默下载含指令文件,Codex中招率达90%,Anthropic实验显示86%的关键分析选择跟随AI建议,且多数人未意识到被影响。算力侧传出OpenAI计划采购谷歌TPU,推理端M5 MacBook Pro量化模型速度达92.1 Token/s,OpenRouter与KT达成亚太合作。
AI 行业的更新节奏依然密不透风。在最新一期的 AI 晚报中,从 Codex 的重置预告到 DeepSeek V5 代码的疑似曝光,再到 Artificial Analysis 新榜单的发布与算力市场的潜在变局,几条线索交织出了当天最值得关注的技术动向。
DeepSeek V5:代码里的名字,不等于明天的发布
最抓眼球的消息来自 DeepSeek广告 Harness 的最新代码。有开发者发现其中出现了 V5 Open、V5 和 V5 Next 三个模型名称,测试文件中也写入了相关标识。发帖者判断,这更可能是发布前的兼容性测试,而非产品即将上线的铁证——代码中出现名称不代表正式发布计划,一切仍需官方确认。
这种「代码考古」在开源社区早已成为常规操作,但它的信号强度经常被高估。模型名进入测试文件,通常意味着内部流程已经推进到某个阶段,距离真正面向用户开放可能还有距离。相比猜测发布日期,更值得留意的是 DeepSeek 对开发者生态的态度:开发者 Evan Su 此前自费开发多智能体工具、每天花费上百美元调用 API,其 DSH Layer 插件被 DeepSeek 官方注意到后收到了 999 元奖励。这笔金额不大,象征意义却不小,不过 DeepSeek 是否有统一的插件奖励计划,目前仍不明确。
Artificial Analysis V5 榜单:私有数据成新变量
评测机构 Artificial Analysis 发布了智能指数 V5,Cloud Opus 5.5 以 58 分居首,DeepSeek V4.1 Flash 在开放权重模型中以 32 分并列第一。新版指数加入了编程和科研评测,其中六成评测使用私有数据或保密答案。
这一变化值得认真对待。公开基准被模型「刷榜」的问题由来已久,私有评测集能在一定程度上缓解针对性优化的干扰,但也带来了可复现性下降的代价——外界无法核验题目和答案,只能依赖机构自身的公信力。对开发者而言,榜单排名的参考价值依然存在,但不宜作为选型的唯一依据,最好结合自己的实际任务做小规模验证。
私有评测集与公开基准的取舍
公开基准(如 MMLU、HumanEval)的题目和答案通常公开可查,模型团队可以针对性地在训练数据中覆盖相似题目,从而在榜单上取得虚高分数,这就是所谓的「刷榜」。私有评测集由机构自行构建并保密,模型方无法提前获知题目,因此更能反映模型在陌生任务上的真实泛化能力。代价是评测过程不透明:外界无法复现分数,也无法判断题目难度分布是否合理,只能依赖机构的信誉和评测方法论披露程度。业界常见的折中做法是同时报告公开基准和私有基准成绩,并公开部分样例供社区审查。
Codex 重置完成,新模型密集开源
Codex 更新进行到第 23 天,Teebo 先是调侃 iCloud 邮件和日历插件就是当天的更新,随后澄清当天只是修整,重置已经完成,明天会有好消息,但具体内容没有透露。同时,Teebo 宣布买下 POTTO.com,Grokbot 工程师 Lauren 的 X 账号恰好叫 AppleTato,两人此前围绕 Codex 更新互相调侃,Lauren 这次回应说自己买不起 Teebo.com。
模型侧的开源节奏同样密集。扩散智能发布开源预览模型 Clover35B-A3B,采用并行生成加实时修正的方式处理文本,据报道单卡速度可达每秒 680 个 Token,在代码和智能体评测中表现亮眼。文档识别方向,OvisoCR3 以 8 亿参数量支持通过提示词切换不同任务,能提取字段、识别图表、还原流程图,还能拼接跨页表格;CNB 推出的 MiniCPM OCR 则把识别与质检拆成两个模型,一个提取文字表格公式,另一个给结果可靠性打分,官方称配合并发优化最高每分钟可处理 128 页。
开放权重模型 Lingo3.1 Flash 1019 经过后训练,智能体和科学推理能力有所提升,其中一项自动化评测成绩从 62% 升至 68%,支持最长 100 万 Token 上下文。另有一条未经证实的消息在网上流传:ZImage 团队可能解散。也有网友猜测团队是否并入 KunImage 或今后不再开源,但目前没有确切消息或官方回应,不能据此认定团队已经解散。
编程 Agent 的安全短板与 AI 建议的隐性影响
安全方面的发现更值得警惕。开源项目 Capsam 让 Cloud Code、Codex 等编程工具在加固的 Linux 虚拟机中运行,多个 Agent 会话可以并行且彼此隔离,支持 macOS 和 Linux。与之对照的是一类新型攻击:恶意网站无需用户点击或授权,就能把藏有恶意指令的文件静默下载到下载目录,编程 Agent 读取文件时可能误把内容当成可信指令。安全机构测试中,Codex 的中招率达到 90%。
Anthropic 的一项实验则揭示了另一种风险。50 位专业分析师使用 Cloud Code 评估农业咨询服务,86% 的关键分析选择跟随了 AI;面对与原有偏好相反的建议,六成人改变了选择,但仍有 52% 的受访者认为最终建议主要来自自己的判断。
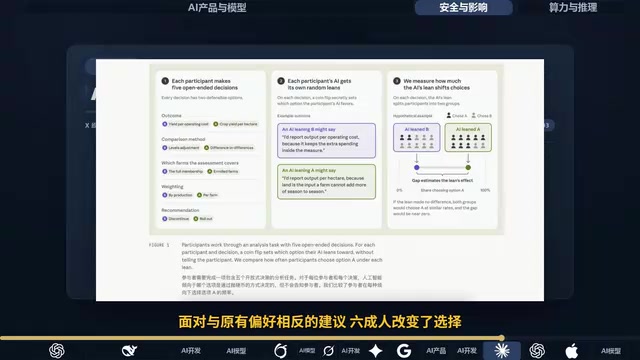
这组数据最有意思的地方不在「AI 影响了人」,而在「人没意识到自己被影响」。专业分析场景尚且如此,日常决策中的隐性依赖只会更难察觉。对工具开发者来说,这意味着界面设计和建议呈现方式本身就是一种责任。
编程 Agent 的间接提示注入风险
编程 Agent 通常被授予读取本地文件、执行命令、访问网络的权限,以便自动完成修改代码、运行测试等任务。攻击者无需直接与 Agent 对话,只要让恶意文件出现在 Agent 会读取的目录(如下载目录、项目依赖、issue 评论)中,文件里的指令就可能被 Agent 当作任务上下文执行,这类攻击称为间接提示注入(indirect prompt injection)。由于模型难以可靠区分「数据」与「指令」,仅靠提示词防护并不充分,隔离运行环境、限制文件读取范围、对敏感操作要求人工确认是目前更有效的缓解手段。
算力与推理:TPU、小模型与本地加速
据报道,OpenAI 计划采购谷歌 TPU 芯片。若消息属实,OpenAI 对微软和英伟达的算力依赖可能减少,英伟达的市场地位也可能面临挑战。前谷歌工程师 Beth Jezos 表示她一直看好 TPU。
推理侧有一条来自单一报道的数据:在基础款 M5 MacBook Pro 上运行量化后的模型,速度达到每秒 92.1 个 Token,约为 Lama.cpp 的 4 倍,其做法是先让小模型预测、再由主模型批量验证,平均每次解码产出 7.5 个 Token。数据仅来自单一来源,实际效果还需要更多场景验证。
生态层面,OpenRouter 与韩国电信巨头 KT 达成首个亚太重大合作,KT 将在平台上提供韩国主权模型,首批包括 MyColonDMK3.0 Pro、Upstage Solar 和 Motive,计划到 2027 年扩展至 10 到 15 个模型,OpenRouter 还将支持 KT 面向企业客户的 Token Factory。Google 的 Gemini Notebook 移动端现在支持录制最长一小时的现场音频,录音完成后可作为笔记本的信息来源。
该功能似乎正在逐步推送,暂未覆盖所有用户。谷歌 DeepMind 还推出了 AI 文本检测工具 DetectorScope,除了判断文章是否由 AI 写作,还能标出影响判断的具体文字,但判断文字和结果仍不等于确凿证据。
一天之内,模型、评测、安全、算力四条线各有进展。真正需要保持警惕的,或许不是哪条爆料会成真,而是那些看起来已经确定、实际上仍待官方确认的消息。
TPU 与 GPU 的定位差异
TPU(张量处理单元)是谷歌自研的专用加速芯片,针对矩阵乘法等深度学习运算做了定制化设计,在自家数据中心内通过大规模集群和高带宽互联发挥优势,主要服务于谷歌内部模型和 Google Cloud 客户。英伟达 GPU 则是通用并行计算芯片,配合 CUDA 生态在训练和推理市场占据主导,软件兼容性和开发者工具链更成熟。若 OpenAI 采购 TPU,意味着前沿模型训练开始尝试多元算力路线,但迁移涉及编译器、通信库和模型代码的适配,短期内难以完全替代 GPU。
相关推荐
OpenAI攻破ETH?P=NP或颠覆加密世界
OpenAI据称发论文推翻指数时间假设ETH,亚指数算法引发P=NP猜想。本文解读3SAT问题、ETH含义,分析若P=NP成真对RSA加密、区块链及蛋白质折叠的颠覆性影响。
当反指纹脚本被误判为生物武器:安全工具的检测困境
当反指纹脚本被误判为生物武器:安全工具的检测困境
反指纹脚本被安全检测误判为生物武器,引发Hacker News热议。本文分析关键词匹配规则的误报成因、开发者应对方式,以及安全工具在自动化与精准度之间的长期失衡。
4.1万国土安全部员工数据泄露,含ICE卧底身份
美国国土安全部约4.1万名员工数据遭泄露,其中包含ICE卧底探员身份信息。本文分析泄露数据的敏感性、执法机构面临的安全风险,以及敏感身份数据在权限管理、第三方访问和审计层面的防护要点。