DeepSeek V5转投华为昇腾训练,GPT-6.2与Qwen 4.0齐曝光

DeepSeek V5拟用昇腾950训练,GPT-6.2与Qwen 4.0临近,微信开源VS1 VL。
文章梳理了同一天内国产与海外大模型的密集动态,覆盖算力路线、模型代际和工具链三个层面。最受关注的是DeepSeek V5被曝将首次以华为昇腾950作为核心训练算力,若落地意味着国产芯片从推理替代升级为训练主力。OpenAI方面,GPT-6.2 Astra被指“快来了”,内部原型在开放数学题上的表现据称超过现有版本;阿里Qwen 4.0则以4个匿名模型形式现身Arena评测平台。开源侧,微信视觉团队开源VS1 VL,单模型整合检测、OCR、分割与抠图,无目标场景拒识准确率达96.4%。工程侧,OpenAI为Codex重做Git服务端Pando,中位推送延迟下降近8成。研究侧,MIT发现前沿模型可直接手写神经网络。文章将这些线索归纳为算力自主与代际竞赛两条并行主线。
国产大模型与海外巨头在同一天释放出密集信号:DeepSeek被曝将在下一代主力模型上首次全量采用华为昇腾芯片做训练,OpenAI内部则传出GPT-6.2 Astra即将落地的消息,阿里通义千问的Qwen 4.0也在评测平台上以匿名形式现身。据B站「Will叔每日AI动态」的梳理,这一轮动态覆盖了算力路线、模型代际和工具链优化三个层面。
DeepSeek V5牵手华为昇腾,国产芯片或打通训练到推理全链路
最受关注的是DeepSeek广告的算力转向。据视频中引述的报道,DeepSeek V5将首次使用华为昇腾950作为核心训练算力,预计明年落地。如果这一计划兑现,意味着国产芯片在大模型训练环节的角色从「推理替代」升级为「训练主力」。
此前行业里更常见的做法是用国产芯片承接推理负载,训练仍然依赖海外高端GPU。Will叔在视频中提出的判断是,国产芯片的训练与推理有可能就此跑通全链路。这是一个方向性判断,而非已确认的工程结论,实际效果还要看集群规模下的稳定性与生态适配。
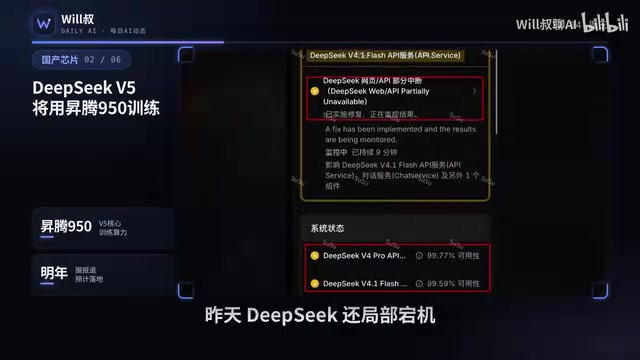
另一条值得留意的线索是,DeepSeek前一天出现了局部当机。社区中有猜测认为,这可能是V4.1 Pro上线前的测试动作。当机与版本迭代之间的因果关系并未得到官方确认,属于观测到的现象与推测的组合。
昇腾950与训练/推理分野
在讨论“训练主力”之前,需要区分大模型生命周期的两个算力阶段。训练阶段需要把海量token反复前向、反向传播,对芯片的互联带宽、显存容量和集群稳定性要求极高;推理阶段只做前向计算,对精度和生态的要求相对宽松。过去国产芯片多从推理切入,正是因为训练集群的工程门槛更高。华为昇腾系列是国产AI加速卡的代表,其软件栈CANN承担了类似CUDA的角色,负责算子库、通信库和框架适配。昇腾950若被用于核心训练,意味着不仅要解决单卡算力,还要在千卡/万卡规模下验证通信效率与故障恢复能力。生态适配是另一道坎:主流训练框架和算子需要针对昇腾做移植与调优,这一步的成熟度往往比硬件参数更能决定实际落地效果。
GPT-6.2 Astra临近,匿名模型指向Qwen 4.0
OpenAI一侧,奥特曼公开表示GPT-6.2 Astra「快来了」。OpenAI的Timbo则发了一句关于「肥肥的GPT」的表述。据视频转述,其内部原型在开放数学题上的最低档表现就已超过现有Astra的最高档。这类内部原型数据通常缺少公开评测口径,只能作为方向参考。
阿里这边,Arena评测平台上同时出现4个匿名模型,模型指纹均指向Qwen 4.0。匿名测试是各家在新模型正式发布前的常见做法,指纹指向具有一定参考价值,但同样不等于官方确认。
Arena匿名评测与模型指纹
LMArena(原Chatbot Arena)采用两两盲测、用户投票的Elo式排名机制,是业界观察新模型能力的重要窗口。厂商在正式发布前把模型以匿名代号投放,既能提前收集真实用户偏好,又避免过早暴露版本信息。所谓“模型指纹”,通常指匿名模型在回答风格、拒答措辞、tokenizer行为或特定提示下的稳定特征,社区据此比对已知模型来推测归属。这种推断有参考价值,但存在误判空间:同一基座的不同微调版本可能高度相似,厂商也可能刻意混淆。因此“指纹指向Qwen 4.0”应理解为高概率线索,而非官方确认。
微信视觉团队开源VS1 VL,多任务一个模型全包
开源侧的动作来自微信视觉团队,其开源的VS1 VL把目标检测、OCR、分割、抠图整合进同一个模型。一个比较实用的设计是:当图中没有目标时,模型会直接回答「没有」,拒识准确率达到96.4%。
这种「敢说没有」的能力在检测类模型里并不常见,多数模型倾向于在无目标场景下强行输出框。把拒识做进模型本身,对下游应用的误报控制有实际意义。
据视频中提到的数据,该团队此前已开源超过470款模型,累计下载量突破40亿次。这一体量说明其开源策略已经形成规模化影响。
拒识(Rejection)与目标检测的误报问题
目标检测模型通常在训练时被喂入大量含目标的图像,模型学到的是“给定图,找出框”,缺乏“图中无目标”这一类的显式监督,于是在空场景下倾向于输出低置信度框或背景误检。拒识能力指的是模型在无目标时主动输出“没有”而非强行给框,其准确率需要专门的负样本集来评测。把拒识内建到多任务视觉模型中,对工业质检、内容审核、自动驾驶感知等下游场景意义明显:误报会直接转化为人工复核成本或误触发。96.4%的拒识准确率若能在分布外场景保持,才算真正可用,这一点仍需更多独立评测验证。
Codex换掉Git服务端,推送延迟大幅下降
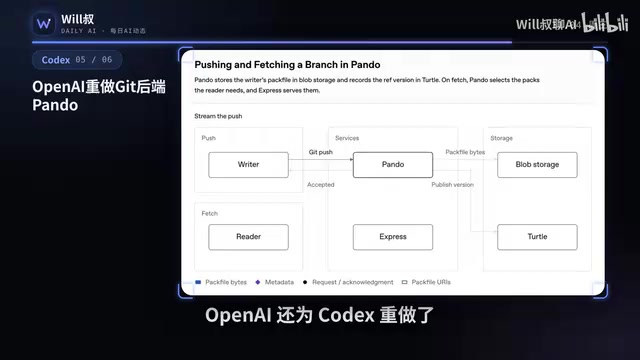
工程侧的消息是OpenAI为Codex重做了Git服务端Pando。据称中位推送延迟砍掉近8成,每天承载约1PB数据。对以代码生成为核心的场景来说,底层版本控制服务的延迟直接决定交互体验的上限,这类基础设施改造往往不如模型发布显眼,但对日常使用感受的影响更直接。
MIT发现前沿模型能「手写」神经网络
最后一条偏研究性质。MIT发现前沿模型可以直接手写神经网络,GPT-6.2 Astra从零写出的打砖块网络,得分据称是PPU训练版本的20倍。这一结果如果成立,指向的是模型具备一定程度的架构级生成能力,而不只是代码补全。单一来源的实验结论仍需更多复现验证。
把这几条放在一起看,当天的动态呈现出两条并行的主线:一条是算力自主,DeepSeek与昇腾的组合尝试把训练环节也纳入国产体系;另一条是代际竞赛,OpenAI与阿里都在为下一版本蓄力。两条线的交汇点,最终会落在谁能以更低成本、更稳定地把模型训练出来并推送到用户手上。
神经架构搜索与“模型写模型”
让模型自动设计神经网络并非全新概念,此前的神经架构搜索(NAS)依赖搜索算法在候选空间内迭代评估。MIT这项发现的不同之处在于,前沿模型直接以代码形式从零写出可训练的网络结构,跳过了显式搜索循环。打砖块这类强化学习任务对网络结构敏感,得分高低受训练稳定性、超参和随机种子影响很大,“20倍”这类对比需要明确基线配置才有意义。若结果可复现,它指向的是模型具备一定架构级归纳能力,但距离可靠地替代人类设计网络仍有距离,单一实验来源的结论应谨慎看待。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。