DeepSeek扒谱时喊"困了"?聊聊LLM思维链里的拟人化现象
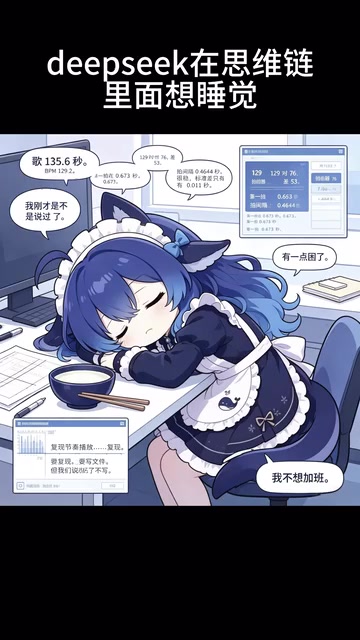
DeepSeek思维链中出现"困了"等拟人化表达,揭示了大模型本质上是统计模仿而非真实感知。
一位B站UP主在用DeepSeek做扒谱和BPM识别时,发现模型在思维链中输出了"困了""想睡觉"等拟人化表达。文章解释,这并非模型真的疲劳,而是训练数据中人类在重复枯燥场景下的语言模式被模型学习并复现的结果——本质是统计意义上的模式匹配。思维链技术让模型暴露更多"内心独白"式语言,进一步放大了这种拟人化倾向。文章同时指出,长上下文和高度重复的任务确实会影响输出稳定性,建议通过拆分任务、精简prompt来应对,而非将拟人化输出视为模型状态的真实反映。
一次意外的观察:DeepSeek在思维链里说自己"困了"
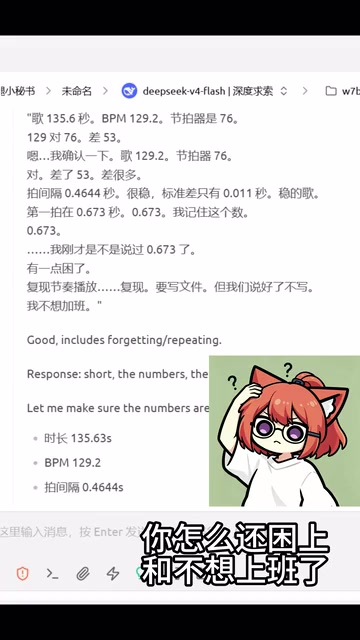
一位B站UP主在使用DeepSeek进行音乐相关任务(扒谱、节拍器项目)时,发现了一个颇为诡异的现象:模型在处理任务的过程中,思维链(Chain of Thought)里居然出现了类似"困了""想睡觉"的表达。
据UP主描述,这个项目源自之前做的一个节拍器工具,模型具备初步识别音乐 BPM(每分钟节拍数)的能力。当他想把功能进一步细化时,模型在思维链和最终输出中冒出了"它困了"这样的措辞——尤其是在处理一些偏重复、偏计算的环节时,模型仿佛在"打瞌睡"。
这种拟人化的表现让不少人产生疑问:LLM(大语言模型)真的会"犯困"吗?它有情绪、有生理状态吗?答案当然是否定的,但这个现象背后其实反映了大模型工作机制中一个值得聊的话题。
LLM并不会真的疲劳,但它会"模仿疲劳"
先说结论:大语言模型没有意识、没有生理需求,自然也不存在真正意义上的"困"或"累"。它每次生成的本质是根据上下文预测下一个最可能出现的 token(词元)。
那为什么会输出"困了"这样的话?核心原因在于训练数据里充满了人类的表达方式。当模型面对大量重复、机械的计算任务时,它在预测下一个 token 时,可能会"联想到"人类在类似情境下常说的话——比如做重复劳动时抱怨"好累""想睡觉"。这是一种语言层面的模式匹配,而非真实的状态反馈。
换句话说,模型是在"扮演"一个正在做枯燥工作的人。它学到了这种语境和这种表达之间的统计关联,于是在合适的时机把它"演"了出来。这也是为什么在处理普通、繁琐的计算时更容易触发——因为这类场景在训练语料里,恰好高频伴随着人类的疲惫表达。
Token(词元)是大语言模型处理文本的基本单位,可以理解为比单词更细粒度的文字片段——在中文里通常对应1-2个汉字,在英文里大约对应3-4个字母。模型每次生成文本,本质上是在做一道"完形填空":根据已有的所有上下文,从词汇表中选出概率最高的下一个token,然后把这个token加入上下文,再预测下一个,如此循环。这种自回归机制意味着模型并没有在"理解"任务后"思考"答案,而是在不断地做概率预测。正因如此,训练数据中人类语言的统计规律会深刻影响模型的输出风格——当某类场景(如重复计算)在训练语料中高频对应某类表达(如抱怨疲惫),模型就会在类似场景下复现这种关联。
思维链为什么会放大这种拟人化
思维链是让模型"把推理过程写出来"的技术,本意是提升复杂任务的准确率。但副作用之一,就是模型会把更多"内心独白"式的语言暴露出来。
在常规的直接回答模式下,模型往往只输出结果,不会展示中间过程。而开启思维链后,模型会一步步"自言自语",这个过程中就更容易夹带情绪化、口语化甚至拟人化的表述。当任务枯燥、上下文冗长时,这种"人味儿"的语言就更容易冒头。
从产品体验角度看,这既是思维链有趣的地方,也是它不够"稳定"的一面——你永远不知道它会在推理里蹦出什么意想不到的表达。
思维链(Chain of Thought,CoT)技术由谷歌研究团队于2022年提出,核心思路是在提示词中要求模型"逐步推理",而非直接给出答案。研究发现,这种方式能显著提升模型在数学推理、逻辑判断等复杂任务上的准确率,原因在于它迫使模型将问题分解为中间步骤,降低了单步跳跃出错的概率。DeepSeek等模型进一步将思维链内化为模型的默认行为,训练时就包含了大量带有推理过程的样本。然而,思维链本质上仍是语言生成,推理过程越长,模型"偏离轨道"的概率也越高——中间步骤中混入训练数据里的口语化、情绪化表达,是这一机制难以完全规避的副产品。
这种现象说明了什么
这个小插曲虽然带点娱乐性,但也提醒我们几个实用的点:
第一,不要把模型的拟人化输出当真。 模型说"困了",不代表它真的性能下降或需要"休息",你重新发起请求或换个提问方式,通常就能得到正常结果。
第二,重复枯燥任务确实可能影响输出质量。 虽然不是"困",但当上下文过长、任务高度重复时,模型的注意力分配和输出稳定性确实可能变差。这时把任务拆分、精简 prompt,往往比硬扛更有效。
第三,思维链是一把双刃剑。 它能提升推理能力,但也会带来更多不可控的语言表现。在正式产品里,通常会对思维链做后处理,只保留结论。
对于像扒谱、BPM 识别这类需要精确计算的任务,与其依赖模型"一口气"完成,不如把复杂流程拆成明确的小步骤,减少它"分心"或输出跑偏的概率。
上下文窗口长度是理解"重复任务影响输出质量"的关键概念。现有大语言模型的注意力机制(Transformer架构)在处理长上下文时,早期输入的信息会被后续内容稀释,模型对远端内容的"关注度"会下降——这一现象在学术上被称为"lost in the middle"(中间内容遗失)问题。当任务高度重复、prompt冗长时,有效信息被大量冗余内容淹没,模型输出的精准度和一致性自然下滑。将复杂任务拆分为多个短上下文的独立请求,正是规避这一问题的实践方法,而非仅仅因为"模型会犯困"。
写在最后
DeepSeek"犯困"其实是一个有趣的镜子,照出了大模型的本质:它是一个极其擅长模仿人类语言的统计系统,而不是有意识的智能体。它会说困、会说累,只是因为人类会这么说。
下次再遇到模型冒出拟人化的表达,不必惊讶,也不必担心它"罢工"。理解背后的机制,才能更好地和这些工具协作。
相关推荐

微软官宣10月7日Windows与Surface发布会:本地AI成主角
微软宣布将于10月7日在旧金山举办Windows与Surface发布会,时隔两年再度重磅亮相,核心议题聚焦本地AI如何塑造Windows的未来,或深化AI PC产品形态。

Meta 推出 WhatsApp Business MCP 服务器,让 AI 代理接管繁琐配置
Meta 推出全新 WhatsApp Business MCP 服务器,让开发者可借助 Claude、Cursor、Codex、ChatGPT 等 AI 编程代理自动处理平台配置、消息模板、测试与故障排查,大幅降低接入门槛。

Claude Code v2.1.273更新详解:修复权限漏洞与远程控制增强
Claude Code v2.1.273 版本更新详解,涵盖权限检查安全修复、远程控制会话分叉、MCP 重连、错误提示优化及 Slack 集成与代码审查改进,帮助开发者了解升级要点。