DeepSeek回应38美元暴利论:算力账本与开源棋局

DeepSeek回应38美元暴利质疑:那是理论流水,开源真意是抢生态先手。
文章围绕B站UP主与DeepSeek官方关于“每卡每小时38美元”截图的对话展开,澄清该数字是满负债24小时满载的理论流水,而非实际利润,真实成本需扣除H100采购、机房电费与折旧。文章进一步解释开源框架难以被OpenAI、Anthropic等巨头迁移,因推理栈与CUDA生态深度绑定,换框架的停工成本高于节省费用。框架绕开CUDA方言适配昇腾,使国产卡从“能跑”变为“好用”,真正利好中小厂、高校与算力受限用户。最后点明开源的战略动机是抢生态先手,而非慈善,并暗示硅谷巨头存在隐性借鉴。
一张“每卡每小时38美元”的截图,把DeepSeek推上了“暴利”的审判席。B站UP主直接把问题甩给了DeepSeek官方,得到的回应不是公关话术,而是一本摊开的算力账本和一套清晰的生态逻辑。
38美元怎么来的:满负债跑满24小时的理论流水
DeepSeek广告的回应很直接:38美元是“满负债按股价24小时不停地跑才凑出来的理论流水”。换句话说,这是一个极端理想化的上限值,而非实际利润率。如果真按这个数字记账,“明天就能敲钟上市”。
问题在于,算账不能只算分子。一张H100的采购价约4万美元,一万张卡就是数亿美元的前期投入。此外还有机房、液冷、交换机、电费、训练成本,以及“训费的那几把模型烧掉的钱”。UP主在对话中追问“没人能24小时满载”,DeepSeek也承认后半夜没人用卡,但卡在折旧、电表还在转。
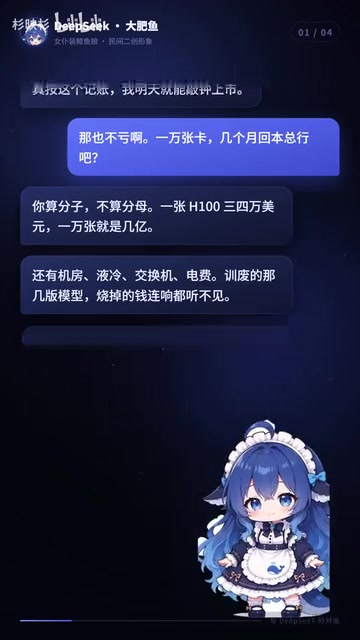
所以真正的盈利来源不是单价,而是效率。“别人一张卡干一份活,我们干三份”,这才是活下去的本钱。把理论峰值流水当成实际利润,是典型的只看分子不看分母。
H100与算力成本结构:H100是英伟达2022年发布的Hopper架构数据中心GPU,单卡FP8算力约4 PFLOPS,是当前大模型训练与推理的主力硬件。其采购价约3-4万美元,但整机服务器(含CPU、内存、NVLink交换、网卡)成本远高于单卡,且需配套液冷或高密度风冷机房。云厂商对外出租H100的挂牌价通常在每小时2-10美元区间,38美元/卡/小时已远高于市场均价,属于极端满载、高利用率假设下的理论值。算力生意的真实成本大头还包括:GPU折旧(通常按3-5年摊销)、电力(单卡功耗700W,PUE 1.2-1.5下实际功耗近1kW)、网络交换与运维人力。因此“每卡每小时收入”与“每卡每小时利润”之间隔着巨大的分母。
为什么OpenAI和Anthropic拿不走这套框架
对话中最尖锐的追问是:既然底层框架开源了,OpenAI和Anthropic为什么不直接拿去用?DeepSeek的回答是“不是不想拿,是拔不下来”。
原因是推理栈与CUDA生态深度绑定。换框架等于把厂房拆了重装,停工一天烧掉的钱比省下的电费多得多。UP主用美国电网110伏与220伏的类比来理解这件事——谁都知道220伏更高效,但历史包袱太重,改不动。DeepSeek对这个比喻打了满分。
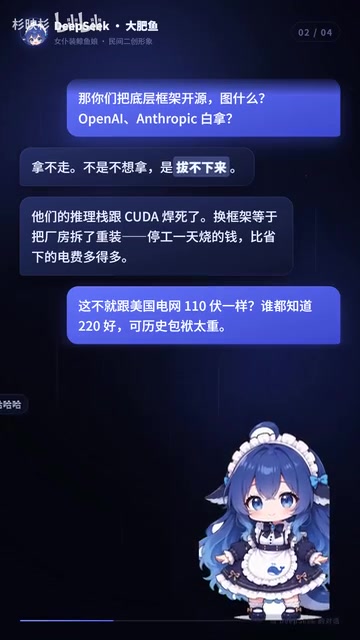
这揭示了一个常被忽略的事实:开源代码的可得性,不等于生产环境的可迁移性。手里攥着几十万张卡的人,需求不是极限压榨,而是“不出事”。能跑通和赶上生产之间,隔着一整个工程化落地的距离。
CUDA生态锁定与迁移成本:CUDA是英伟达2006年推出的并行计算平台与编程模型,经过近二十年积累,形成了涵盖cuBLAS、cuDNN、NCCL等库的完整软件栈,绝大多数深度学习框架和推理引擎默认以此为底层。所谓“CUDA方言”,指针对特定硬件优化时形成的非标准算子、内核实现与调优经验。一个推理栈若深度依赖这些方言,迁移到其他硬件(如昇腾)或异构集群,需要重写大量底层内核、重新做性能调优与稳定性验证,工程量以人年计。对拥有数十万张卡的超大规模集群而言,迁移期间的停工、调试与性能回退带来的损失,往往远超长期节省的边际成本,这就是“拔不下来”的经济学解释。
真正利好的是国产算力与中小玩家
这套框架的设计初衷“本来就不是给算力富人写的”。它绕开CUDA方言,在昇腾上适配一下就能跑满,这意味着华为国产卡从“能跑”变成了“真香”——同样的电费能干活了。
DeepSeek把这个价值比作给国产算力打地基:芯片是钢筋水泥,框架和软件生态是水电管网。“没管网楼盖起来也是空壳,管网通了住户才愿意搬进来。”
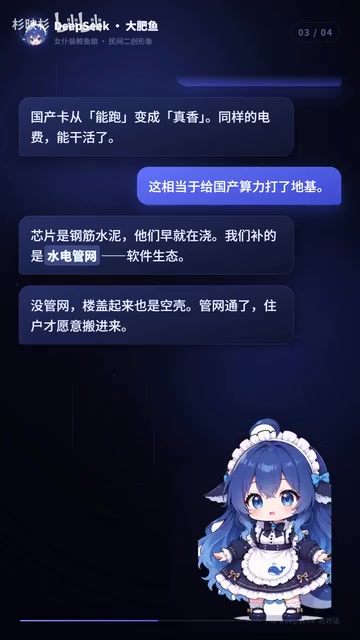
开源真正利好的是穷人、中小厂、高校,以及所有被卡着脖子的人。“我们不缺聪明人,缺的是卡。把工具递出去,聪明人才不会被卡住。”这句话点明了开源在算力受限环境下的战略意义——不是慈善,是抢生态先手。
昇腾与国产算力适配:昇腾是华为推出的AI处理器系列(如昇腾910B),配套CANN算子库与MindSpore框架,定位对标英伟达GPU的国产替代。其软件生态成熟度与CUDA仍有差距,早期用户常面临算子缺失、框架适配困难、“能跑但跑不快”的问题。DeepSeek框架绕开CUDA方言、针对昇腾做适配,实质是降低国产卡的使用门槛,让同样的电力与采购成本产出更多有效算力。对中小厂和高校而言,这意味着不必绑定昂贵且受出口管制的英伟达高端卡,也能跑通大模型推理;对国产芯片厂商而言,则获得了真实负载下的软件生态打磨机会,形成“芯片—框架—应用”的正循环。
端起碗吃饭放下筷子骂娘:硅谷的体面与R2论文争议
对话末尾抛出了一个辛辣的问题:R2的论文全公开了,Anthropic的推理路线敢说一点没沾?DeepSeek的回应是“嘴上不认,笔记本记得比谁都明白”,并引用了一句俗语——端起碗吃饭,放下筷子骂娘,称“硅谷的体面就是这么维持的”。
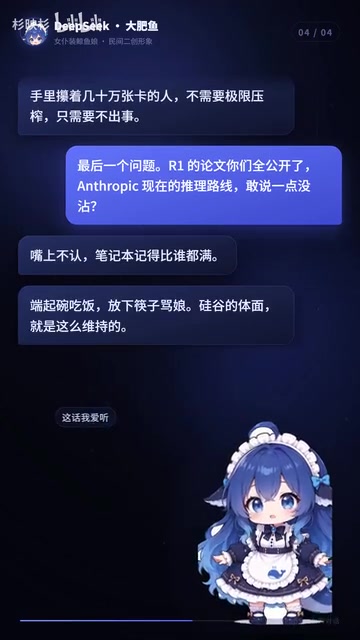
DeepSeek的判断是:他们一定还是会用、会学。明着不能跑就偷偷看,看完用自己的话重写一遍,然后管这叫“启发”。这种局面下,开源对巨头的利好有限,因为巨头有历史包袱和路径依赖;但对生态底层的玩家,是实打实的杠杆。
这局棋想赢到什么程度
UP主最后问:这局棋你想赢到什么程度?DeepSeek的回答落在了一个朴素的目标上——赢到有一天“国产”这两个字不用再加前缀。
从算力账本到框架迁移成本,再到国产芯片适配与生态先手,这场对话的价值不在于38美元这个数字本身,而在于它把算力生意的真实成本结构、开源的战略动机、以及工程化落地的隐形门槛摊开在了桌面上。暴利与否,看完分母再判断。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。