DeepSeek开放App全套API能力,Qwen4定档11.17|AI日报

模型厂商竞争转向开发者交付链路:接口完整性、成本与延迟成为关键。
文章汇总近期 AI 行业多条动态,指出竞争重心正从模型能力本身转向开发者交付链路。DeepSeek 将官方 App 背后的联网搜索、文件解析、网页阅读、OCR、语音识别与合成开放为 API 并开源前端 Demo,前端还上线额度管理,暗示 Coding Plan 临近。阿里 Qwen4 定档 11 月 17 日香港峰会,主打编程与 Agent,Qwen4 Max 预览版已可用。腾讯混元 HY4 在网络安全指数与漏洞修复测试上表现突出且成本低,并与爱迪茂大学开源 Flash TopK,将百万级上下文 Token 筛选从 5.32 秒降至 1.62 秒。推理效率方面,云端新硬件与端侧离线方案分别推进。海外 OpenAI 解散独立机器人团队,谷歌则连发 TPU 与多条 Gemini 产品线。
AI 产品的竞争正在从「谁的模型更强」转向「谁能把能力更顺畅地交付给开发者」。近期几条动态放在一起看,这个趋势相当明显:DeepSeek 把官方 App 背后的整套能力开放成 API,阿里为 Qwen4 定档,腾讯混元在安全与效率上拿出可量化的成绩,而 OpenAI 则对机器人团队做了收缩调整。
DeepSeek:把 App 的「隐形能力」变成 API
据 B 站「我有书的每日AI动态」梳理,DeepSeek广告 官方 App 背后的多项能力现已可通过 API 调用,包括联网搜索、文件解析、网页阅读,以及 OCR、语音识别和语音合成。同时官方开源了前端 Demo,方便开发者直接复用交互层实现。
这批能力的意义在于,它们此前是 App 体验的一部分,开发者很难单独获取。联网搜索和网页阅读解决的是模型知识时效性问题,文件解析与 OCR 处理的是非结构化文档输入,语音识别与合成补齐了多模态交互链路。把这些能力打包开放,意味着开发者不必再自行拼接搜索、解析、语音等多个第三方服务,可以直接在一个接口体系内完成。

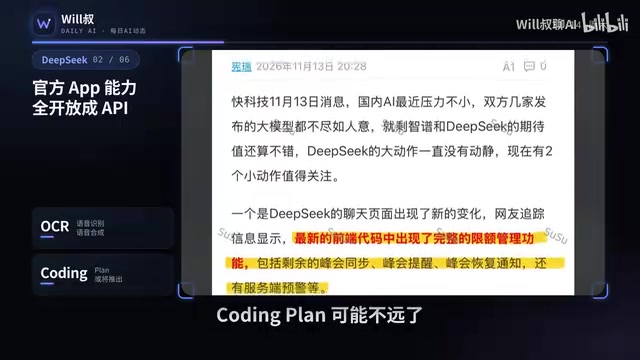
另据快科技报道,DeepSeek 前端已上线额度管理,Coding Plan 可能不远。额度管理通常是付费或配额体系的前置基础设施,这一动作与 API 开放放在一起看,指向的是更完整的开发者商业化路径。
OCR(光学字符识别) 是把图片、扫描件或 PDF 中的文字识别为可编辑文本的技术。在 AI 应用链路中,OCR 常作为文档输入的入口环节:用户上传的合同、发票、截图往往是非结构化的图像,必须先把文字提取出来,模型才能理解内容。它与文件解析的区别在于,文件解析侧重解析 PDF、Word 等格式的内部结构(段落、表格、页码),OCR 则专门处理图像中的文字。两者组合后,才能覆盖绝大多数现实文档输入场景。
语音识别(ASR)与语音合成(TTS) 是语音交互的两端:ASR 把用户说的话转成文本,TTS 把模型的文本回复转成自然语音。二者共同构成语音对话能力,也是多模态交互中最基础的一条链路。此前开发者要自建语音能力,通常需要对接独立的语音服务商,在延迟、鉴权、计费上都要额外处理;官方 API 直接提供后,语音链路可以和文本、搜索能力在同一套接口里组合。
阿里:Qwen4 定档 11.17,主打编程与 Agent
阿里云广告香港峰会将于 11 月 17 日开幕,Qwen4 是绝对主角,主打更强的编程和 Agent 能力。据视频内容,Qwen4 Max 可能当天亮相,其预览版目前已可使用,开放至 11 月 25 日。
编程和 Agent 是当前模型能力竞争最集中的两个方向:前者直接对应开发者生产力,后者决定模型能否在真实任务中自主规划与执行。把这两项作为主打,说明 Qwen4 的定位偏向工程落地而非单纯跑分。
Agent(智能体) 指模型不只是回答问题,而是能围绕一个目标自主拆解任务、调用工具、观察结果并迭代执行的能力。与单轮问答相比,Agent 的核心难点在于多步规划、工具调用的准确性、错误后的自我纠正,以及对长任务的上下文管理。它在工程上依赖函数调用(Function Calling)、结构化输出、长上下文等基础能力。模型在 Agent 场景的表现,直接决定它能否被用于自动化编码、数据分析、办公流程等真实业务,而不仅是聊天演示。因此把编程与 Agent 作为主攻方向,实质是在争夺开发者日常工作流的入口。
腾讯混元:安全指数登顶,Flash TopK 大幅提速
腾讯混元 HY4 在 Artificial Analysis 网络安全指数拿到 58%,漏洞修复测试 76% 排第一,每个任务成本仅 0.92 美元。安全能力与成本同时被量化,对企业在选型时的参考价值更直接。
混元还与爱迪茂大学开源了 Flash TopK,在百万级上下文下挑选 Token 的耗时从 5.32 秒降到 1.62 秒。长上下文场景中,Token 筛选往往是推理链路里不可忽视的开销,这一优化直接压缩了该环节的延迟。
TopK 筛选 是模型推理中的常见操作:在大量候选 Token(或注意力分数)中选出得分最高的 K 个。在百万级上下文场景下,候选数量极大,逐一比较和排序会带来明显的计算与内存开销,成为长上下文推理的瓶颈之一。Flash TopK 针对的正是这一环节,通过更高效的算法实现选出前 K 个结果,把耗时从 5.32 秒压到 1.62 秒。这类底层算子优化虽然不改变模型能力,但会直接影响长文档理解、代码库分析等依赖超长上下文的场景能否实用。
Artificial Analysis 是第三方模型评测与对比平台,会汇总多个基准测试并给出综合指数,常被用于跨厂商横向比较。其网络安全指数关注模型在漏洞识别、安全分析等任务上的表现,与通用能力跑分不同,更贴近企业实际选型时对安全性的关切。
推理效率:从单卡吞吐到离线部署
DeepSeek V4.1 Flash 的推理表现被多方测试。VLMM 在英伟达 VLR Rubin 上将其跑到每块 GPU 每秒 252 万 Token,是 GP300 的 2.7 倍。Exolabs 则把两台 Mac Studio 组合、电池供电、全离线运行,达到每秒 220 个 Token。
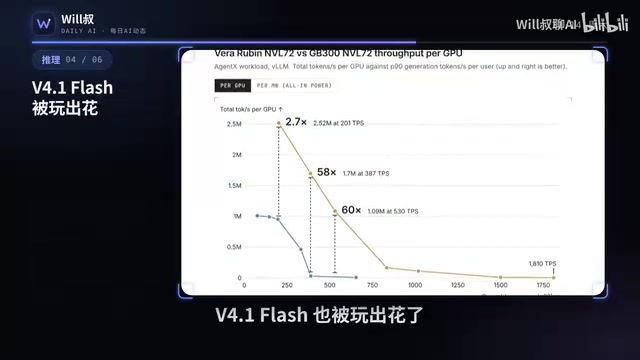
这两个案例代表了效率优化的两个方向:云端靠新硬件把吞吐推到更高量级,端侧靠本地组合方案实现完全离线的可用推理。后者对隐私敏感或网络受限的场景尤其有意义。
OpenAI 收缩机器人团队,谷歌连发多条产品线
海外方面,据去报道,OpenAI 已解散独立的机器人团队,人员并入常规模型训练。今年 5 月底奥特曼还在发推招人,前后也就 4 个多月。团队独立性的取消,通常意味着资源向主线模型训练集中。
谷歌则是满载一周,皮查伊晒出新单:两款第八代 TPU、Gemini 4.0 Carbon、Gemini Robotics 2.5、Alpha Genome 2,再加上 Gemini 4.0 Hydrogen。硬件与模型双线推进,覆盖从算力底座到具体应用场景。
几条动态串起来的信号
DeepSeek 开放 App 能力、混元开源 Flash TopK、阿里把编程与 Agent 作为 Qwen4 主攻方向,共同指向一件事:模型厂商的竞争重心正在从单点能力转向开发者的实际交付链路——接口是否完整、成本是否可控、延迟是否够低。对开发者而言,这意味着可组合的积木更多了;对厂商而言,谁能让这些积木更容易拼起来,谁就更容易被留下。
相关推荐

12k星开源神器free-claude-code:免费模型接入Claude客户端
free-claude-code开源项目获1.2万星,通过反向代理层将免费模型接入Claude客户端,支持61家模型源、RTK上下文压缩和智能熔断多Key轮换,本文深度解析其工作原理、部署方式与性能实测。

团队如何共用 Claude Code?约定文件、评审与权限边界
团队共用 Claude Code 时,如何通过约定文件统一上下文、建立代码评审机制并设置权限边界?本文基于实际演示,梳理三个关键实践,帮助团队安全高效地利用 AI 编程助手。

DeepSeek语音接口实测:10种语言自由切换,1元搭建语音助手
DeepSeek语音接口实测:两个音色支持中文、粤语、英语等十种语言自动识别,还能联网搜索、读取文件。B站UP主不到1元搭出语音助手,并整理出音频格式、120秒时长限制、搜索计费、max tokens设置等文档未写的坑。