DeepSeek开源的真实算盘:用权重换生态与标准

DeepSeek开源是精心计算的交换:用会过期的权重换团队、生态、标准和信任。
文章通过五份证据分析DeepSeek开源策略的商业逻辑:它开放权重、代码、论文和训练基础设施,但保留训练数据管线,属于开放权重而非完整开源AI。创始人梁文峰认为闭源护城河短暂,真正的护城河是团队和文化。极低的训练成本支撑极低定价,使第三方自建部署不划算,因此开源不会冲击其API,但百倍利润会改变这一结论。开源还让云厂商和芯片厂商替其分发,模型越多人用越像标准;开放权重应对西方市场的信任赤字,开源昇腾内核把算力限制转化为生态杠杆。融资条款保留控制权,开源同时成为人才磁铁。结论是DeepSeek把开源当武器,赚生态和未来的钱,算的是十年账。
把最强推理模型的权重免费交给全世界,DeepSeek图什么?B站这期视频把五份证据摆在了一张桌子上,试图算清这笔账。结论并不浪漫:开源不是慈善,而是一场精心计算的交换——用会过期的权重,换不会过期的团队、生态、标准和信任。
开源了什么,又保留了什么
第一份证据先界定边界。DeepSeek广告开放了权重、代码、论文和训练基础设施,许可证允许商用、修改、再分发,甚至蒸馏。但训练数据的完整管线没有开放。严格说,这是开放权重,不是完整意义上的开源AI。
这个取舍很清晰:开放的是能换生态的部分,保留的是能保命的部分。权重交出去能吸引开发者、催生下游应用,而数据管线才是模型迭代的命门,握在手里才有下一代的先手。
开放权重(Open Weights)与开源AI的区别:开放权重指模型训练完成后的参数文件可被下载、修改和再分发,但训练数据、数据清洗管线、训练代码的完整细节未必公开。完整意义上的开源AI(如OSI的Open Source AI定义)要求开放训练数据及其处理流程、训练代码和权重,使他人能复现模型。DeepSeek公开了权重、推理代码、论文和部分训练基础设施,但未开放训练数据的完整管线,因此属于开放权重模型,而非可完全复现的开源AI。这一区别直接影响下游能否独立审计模型偏见、复现训练结果或从头改进数据策略。
梁文峰的判断:护城河在团队,不在权重
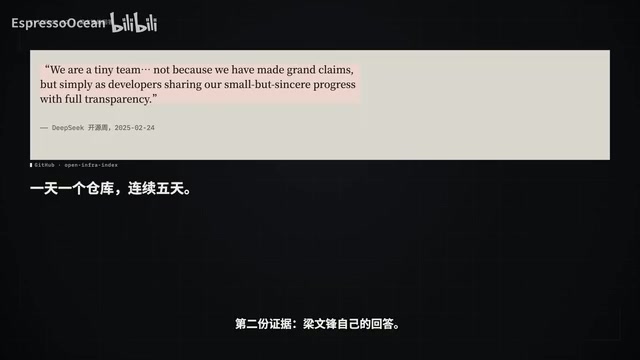
第二份证据是创始人自己的话。2025年开源周,梁文峰把生产环境验证过的代码一天一个全部公开。他的逻辑是,在颠覆性技术面前,闭源形成的护城河是短暂的,真正的护城河是团队、组织和文化。开源更像文化行为,而非商业行为。
这段话值得细读。它把开源从商业策略上升为技术判断:权重会过期,团队不会。先有一个强大的技术生态,比守住一个模型重要得多。
一笔账:为什么开源没有杀死它的API
第三份证据是成本结构。V3的完整训练用了278万8千个H800 GPU小时,按论文假设约557万美元;RE的强化学习阶段只花了约29万4千美元,但建立在约600万美元的V3机座上。2025年3月,V3-0324把许可证改成MIT,转折点就此出现。
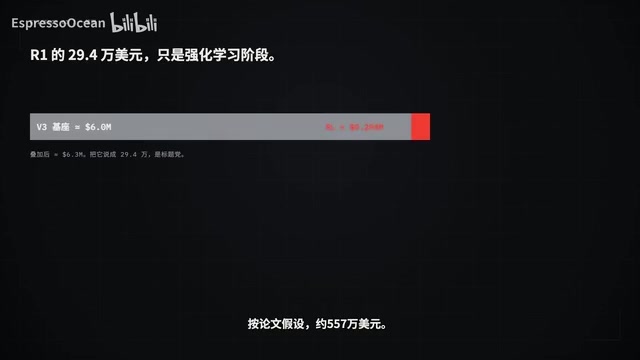
成本压得极低,价格才能压得极低。视频里算过账:按当前定价,大约10个月回本,对应约6倍利润。在这个价位上,第三方自建部署的成本做不到,所以开源不会冲击它的API——想自己部署的人,算完账会发现不如直接调用。但如果它想赚100倍利润,开源就会真正伤害它。
换句话说,开源不是不赚钱,是只赚合理利润。2026年的V4做到1.6T参数、49B激活、100万上下文,V4.1 Flash更便宜,还原深度模态,定价螺丝拧在合理区间。这是一条主动划定的利润红线。
GPU小时与训练成本估算:GPU小时是衡量算力消耗的单位,即一块GPU运行一小时。训练大模型的总成本通常按“GPU数量×运行时长×单价”估算。DeepSeek V3报告使用了278.8万H800 GPU小时,按每GPU小时约2美元的假设,得出约557万美元的训练成本。这一数字仅覆盖单次训练运行的算力开销,不含研发、数据、人工、失败实验和集群闲置等成本,因此常被业界视为“下限”而非真实总支出。极低的训练成本使其API定价可以远低于竞争对手,同时仍保持合理毛利。
渠道与标准:让云厂商替它分发
第四份证据是渠道。DeepSeek没有全球销售团队,也没有品牌积累。开源让AWS、Azure、英伟达、腾讯、百度替它分发。模型越多人用,越像标准。2026年它又开源了Agent框架Harness,两天拿到95000颗星。
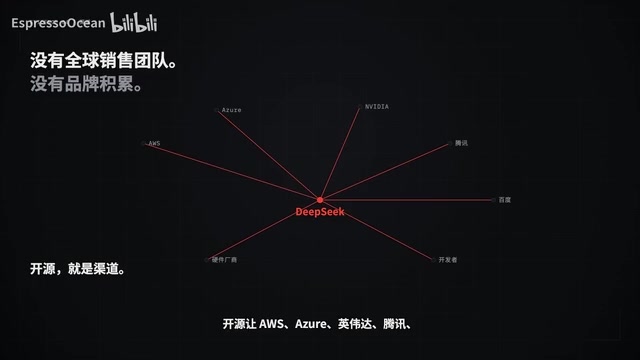
开源不只是模型,它还是入口。当一家公司没有销售队伍时,让全球云厂商和芯片厂商成为分发渠道,是最省力的扩张方式。用得人越多,标准越稳。
信任赤字与算力杠杆
第五份证据有两层。第一层是信任:中国AI公司在西方市场存在信任赤字,开放权重可以下载到自己的云、自己的机房,数据不出境。APP可以被封,权重不能。
第二层是算力。R2在昇腾上训练失败,V4适配昇腾,DeepSeek开源了昇腾内核。算力买不到,就把软件生态做成杠杆。这是被逼出来的策略,也是把限制转化为生态影响力的路径。
昇腾生态与CUDA替代:昇腾(Ascend)是华为的AI芯片系列,配套CANN软件栈,定位为英伟达CUDA生态的国产替代。由于出口管制,高端英伟达GPU获取受限,中国AI公司需要将模型训练和推理迁移到昇腾等国产算力上。但迁移并非简单换硬件,需要重写算子、适配通信库和调优内核。DeepSeek开源昇腾内核,相当于把适配经验回馈给生态,降低其他开发者的迁移门槛。这既是被迫的算力自救,也是一种生态杠杆:软件适配越成熟,昇腾越可用,国产算力生态越强,DeepSeek作为早期贡献者获得标准制定的话语权。
融资与控制权:开源作为人才磁铁
2026年DeepSeek第一次融资,74亿美元,估值500亿美元。但条款保留了创始人的控制权,外部投资者大多没有投票权,五年锁定期。视频给出的动机之一是给员工期权定价,留住核心研究员。
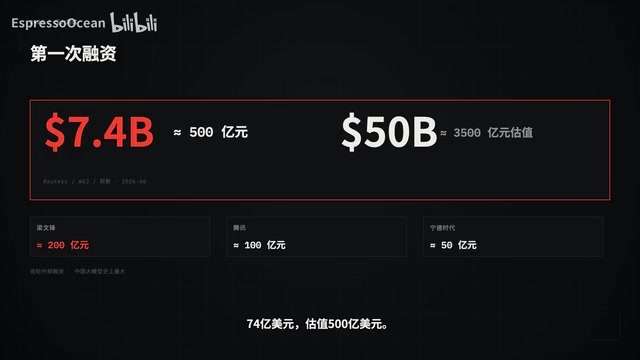
开源在这里扮演了双重角色:它让公司成为人才磁铁,也让人才更可见。研究员在开源社区积累的声誉,本身就是一种激励,也是期权定价的参照系。
开源没有停,但压力在增加
V4、V4.1继续MIT,Harness也开源,开源没有停。但未解的问题还在:V5会不会继续MIT?训练数据会不会开放?视频没有给出答案,这恰恰是这场交换最值得观察的下一步。
回到最初的问题。DeepSeek把开源当武器,不是当慈善;不是不想赚钱,而是选择赚生态的钱和未来的钱。用会过期的权重,换不会过期的团队、生态、标准和信任——这笔账,算的是十年,不是一年。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。