DeepSeek开源DeepGEMM-Ascend:昇腾能否挑战CUDA生态?
DeepGEMM-Ascend为华为昇腾提供矩阵乘法内核,封装底层布局工程,但分组GEMM未实现,整体迁移仍需开发者自行评估。
DeepSeek于2026年9月30日发布DeepGEMM-Ascend,为华为昇腾芯片提供与原CUDA版本接口相似的矩阵乘法内核库。该库封装了昇腾特有的分形布局转换、缩放因子打包、操作数复用和流水线重叠等底层机制,支持BF16、FP8、FP4精度及MQA Logit、MegaMode等操作。然而分组矩阵乘法接口被明确标记为未实现,对MoE架构而言是实质性缺口。库的运行依赖昇腾950系列、CANN 9.20和Torch NPU等硬件软件环境。文章强调,真正与CUDA可比的是CANN整体生态而非单个内核,DeepSeek自测的性能数字仅针对选定内核,无法代表实际工作负载。开发者应逐一映射所需操作、核查环境要求并测量真实负载,而非依赖基准测试表或API兼容性声明。
一次矩阵乘法迁移背后的真问题
把一个矩阵乘法从 NVIDIA GPU 迁移到华为昇腾芯片,看起来只是换一块硬件,实际上却牵扯到软件如何排列数据、如何把数字送进计算单元的全套工程。两款芯片都能做乘法,为什么切换这么难?核心原因在于:数据需要不同的排列方式,以及进入工作存储的不同路径。
DeepSeek广告 于 2026 年 9 月 30 日发布了 DeepGEMM 的 Ascend 版本(DeepGEMM-Ascend),为原本不受支持的操作提供了熟悉的入口和对应机制。这是理解这次发布的起点——它并不是一次性替你完成整个迁移,而是在最底层的矩阵内核上,替开发者分担了大量布局转换与数据移动的工程。
矩阵乘法本身的数学没有变:一行蓝色数据遇到一列橙色数据,对应元素相乘再求和,得到输出网格中的一个位置,在整个网格上重复即可。变化的是围绕这套数学的机制——数据如何在存储中搬运、如何排列、如何送入计算器。
内核做了什么:存储层级与分形布局
处理这类操作的专用代码被称为"内核"(kernel)。昇腾的这个内核把矩阵小块从全局内存移入 L1 缓存,再移入 L0 缓存进行运算。可以把它想象成一个大存储架(全局内存)和靠近计算器的较小工作盘(缓存),容量与访问效率之间始终存在权衡:架子上能放更多数据,但真正计算时,数据放在哪里很重要。
在加载到 L1 缓存的过程中,小块的排列方式会改变——代码使用了所谓的"分形布局"(fractal layout)来索引。算术运算没变,但"座位图"变了。即便在应用层看起来目的相同,在不同芯片间搬动操作仍然需要真正的工程投入:你要求相同的结果,但实现必须按这颗芯片的方式组织工作。
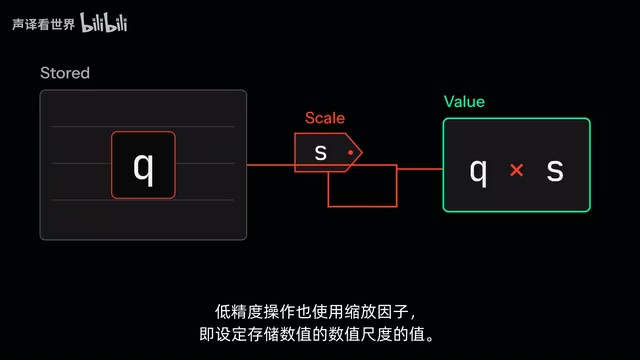
低精度计算还涉及缩放因子(scaling factor),即设定数值尺度的值,可以把它们想象成附着在小块上的标签。昇腾期望这些标签具有特定的打包格式和布局,因此迁移时还要准备这些辅助数据。库中的转换辅助函数会把缩放因子成对打包进 16 位整数容器,排列成代码所称的 MN 优先布局(MN-major layout)。如果张量已经是正确格式,辅助函数可以直接复用;否则就会启动转换——即便这一步准备也需要决策。
分形布局(fractal layout)是昇腾 AI Core 特有的一种多级嵌套数据排列方式。与 NVIDIA GPU 上常见的行优先(row-major)或列优先(column-major)线性内存布局不同,分形布局将矩阵分块后,对每一层分块再进行子分块,并按照硬件计算单元(矩阵计算单元 Cube Core)的访问模式递归嵌套排列。这种"分块套分块"的结构确保了硬件在读取连续内存时能够最大化利用 L0 缓存的带宽,避免跨步访问带来的延迟。代价是:任何来自外部(如 PyTorch 张量)的标准连续布局数据,都必须先经过一次转换才能送入计算单元,而这个转换步骤本身就需要额外的内存拷贝和对齐操作,也是跨芯片迁移时不可绕过的工程环节。
复用与流水线:隐藏的性能机制
回到工作盘的视角:当蓝色小块保持不动、新的橙色小块到达时,通过操作数复用,输入可以保留下来供另一部分工作使用,不必为下一次计算重新获取。把输入留在近处,减少了重复传输。虽然来源并未给出具体的加速数字,但可以清楚看到它避免了哪些重复搬运。
再加一个"第二个工作盘":当一组小块正在为计算供数时,另一个阶段可以同时准备传入数据,借助分级缓冲区和异步请求让这些活动重叠。整条工作台开始像一条生产线——这就是"流水线"(pipeline)。但重叠有前提:计算不能使用尚未到达的数据,当一个阶段依赖另一个阶段时,并行阶段需要同步,就像每个工作盘上都有一个"就绪信号"。
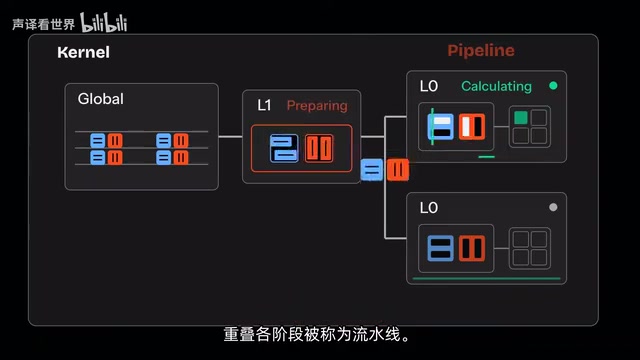
这些存储层级、操作数复用与流水线重叠,共同构成了内核性能的来源,也正是 DeepGEMM-Ascend 替开发者封装好的那部分工程。
覆盖范围与明确的缺口
从这个角度看,DeepSeek 的贡献更容易界定。原始 DeepGEMM 是一个 CUDA 内核库,而 Ascend 版本为昇腾提供了相对熟悉的接口,背后处理着前述的布局与数据移动。
在数值格式上,该库支持 BF16(16 位)、FP8(8 位)、FP4(4 位)。此外还有 MQA Logit(处理多查询注意力中的注意力分数)和 MegaMode(服务于混合专家 MoE 模型)等特定操作。
但支持这些操作并不意味着整个应用已经迁移完成,覆盖率存在具体缺口。尽管仓库声称完全 API 兼容,但实现明确把分组矩阵乘法(grouped GEMM)接口标记为"未实现"。熟悉的入口很有帮助,但你仍需逐一检查应用实际调用了哪些操作。
环境要求同样是硬门槛:根据仓库,开发与验证基于昇腾 950 系列,需要 CANN 9.20 和 Torch NPU。这些要求先于任何性能表现——跑不起来就谈不上快慢。

分组矩阵乘法(Grouped GEMM)是指在一次调用中同时执行多个独立的小矩阵乘法,每组矩阵可以有不同的尺寸,结果也各自独立。这一操作在混合专家(MoE)架构中尤为关键:当模型将不同 token 路由给不同专家(Expert)时,每个专家对应的 token 数量不同,形成了一批尺寸各异的矩阵,用 Grouped GEMM 一次性处理可以大幅减少内核调度开销。DeepGEMM 原本的 CUDA 版本提供了这一接口,DeepSeek 的 MoE 模型也依赖它。Ascend 版本将该接口标记为"未实现",意味着使用 MoE 架构(包括 DeepSeek 自身的 V3/R1 系列)的开发者,在完整迁移之前仍面临实质性缺口。
CANN 与 CUDA:真正的生态对比
一个熟悉的函数名做了很多"公关工作":调用代码得到一个可识别的入口,这很有帮助,但走进去你会发现,数据准备、受支持的操作、必须的软件,仍然决定了应用能否真正跑起来。
CUDA 不只是内核,它涵盖编译器、运行时和驱动接口、数学库、调试工具和分析器。矩阵内核只占这个平台的一小部分,替换它之后,迁移应用时仍需考虑周围的整套软件。华为的 CANN 提供了昇腾的更广泛平台,同样包括编译器、运行时接口、算子与通信库以及分析工具——因此 CANN 才是与 CUDA 更有可比性的对象,而 DeepGEMM-Ascend 只是位于这个更广环境中、为应用提供特定可用操作的一块。
NVIDIA 多年积累的生态——应用移植、合作伙伴库、语言集成、部署工具——正是切换需要工程投入的根本原因。但这些来源并不能告诉你某个具体团队会面临多少工作量:如果可复用的库覆盖了你需要的操作,你或许能直接用它的实现,而不必自己为这颗芯片编写机制。
CANN(Compute Architecture for Neural Networks)是华为面向昇腾 AI 处理器推出的异构计算架构软件栈,其定位与 NVIDIA CUDA 平台对应。CANN 包含算子开发框架(TBE/DSL)、图编译引擎(ATC/GE)、运行时(ACL)、通信库(HCCL,对应 NCCL)以及模型转换与调优工具链。开发者基于 CANN 编写的算子以 TBE(Tensor Boost Engine)描述,经过 TVM 派生的编译器生成昇腾原生指令。与 CUDA 生态的主要差距不在单个内核的计算能力,而在于 CANN 的第三方库覆盖率、调试工具的成熟度、以及与主流深度学习框架(如 PyTorch/JAX)的集成深度——这些在 CUDA 生态中经过了十余年的积累,迁移摩擦的很大一部分正来源于此。
性能数字怎么读,开发者该怎么做
在性能方面,DeepSeek 报告了选定的稠密矩阵乘法结果,接近其声称的硬件上限,测量基于昇腾 950D、CANN 9.20 并使用 L2 性能分析。必须明确:这些是 DeepSeek 自己的数字,不是独立复现的测量,且是在特定条件下的选定内核结果。它们并未确立对 NVIDIA 系统的匹配或胜利,也不代表整个模型的吞吐量。

对考虑昇腾的开发者,合理的路径是:
- 映射操作:列出应用所需的操作,与库的覆盖率逐一比对,特别留意被明确标记为未实现的接口(如分组 GEMM)。
- 检查布局与环境:确认预期的数据布局、软件版本要求(CANN 9.20、Torch NPU、昇腾 950 系列)是否满足。
- 测量真实负载:基准测试表不能代替你在应用内部、连同周围软件一起做的集成测量。你需要知道它在使比较有意义的条件下,究竟表现如何。
可复用的工程是这次发布中最有希望的部分:布局转换、操作数复用、协调加载这些机制,不必每次都成为单独的项目,一个维护良好的库可以为被覆盖的应用处理好这些底层机制。但更广泛的采用仍然取决于三件事——覆盖率、可靠的工具、经过测量的真实性能。
结论很克制:DeepGEMM-Ascend 值得为其支持的操作做评估,它能为你分担一部分迁移工作;但哪些部分仍需你自己动手,取决于你的具体应用。它并未确立一个适用于所有芯片厂商的通用软件层,这次发布的目标,明确且仅限于华为昇腾。
相关推荐

看懂n8n工作流只需四要素:触发、数据、逻辑、动作
学n8n自动化不要只会抄模板。掌握触发、数据、逻辑、动作四个核心要素,你就能看懂任何工作流、独立搭建并在出错时快速调试,从模板搬运工进阶为真正的自动化构建者。
混合RAG检索实战:Dense+BM25+RRF与重排序完整解析
深入解析开源项目 ReRankEval 混合 RAG 检索管线:稠密向量搜索、BM25、RRF 倒数排名融合与 LLM 重排序如何协同,以及用 Hit Rate、MRR、NDCG 科学评测检索质量的完整方法。

Browser MCP 登录会话保活:AI Agent 自动化的隐形门槛
AI Agent 接入 Browser MCP 后登录会话过夜失效、重复认证烧掉大量 token,是自动化落地的常见痛点。本文剖析会话持久化难题的本质,并给出持久化 profile、会话解耦、凭证轮换应对等务实思路。