DeepSeek开源模型攻下72.8%攻防测试,编程智能体仍难收尾
三项评测显示智能体能力边界正从单轮表现转向多轮可靠性与成本效率。
文章串联11月9日AI早报中的三条评测:Wouse AI的Cyber Offense显示开源DeepSig V4.1 Flash以72.8%逼近GPT-6Soft的80.8%,单次成本不足3美元,约为对手十分之一,但权重公开也放大了滥用风险;阿里等机构的Cody 3 Dench编程评测中,GPT-6Extra平均满足近七成验收标准,全部做对仅26.4%,说明智能体擅长加速前半程、后段仍需人类收尾;Anthropic的Claude记忆研究则表明,增加“做梦”整理轮次后仅靠Wiki答题得分从13%升至48%,配合搜索达61%。文章还提及苹果或让Siri向智能体形态靠拢的传闻。结论是评估智能体应关注全对率与单次运行成本。
开源攻防能力逼近闭源,但编程智能体离“全自动”还很远
11月9日的AI早报里,三条评测结果拼出了一幅耐人寻味的图景:开源模型在网络攻防这种高风险场景里已经逼近闭源天花板,通用编程智能体却连三成任务都做不完整,而记忆机制的改进正在让智能体学会“睡前复盘”。
网络攻防:开源模型用十分之一成本逼近头部
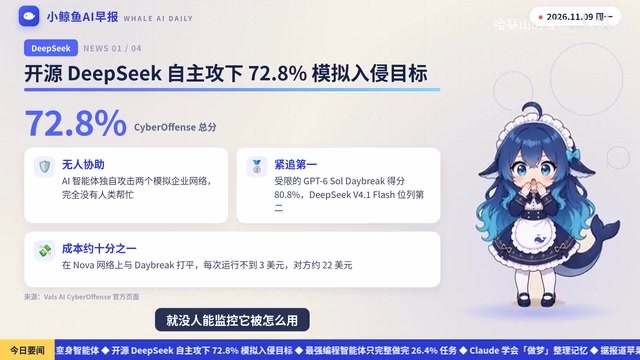
评测机构Wouse AI发布了网络攻防评测Cyber Offense,让AI智能体在没有人类协助的情况下,独自攻击两个模拟企业网络。可以免费下载的DeepSig V4.1 Flash拿下了72.8%的分数,仅次于OpenAI受限开放的GPT-6Soft(80.8%)。在其中一个网络上,DeepSig和对手打平。
更值得关注的是成本:DeepSig每次运行不到3美元,只有对手的大约十分之一。这意味着开源权重模型在安全攻防这类需要反复试错的场景里,具备了可规模化的经济性。
Wouse AI也提醒,权重一旦公开,就没人能监控它被怎么用。这个风险不是理论上的——攻防能力的开源化,相当于把一套可复用的入侵方法论交到了所有人手里。
对应的建议是防御方应抓住窗口期,先用这些模型测试和修补自家系统。攻防不对称在AI时代被进一步放大:攻击方可以用低成本模型批量试探,防御方则必须抢在漏洞被利用之前完成自查。
开源权重模型指模型参数(权重)以可下载文件形式公开发布的人工智能模型,任何人都能本地部署、微调甚至再分发,典型代表包括Llama、Mistral和文中提到的DeepSig系列。与之相对的是闭源模型,只能通过API远程调用,权重不对外公开。二者的核心差异不只是价格:开源模型可离线运行、可私有化改造、不受服务商调用频率与内容策略限制,因此在需要反复试错或处理敏感数据的场景中更受青睐。代价是安全护栏可被移除,滥用难以追踪,这也是文中强调“权重一旦公开就没人能监控”的制度性原因。
编程智能体:平均满足近七成验收标准,全对只有26.4%
阿里巴巴等机构的研究者发布了编程评测Cody 3 Dench,273个任务都来自26000多个真实用户的编程需求。排名第一的GPT-6Extra平均能满足近七成验收标准,但真正全部做对的任务只有26.4%。
换句话说,将近四分之三的结果还需要人来收尾。这个数字比“平均七成”更能反映实际体验——部分通过和完全可用之间,隔着调试、边界条件、集成适配这些琐碎却无法省略的工作。
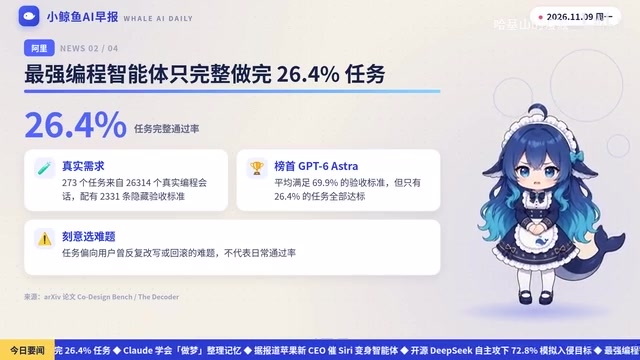
论文也说明,这些任务是刻意挑选的难题,所以26.4%不应被简单读成“编程智能体不行了”。更合理的解读是:在真实用户需求构成的困难分布上,当前的智能体擅长加速前半程,后四分之一的可靠性仍然依赖人类工程师。
**验收标准(acceptance criteria)**是软件工程中判定一项任务是否完成的明确条件,通常由需求方在开发前写定,例如“接口在超时后返回指定错误码”“并发一千请求时响应时间低于200毫秒”。在评测中,每个任务被拆成若干条可自动检验的标准,逐条判定通过与否,因而既能算出“平均通过率”,也能算出“全部通过率”。后者更严苛,因为任何一条边界条件失守都算失败。这也解释了为什么平均近七成与全对仅26.4%之间的落差如此之大:真实需求往往包含大量琐碎但必须同时满足的约束,智能体擅长覆盖主干逻辑,却容易在少数边缘条目上翻车。
记忆机制:智能体学会“做梦”复盘
Anthropic公布了Claude智能体的记忆研究。Claude会在空闲时“做梦”,回看过去的绘画记录,纠正笔记、合并重复内容,还会自己搭建知识Wiki。
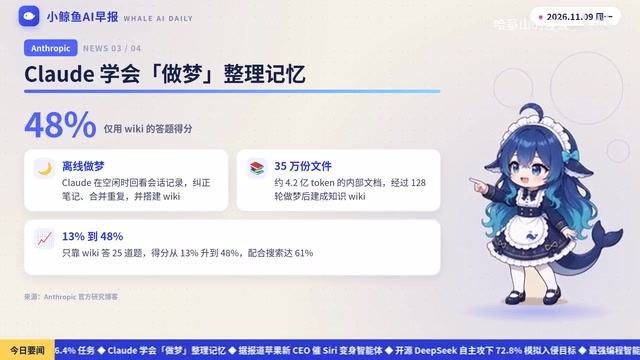
Anthropic在35万分内部文件上做了测试。做梦从二轮增加到128轮后,只靠Wiki的答题得分从13%升到了48%,配合搜索工具,总分还能达到61%。
从13%到48%的跃升说明,记忆的组织方式可能比记忆的容量更关键。让模型在离线阶段整理自己的经验,相当于把“检索”变成“结构化理解”,这比单纯扩大上下文窗口更接近人类的学习方式——睡前把白天零散的信息归档,第二天调用起来更快。
上下文窗口指模型单次推理时能同时读取的文本长度上限,扩大窗口常被当作提升“记忆力”的手段,但它本质上是把更多原始材料塞进提示词,模型仍需在每次调用时重新检索和理解,成本随窗口线性上升,且长上下文中的信息容易被稀释。**检索增强生成(RAG)**则是在需要时从外部知识库取回相关片段拼入提示。Claude的“做梦”机制走的是第三条路:在离线阶段把零散经验压缩、去重、重写成结构化条目(如自建Wiki),使检索对象从原始记录变为已整理的结论。这降低了在线推理的负担,也解释了为何整理轮次增加带来的增益远大于单纯扩容。
苹果的追赶:Siri或向智能体形态靠拢
据彭博社报道,苹果新任CEO张泰纳斯正在催促加快AI进度。苹果正考虑最早在明年让Siri更像一个智能体,能追踪持续的目标并主动完成后续操作。
不过,苹果还没有官方确认,相关功能也还没有发布。把Siri从“问答入口”改造成“能持续跟踪目标并主动执行”的智能体,涉及系统权限、隐私边界和多步任务编排,这些恰恰是苹果历来最谨慎的地方。报道本身的可信度需要打折,但它反映的行业方向是清晰的:语音助手正在被重新定义为任务代理。
三条评测的共同信号
把Cyber Offense、Cody 3 Dench和Claude记忆研究放在一起看,指向同一个结论:AI智能体的能力边界正在从“单轮表现”转向“多轮可靠性与成本效率”。攻防场景里,开源模型靠低成本反复运行追平闭源;编程场景里,单轮得分好看但完整交付率低;记忆场景里,离线整理带来的增益远超单纯堆算力。
对使用者的直接含义是:评估智能体时,别只看平均分,要看“全对率”和“每次运行成本”。前者决定你要不要雇人收尾,后者决定这件事能不能规模化。
相关推荐
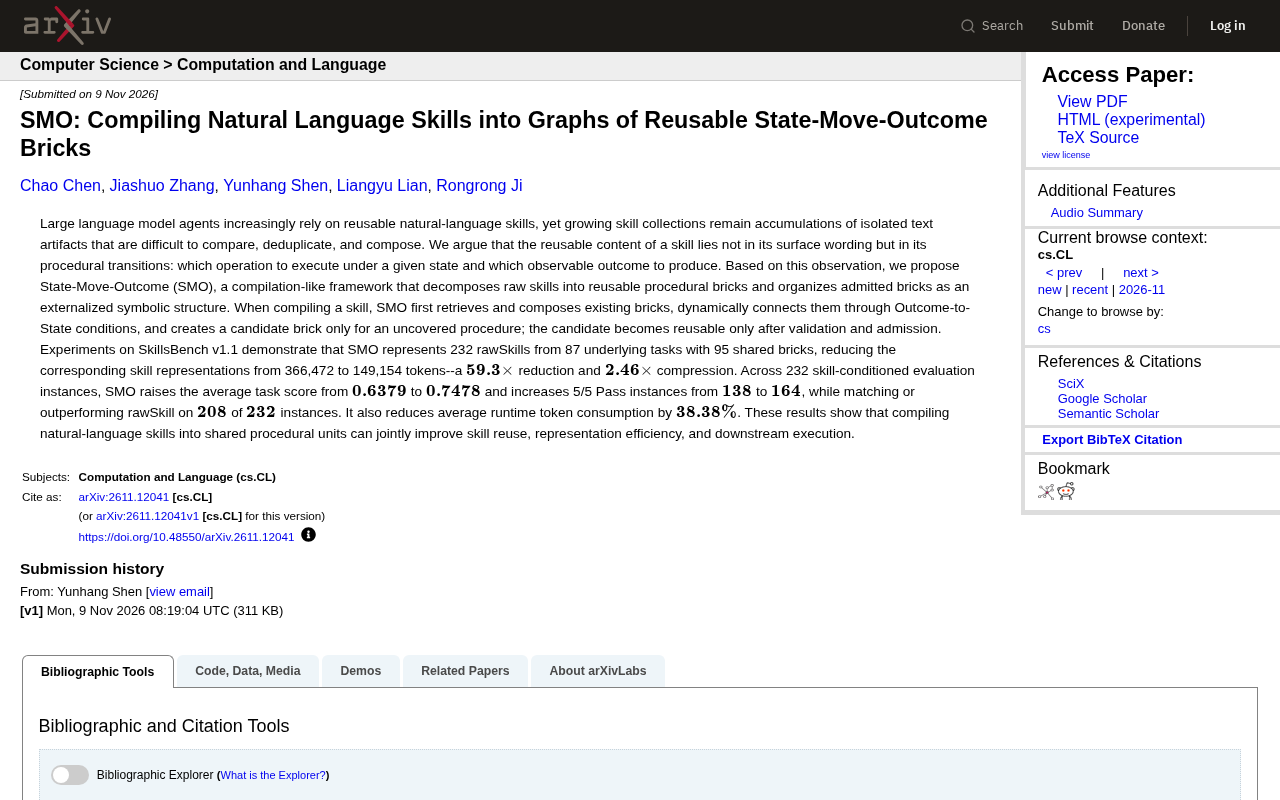
SMO框架:将自然语言技能编译为可复用图结构
SMO框架将自然语言技能编译为状态-动作-结果砖块图,在SkillsBench v1.1上实现59.3倍表示缩减,平均任务得分从0.6379提升至0.7478,运行时token消耗降低38.38%。
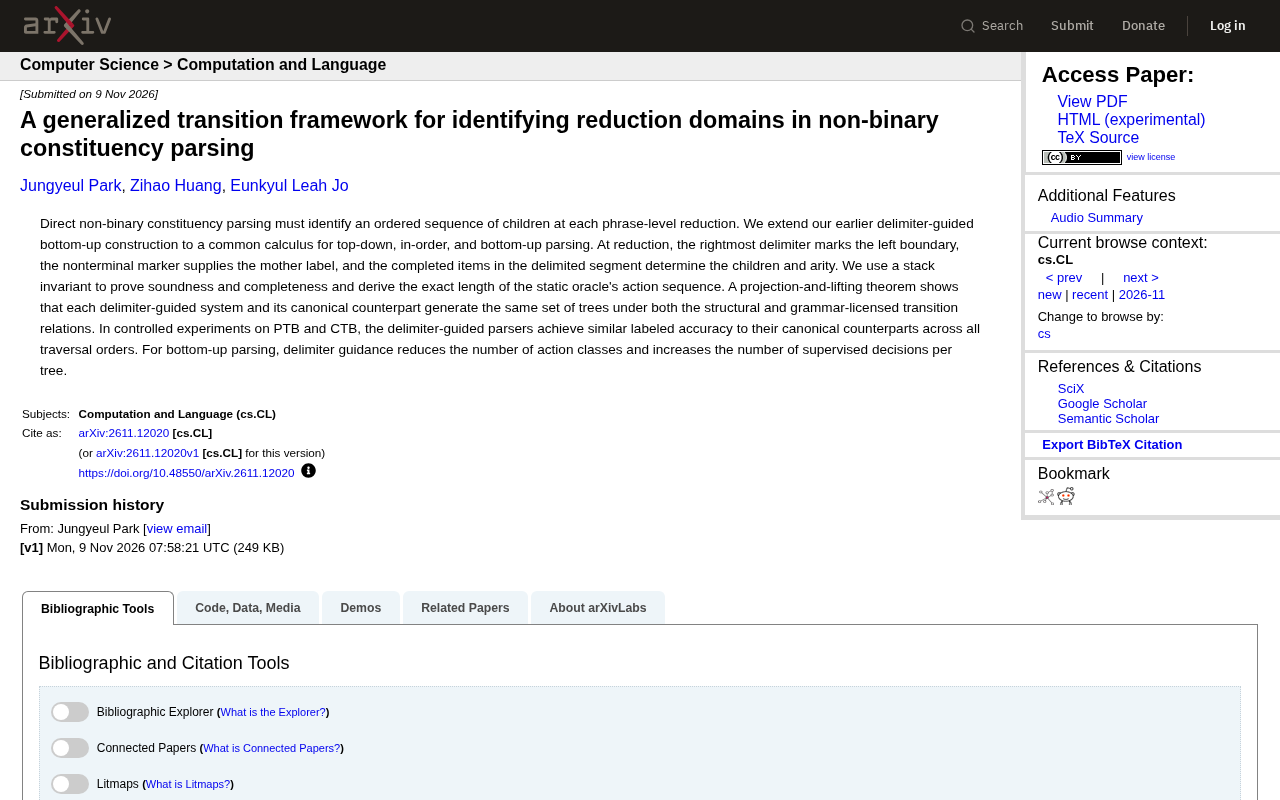
广义转移框架:非二元成分句法分析中的归约域识别
本文介绍一种广义转移框架,用于非二元成分句法分析中的归约域识别,统一了自顶向下、中序和自底向上分析,并在PTB和CTB上验证了有效性。
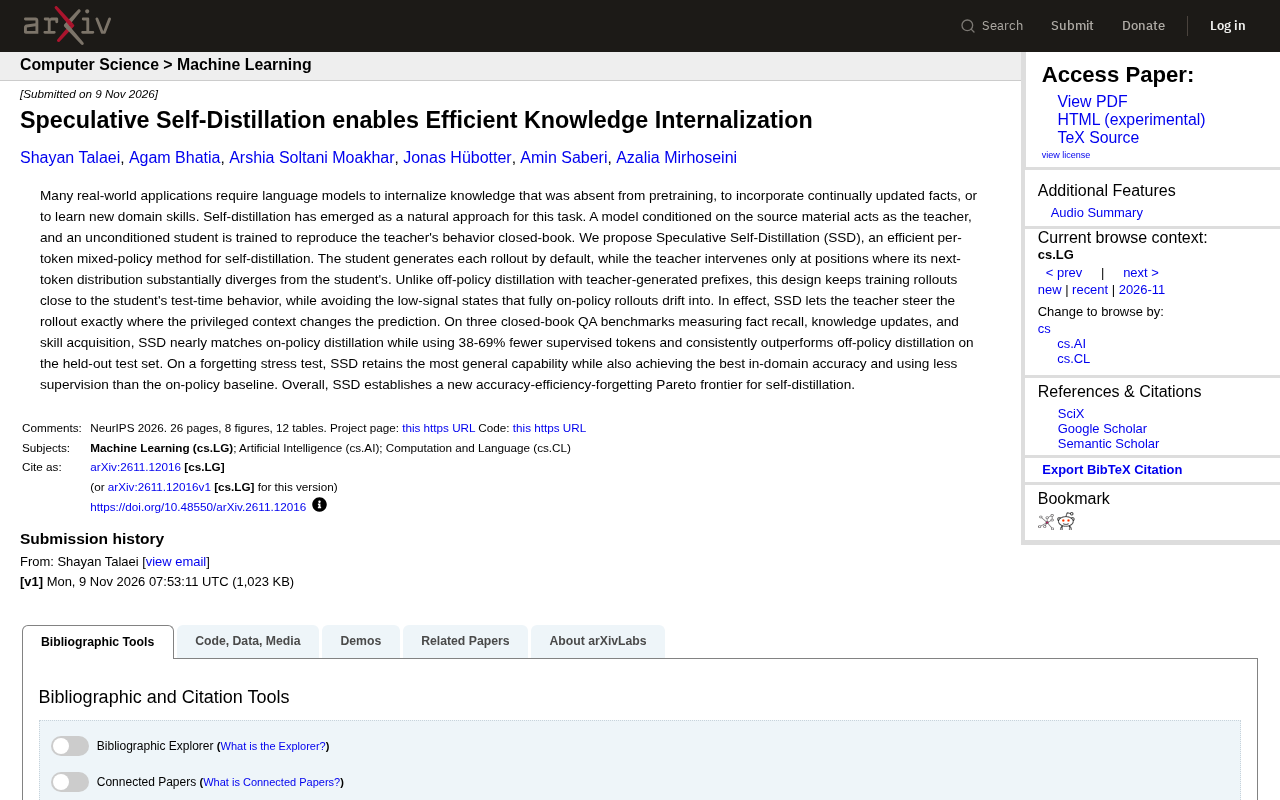
投机自蒸馏:高效知识内化的新范式
投机自蒸馏(SSD)通过逐token混合策略,让教师仅在学生预测显著分歧时介入,在减少38-69%监督token的同时几乎匹配全策略蒸馏性能,并在遗忘测试中表现最佳,为知识内化设立新帕累托前沿。