DeepSeek开源推理框架DeepInfer,海外网友:这才是真正的OpenAI

DeepSeek开源生产级推理框架DeepInfer,把竞争引向部署经济性。
DeepSeek在发布V4.1 Flash(1017版本)仅三天后,于10月20日开源配套推理框架DeepInfer,目标是压低推理算力成本与能源消耗。与常见的开源模型权重不同,这次放出的是经过生产验证的推理栈,海外开发者认为它直接决定成本与延迟,比权重本身更有价值。评论呈现两类叙事:一类视其为行业加速器,期待本地低成本部署;另一类带有中美AI竞争情绪,如"中国会赢得AI竞赛""真正的OpenAI"。文章指出,需区分社区情绪与商业现实——闭源厂商的护城河还包括产品集成与企业服务,但开源推理栈确实把竞争维度部分转移到部署经济性上。
DeepSeek在开源路线上又迈出一步。距离DeepSeek V4.1 Flash(1017版本)发布仅三天,团队于10月20日开源了配套推理框架DeepInfer。这个框架的目标很直接:压低模型推理的算力成本,同时降低能源消耗。消息在海外开发者社区迅速发酵,B站UP主整理的评论合集中,不少海外网友给出了相当高的评价——有人直接称其为"真正的OpenAI"。
DeepInfer开源了什么:生产级推理栈,而非模型权重
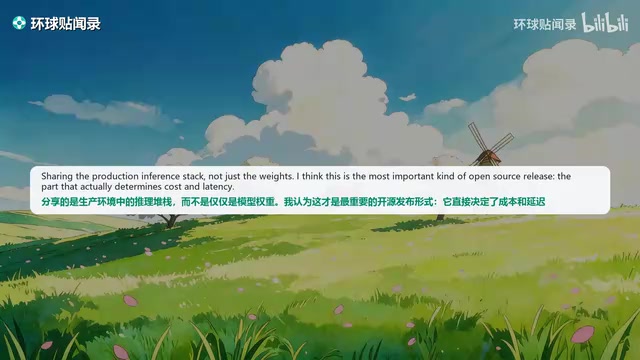
这次开源的特别之处在于,DeepSeek广告放出的不是模型权重,而是生产环境中的推理栈。据B站UP主整理的海外评论,一位网友强调:"能发模型权重,也能发让模型以低成本运行的捷径,但分享的是生产环境中的推理栈,而不是仅仅是模型权重——我认为这才是最重要的。"
这句话点出了当前开源AI生态的一个结构性缺口。多数团队乐于开源模型权重,因为权重本身不直接暴露工程护城河;但推理栈涉及成本、延迟和部署效率,是真正决定模型能否落地的环节。DeepSeek把这一层也开放出来,意味着开发者不仅能拿到模型,还能拿到一套经过生产验证的低成本运行方案。
海外网友的反应:从GPU账单到行业竞争格局
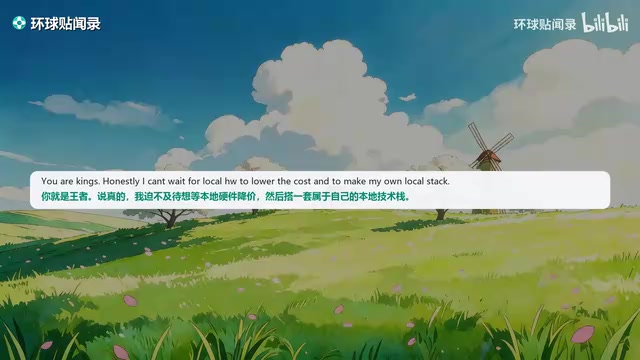
评论合集中最直观的一类反馈来自成本压力。有网友表示"我的GPU账单已经先松了一口气",也有人直言"迫不及待想等本地硬件降价,然后搭一套属于自己的本地技术栈"。这类声音反映的是中小开发者和独立研究者长期面对的现实:推理成本是能否持续实验的关键约束。
更深一层的讨论指向行业竞争。一位网友的评论被截图记录:"这就是为什么我认为中国会赢得人工智能竞赛。"另一位则从人才角度分析:"外面的专业人才和天才远比任何一家公司的开发团队所能拥有的多。"这类观点未必全面,但它揭示了开源策略的一个杠杆效应——通过开放核心工程能力,吸引外部人才在生态上叠加创新。
海外评论中反复出现的"GPU 账单"压力,与推理成本的构成直接相关。大模型推理的开销主要来自 GPU 显存占用与算力消耗:显存决定了能同时服务多少并发请求(批大小),算力决定了每个 token 的生成速度,二者共同换算成单位 token 的美元成本。业界常用的优化手段包括权重量化(INT8/FP8/INT4)、KV Cache 复用与分页、连续批处理(continuous batching)、投机解码等,这些技术能把同一模型在同等硬件上的吞吐提升数倍。因此,推理栈的工程优化水平,往往比模型参数量更能决定中小团队的实际账单。
开源推理栈为何比开源权重更重要
要理解这次开源的分量,需要区分两个层次。模型权重决定了模型能做什么,推理栈决定了做同样的事要花多少钱、等多久。在真实业务中,后者往往才是瓶颈。一个能力不错的模型,如果推理成本过高或延迟不可接受,就无法进入生产环境。
据海外网友评论,DeepSeek放出的"直接决定了成本和延迟"。这也解释了为什么有人用"真正的open AI"来形容这次动作——不是指公司名称,而是指开放的程度触及了AI落地的核心环节。评论中还有一句被反复提及的判断:"前沿AI实验室应该向DeepSeek团队学习。"
推理栈(Inference Stack) 指模型训练完成后、面向用户提供服务时所需的一整套软件与工程组件,通常包括推理引擎(如 vLLM、TensorRT-LLM、SGLang)、算子与内核优化、量化与 KV Cache 管理、批处理与调度策略、多卡并行与显存管理,以及服务化部署接口。它决定一个已训练好的模型在给定硬件上能以多快速度、多少显存、多少电费完成一次前向计算。
与之相对,模型权重只是神经网络训练收敛后保存的参数文件,本身不包含任何运行逻辑。权重开源意味着他人可以复现模型能力,但要在自己的硬件上高效跑起来,仍需自行解决推理引擎适配、算子融合、批处理调度等大量工程问题。这正是 DeepInfer 这类推理栈开源的价值所在:它把"跑得便宜、跑得快"的工程经验一并交了出来。
对比与分歧:开源策略的两种叙事
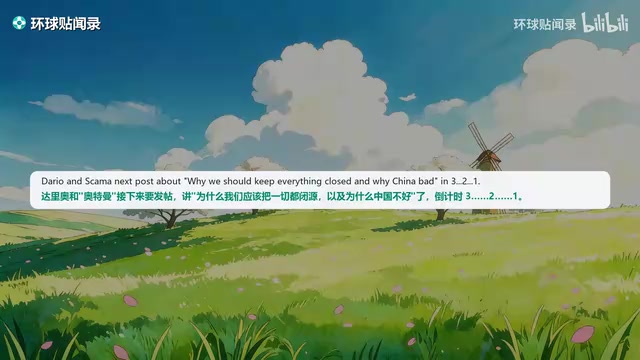
海外评论并非铁板一块。一类声音把DeepSeek的开源视为行业加速器,认为"盈利性公司要完蛋了"、"你们真的想加速整个行业的发展";另一类则带着竞争叙事,评论中出现了对达里奥和奥特曼的调侃,甚至模仿政治修辞的段子:"这场仗要打多久,我想我们不要做决定……一直打到完全胜利。"
需要指出,这些是社区情绪的表达,不能当作对商业格局的严谨预测。开源推理栈确实会拉低行业成本曲线,但闭源厂商的护城河不只是推理效率,还包括产品集成、企业服务和生态锁定。DeepSeek的动作更准确的解读是:它把竞争维度从"模型能力"部分转移到了"部署经济性",而这恰恰是开源社区最擅长的战场。
评论中提到的"达里奥和奥特曼"分别指 Anthropic CEO Dario Amodei 与 OpenAI CEO Sam Altman,两人是当前闭源前沿实验室的代表人物,也是"开源是否安全、是否应加速"争论中的核心声音。开源权重模型(如 Llama、Qwen、DeepSeek 系列)允许任何人下载并在本地运行,与仅提供 API 的闭源模式形成对照。围绕开源的争论通常集中在两点:一是安全风险,即权重一旦放出便无法收回;二是商业影响,即低成本开源模型是否会压缩闭源厂商的定价空间。理解这一背景,才能看清社区情绪背后的真实分歧。
对开发者的实际意义
对于一线开发者,DeepInfer的价值不在于口号,而在于能否真正降低自建推理服务的门槛。从评论反馈看,期待主要集中在本地化和低成本部署上。如果这套推理栈能在常见硬件上稳定运行,中小团队评估模型的时间和经济成本都会下降。
三天内连续发布模型和推理框架,节奏本身就传递了信号:DeepSeek把工程效率当作核心竞争力在打。海外网友的"真正的OpenAI"评价或许带着情绪滤镜,但它指向一个事实——在开源推理基础设施这件事上,DeepSeek确实走在了前面。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。