DeepSeek开源推理引擎:80%毛利碾压硅谷,硅谷抄作业却发现缺流水线
DeepSeek开源推理引擎DeepInfer,用系统工程把单位token成本压到同行难以复制的水平。
DeepSeek 公开数据中心真实运营数据并开源推理引擎 DeepInfer 与 Rust 网关 DeepSeek Recipe,回应了外界对其低价靠烧钱补贴的质疑。文章拆解了其成本优势的来源:因果编码器-解码器架构把 40 层网络拆成读取与写入两半,混合专家设计按需唤醒参数;工程层面用宽专家并行、EPLB 动态负载均衡、dSpark 推测解码和有界重放四招,把显存流量、排队等待和上下文重读的浪费逐一削掉。硬件上支持 Blackwell 与华为昇腾 950、跳过 Hopper。但 100PB 存储、网络路由与全球负载均衡仍闭源,完整复刻需 128 卡级部署。竞争焦点正从模型能力转向智能交付成本。
过去一年,科技圈最大的谜团之一就是:DeepSeek 凭什么能把模型调用价格压到那么低?硅谷同行一边付着高昂的云账单,一边看着 DeepSeek 近乎“送智能”的定价,普遍猜测这是一场烧钱换市场的 bluff。直到 DeepSeek 把数据中心里的真实数字和生产软件一并公开,这个猜测才被彻底打破。
据 B 站 UP 主搬运的美国科技博主分析,DeepSeek广告 单个集群每天处理 155 万亿 token,相当于每秒生成约 18 亿词;即使在折扣时段,单块 GPU 每小时也能产生约 38 美元收入。而企业级 AI 芯片每小时运行成本通常在 5 到 10 美元,这意味着 DeepSeek 的毛利率估算高达 80%。
从“不可能”到 GitHub 开源:DeepInfer 与 DeepSeek Recipe
一年半前,DeepSeek 曾告诉社区,开源生产级服务代码“不可能”,因为它与私有数据中心耦合太深。如今他们兑现了承诺,把驱动这套系统的推理引擎 DeepInfer 和配套网关 DeepSeek Recipe 放上了 GitHub。开源后 24 小时内,仓库星标突破 9000,随后逼近 2 万,开发者蜂拥而入想看看里面到底有什么。
这不仅仅是一次代码捐赠。它把“低价”从商业策略问题,变成了工程效率问题:DeepSeek 不是靠补贴维持价格,而是靠架构和调度把单位 token 成本压到了别人难以复制的水平。
架构级拆解:把40层流水线砍成两半
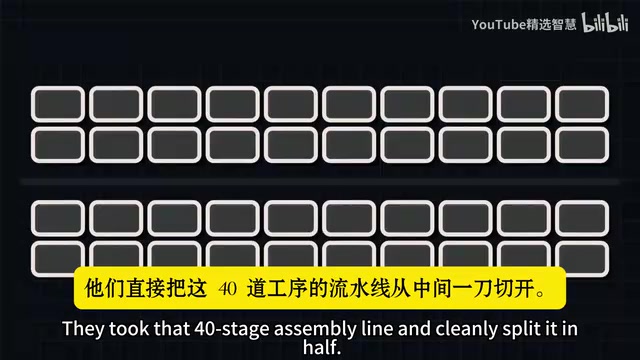
传统大模型处理一个长 prompt 时,必须把每个词过完所有网络层才能写出第一个字,这个“阅读阶段”极其耗算力。DeepSeek 用因果编码器-解码器设计,把典型的 40 层流水线干净地切成两半:前 20 层做专用读取器,后 20 层做写入器。prompt 进来只跑前 20 层,后 20 层通过数学投影直接获得信息,阅读工作量当场减半。
模型本身是混合专家架构:总参数 7480 亿,但读取 prompt 只唤醒 800 亿参数,生成答案唤醒 1600 亿参数。这种“按需唤醒”让算力花在刀刃上,而不是让整个网络空转。
因果编码器-解码器(Causal Encoder-Decoder) 是理解这套架构的关键。传统 Transformer 解码器处理 prompt 时,每个 token 必须依次经过全部层,且生成阶段还要复用这些层的 KV 缓存,导致“阅读”和“写入”共享同一套参数、互相牵制。DeepSeek 的设计把前若干层专门用作编码器,只负责把 prompt 压缩成一组表示;后若干层作为解码器,通过一个数学投影(而非逐层前向)直接接收编码结果并开始自回归生成。这样做的前提是编码器输出与解码器输入在维度上对齐,投影矩阵在训练中习得。代价是编码器不再参与生成,因此读取与写入的参数可以分别针对算力密集和带宽密集两种负载独立优化——这正是后文宽专家并行能拆分部署的结构基础。
DeepInfer 的四招工程拳
第一招:宽专家并行,把100本书分给128个人
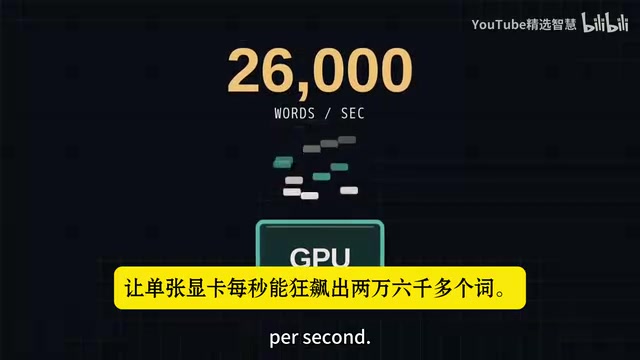
读取和写入是两类完全不同的问题:读取吃算力,写入吃显存带宽。每生成一个词,GPU 都要从显存里搬运数十亿个权重数字。DeepSeek 的做法是:读取用便宜的 8 卡服务器,写入则把 64 到 128 块 GPU 连成超级节点,并把 384 个专家分散到 128 块芯片上,每块只持有约 7 个专家。原本一个人扛 100 本书,现在 128 人每人拿一两本,显存流量下降近 88%,单 GPU 每秒可输出超过 26000 词。
混合专家(MoE, Mixture-of-Experts) 是文中“按需唤醒”的底层机制。标准稠密模型每个 token 都要过全部参数;MoE 把前馈层拆成许多“专家”子网络,再由一个路由网络为每个 token 选择 top-k 个专家激活。DeepSeek 的 7480 亿总参数中,读取阶段只激活约 800 亿、生成阶段约 1600 亿,其余参数处于休眠,因而单 token 的浮点运算量远低于同等总参数的稠密模型。但 MoE 的工程难点在于:专家分布在不同 GPU 上,路由会产生 all-to-all 通信,且负载天然不均——这正是 EPLB 要解决的问题。理解 MoE 后就能明白,“宽专家并行”不是简单把模型切碎,而是让显存容量与激活稀疏度匹配,从而把瓶颈从算力转移到可控的通信与调度上。
第二招:EPLB 负载均衡,像超市临时加开收银台
专家并行带来一个现实问题:如果大量用户都在问编程问题,编程专家会被打爆,创意写作专家却闲置。一块 GPU 耗时 50 毫秒,其余 127 块 5 毫秒完成,整个系统还是得等最慢的那块。DeepInfer 的 EPLB 持续监控流量,一旦发现某个专家过载,就动态在空闲 GPU 上复制该专家的副本。就像超市排队时立刻加开四个收银台,集群几乎不浪费空闲时间。
第三招:dSpark 推测解码,提前弃掉坏赌注
dSpark 本身不是全新研究,但被直接烘焙进引擎后效果显著。一个小而快的辅助模型先草拟接下来五个词,大模型一次性验证。传统推测解码的问题是,即使第三个词错了,第四、五个词也已经白白验证。DeepSeek 给草拟器加了“置信头”,实时计算大模型接受每个词的概率,发现第四个词不靠谱就提前截断,只让大模型验证前三个。这种“ disciplined gambler”式的提前弃牌,在不掉准确率的前提下再提升集群速度 4% 到 7%。
推测解码(Speculative Decoding) 是一种用“小模型草拟、大模型验证”来加速自回归生成的技术。大模型逐个生成 token 时,每步都要搬运全部激活权重,GPU 算力大量闲置在显存带宽上;推测解码让廉价草稿模型一次猜出多个候选 token,大模型只需一次前向就能并行验证这些候选,若接受则一步产出多个词,从而摊薄每 token 的带宽开销。其正确性依赖“验证分布与目标分布一致”的接受-拒绝采样规则,因此不会改变输出质量。传统实现的问题在于固定草拟长度:一旦中途某个 token 被拒,其后候选全部作废。dSpark 的置信头相当于给每个候选打上被接受的概率,提前截断低置信部分,减少无效验证,这也是它能在不掉准确率的前提下再挤出 4%–7% 吞吐的原因。
第四招:有界重放,离开几小时回来也不用重读全文
长对话的上下文极其吃存储,AI 公司常被迫清理记忆。真正的瓶颈出现在用户离开两小时再回来追问时,服务器通常要从头重读整个对话。DeepSeek 的 bounded replay 把活跃对话记忆只放在超快本地 RAM 里约三分钟,覆盖快速来回聊天;如果 RAM 已清空,服务器也只重读最后约 140 词。无论 prompt 是 1000 词还是 100 万词,补上缺失上下文的耗时几乎可以忽略。
Rust 网关与硬件路线:绕过 Hopper,支持昇腾
DeepSeek Recipe 用 Rust 编写,在 prompt 到达 GPU 前完成分词。它按结构边界拆分 prompt,在所有 CPU 核上并行 tokenize,同时充当安全缓冲层:如果用户试图注入恶意系统命令,输入会被强制编码为纯文本,攻击被彻底中和。
硬件支持上,DeepInfer 明确支持 NVIDIA 新一代 Blackwell 架构和华为昇腾 950 芯片,却跳过了 Hopper 架构的 H100/H200。在美国出口限制收紧的背景下,这套每天 155 万亿 token 的系统展示了在国产硅片上以一线规模运行的可能性。
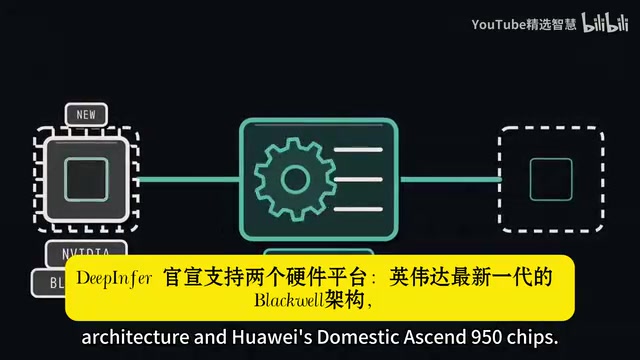
Hopper 与 Blackwell 是 NVIDIA 两代数据中心 GPU 架构:Hopper(H100/H200)主打 FP8 训练与 Transformer 引擎,Blackwell 则进一步引入更大显存、更高带宽与对 FP4 等低精度格式的支持,并强化了多 GPU 互联。DeepSeek 跳过 Hopper 而直接适配 Blackwell,一方面是因为新集群采购自然倾向最新一代,另一方面也意味着其内核针对 Blackwell 的显存层级与互联拓扑做了专门调优,而非在旧架构上兼容运行。华为昇腾 950 属于国产 AI 加速器路线,软件栈与 CUDA 生态不同,DeepInfer 对其提供支持,说明引擎在算子层做了抽象,能够在非 NVIDIA 后端上编译运行。在出口管制收紧的背景下,这种多后端能力使同一套调度与并行策略可以跨芯片迁移,也是文中“在国产硅片上以一线规模运行”的技术前提。
开源的不是整座工厂:三道门槛仍在
DeepInfer 给的是引擎,不是整座工厂。DeepSeek 在文档里明确列出了保留项:100PB 存储集群(每秒推送 10TB 数据)、专用网络路由系统、全球互联网负载均衡器。换句话说,他们给了世界一台高性能商用烤箱,却把自动化工业面包线留在了自己手里。要跑出文中的速度,你仍需要至少 128 块 GPU 的企业级部署,并运行其旗舰模型 DeepSeek v4.1 Flash。
这意味着什么
过去两年的叙事是“谁买最多 GPU 谁赢”,DeepSeek 反复证明聪明的系统工程可以战胜暴力堆钱。这对靠托管开源模型收取高溢价的云厂商构成直接压力,而 VLLM 等社区推理引擎的开发者显然已经在翻代码,准备把这些加速技巧搬进人人可用的工具里。竞争焦点已经从“谁做出最聪明的模型”,转向“谁能以最低成本交付智能”。
核心要点
- DeepSeek 公开数据中心真实数据:单集群日处理 155 万亿 token,单 GPU 每小时约 38 美元收入,毛利率估算 80%,并非烧钱补贴。
- 开源推理引擎 DeepInfer 与 Rust 网关 DeepSeek Recipe,24 小时内 GitHub 星标近 2 万。
- 架构上把 40 层网络拆成读取/写入两半,结合 7480 亿总参数、按需唤醒的混合专家设计,从底层削减算力浪费。
- 四招工程优化——宽专家并行、EPLB 负载均衡、dSpark 推测解码、有界重放——共同支撑低成本高吞吐。
- 硬件上支持 Blackwell 与华为昇腾 950,跳过 Hopper;但 100PB 存储、网络路由和全球负载均衡仍闭源,完整复刻需要 128 卡级企业部署。
相关推荐
多AI代理协作冲突终结者:Git工作树实战指南
多个AI编程代理共享仓库时互相覆盖?Git工作树是根本解决方案。本文解析Claude Code、Claude Squad、Conductor、Vibe Kanban等工具的隔离机制与取舍,并给出选型建议。
Cognition开源Devin漏洞修复插件,AI编程代理效率与成本新研究
Cognition 开源 Devin 漏洞修复插件,覆盖 PHP、Node.js、GitLab;研究揭示编码代理工具复杂度与成功率脱钩、成本翻三倍;Microsoft Agent Grid 支持 1024 代理无中心协调;Entropic 发布无容器沙箱;Python 3.15 新增采样分析器。
AI Agent自己买服务器:MCP与VPS的自动化革命
探索AI Agent通过MCP协议自主购买VPS服务器的完整流程:从ClaudeCode连接EQVPS、加密货币预付费充值,到Agent自主下单、监控服务器并在破坏性操作前请示用户。分析Agent经济的支付底座与安全边界。