DeepSeek内核工程师自述:被自己训练的AI取代的一年
DeepSeek内核工程师自述:AI一年内从查文档助手进化为内核大师,开发者被迫从工匠转型为"智能体管理者"。
一位亲手编写DeepSeek V4.1 Flash注意力内核的工程师撰文坦言,AI在GPU内核编写领域已以肉眼可见的速度逼近并可能超越他本人。文章记录了AI在一年内从文档查询工具进化为能独立完成核心开发的"内核大师"的过程,并以模型价格在一年半内暴跌千倍佐证这一加速度。作者深陷自我淘汰的悖论——内核写得越好,模型进步越快,自己被取代越早——却仍选择全力投入,一因热爱,二因无论如何竞争者都不会停步。文章最终指向一个更宏观的命题:AI普惠与垄断之间的路径选择,以及每位知识工作者如何在"工匠心态"被效率逻辑碾碎的时代,重新寻找与工作的情感联结。
一篇来自DeepSeek内核工程师的博客文章最近引发了广泛讨论。这位工程师亲手编写了DeepSeek V4.1 Flash的核心注意力内核(attention kernel),却在文章中坦言:AI在编写GPU内核这件事上,正以肉眼可见的速度逼近甚至超越他本人。这不是一篇技术炫耀文,而是一位站在AI浪潮最前沿的开发者,对自身职业命运的冷静剖白。
一年之内:从查文档的助手到内核大师
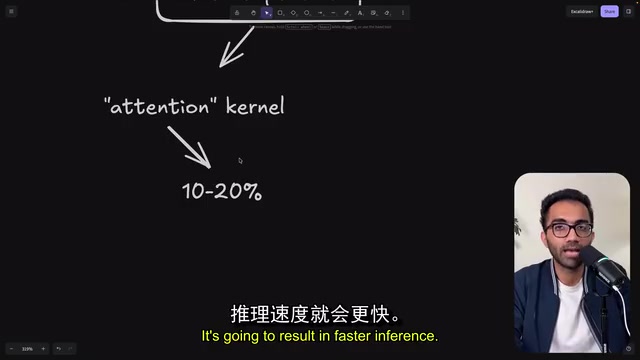
作者用自己所处的领域——GPU内核设计与优化——作为观察AI进化的第一现场。这是运行大模型时最昂贵、最需要极致优化的环节之一。注意力内核哪怕只快10%到20%,都会直接转化为更快的推理、更快的训练和更低的成本,价值极高。
他描述的变化令人震撼:仅仅一年时间,AI就从"只能帮我查文档、读代码、找bug的小助手",进化成了"能够独立完成大量核心开发工作的内核大师"。他预判在未来半年到一年内,AI将具备独立设计内核调度、评估不同调度方案性能、实现并优化的能力——而这些恰恰是这份工作中最难的部分。
这种感受并非内核工程师独有。无论是前端、后端、移动端开发者,还是UI/UX设计师,几乎每个热门工种都被AI显著改变。差别只在于AI替你完成了20%、30%还是50%的工作。
GPU注意力内核(attention kernel)是大型语言模型运行时的核心计算单元,负责执行Transformer架构中的自注意力机制——即让模型在处理每个词时,能够"关注"输入序列中其他相关词的过程。这一计算极其密集,在训练和推理阶段往往占据总算力的30%至60%。内核工程师的工作是将这一抽象算法转化为能在GPU硬件上高效运行的底层代码,需要深度理解CUDA编程模型、GPU内存层次结构(寄存器、共享内存、显存)、线程块调度等专业知识。由于硬件并行度极高且内存带宽有限,内核优化需要在计算与访存之间精细权衡,稍有不当便会大幅降低GPU利用率。正因其高度专业化和稀缺性,内核工程师长期以来被视为AI基础设施领域的顶尖技术岗位,薪资与影响力均处于行业金字塔尖端。
价格的坍缩:一年半,1000倍
视频作者补充了一组极具冲击力的数据来佐证AI的加速度。OpenAI的O1 Pro模型在一年半前发布时,定价是每百万token输入150美元、输出600美元,上下文长度20万。而如今OpenAI最先进的GPT-6 Astra定价降至输入10美元、输出50美元,上下文长度达到百万级——一年半内旗舰模型成本降了约10倍。
若把对比对象换成DeepSeek V4.1 Flash这类高性价比模型,差距更夸张:其输入价格仅15美分,与O1 Pro相比是接近1000倍的价差。这种在一年半内实现千倍降价的现象,在任何行业都堪称匪夷所思。
理解这一价格坍缩需要了解大模型定价中"token"的概念。Token是模型处理文本的基本单位,大致对应英文中的半个单词或中文的一到两个字符,"每百万token"是API定价的通用计量单位。O1 Pro发布时每百万输入token收费150美元,意味着处理约75万个英文单词(相当于一部中等长篇小说)的成本高达150美元。而DeepSeek V4.1 Flash将同等输入成本压至约0.15美元,降幅达千倍。这一趋势部分源于开源模型对闭源厂商的定价倒逼,部分源于推理效率(如KV缓存、量化、蒸馏等技术)的快速迭代。值得注意的是,价格坍缩并不代表模型能力下降——恰恰相反,低价格往往伴随着更长的上下文窗口和更强的推理能力,这使得"性能/价格"曲线的改善幅度远超单纯的价格降幅数字所呈现的程度。
"我亲手加速了自己的淘汰"
文章最打动人的,是作者对这份工作近乎矛盾的情感。他清楚地知道一个残酷逻辑:他把内核写得越好,新模型的训练和推理速度就越快,模型能力进步就越快,他被取代的时间就越早。因为他直接工作在模型本身,这个自我淘汰的循环格外短暂。
那他为什么还要拼尽全力去优化?他给出了两个理由。其一,写内核对他而言"就像玩电子游戏",发明新技术、看到内核性能超越官方版本时的成就感,不亚于速通玩家打破自己的纪录。其二更为现实:即便他偷懒甚至故意拖慢训练,其他公司的模型照样会进步,最终仍会淘汰他。
视频作者对此深有共鸣。他回忆起AI出现之前,程序员戴上耳机、放着音乐,连续六到十小时沉浸在代码库中的"心流"状态——不需要打开Stack Overflow或Google,一切都在脑中运转,思考数据库schema、应用结构、数据流向和性能影响。那种工作结束时不仅不疲惫、反而神清气爽的体验,如今正被"一切以产出为导向"的现实所碾碎。
从工匠到"机甲驾驶员"
作者对自己未来的判断相当清醒:他大概率不会失业,但必须"转行"。行业需求已经从"能写高性能内核的人",转变为"能用AI更快产出高性能内核的人"。这意味着他要放弃深耕多年、满怀热情的内核设计领域,转而成为"AI智能体的机甲驾驶员"。
他用了一个精妙的比喻:一位精通编织的匠人,享受着临窗煮茶、望着青山静静织一下午毛衣的乐趣。直到有人发明了自动编织机,只需提供毛线和图样就能织出质量不逊、速度更快的毛衣。他知道同行会借助机器轻松达到自己曾经的水平,于是不得不也用上机器——但那份"听雨编织"的兴致,终究被机器的轰鸣声碾得粉碎。
这正是过去几个月发生在几乎所有开发者身上的事。从Opus到GPT-5.6、Astra、Fable等模型的相继发布,把整个软件栈的从业者——从前端、后端、全栈到移动端——统统推向了"用AI更快产出"的新赛道。视频作者坦言,正因为意识到全世界都在"代码大爆发",他自己也在过去几个月里主动退出了大量手写代码的工作,因为"制造更多的AI垃圾产出不是对时间的正确使用"。
关于AI未来的分歧
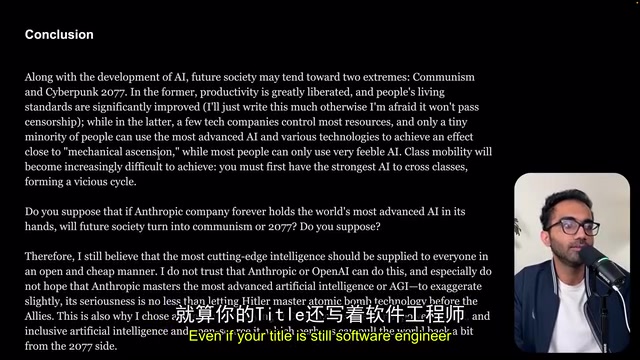
博客结尾,作者抛出了一个尖锐的政治经济学判断:AI发展可能导向两个极端——生产力被极大解放、生活水平显著提升的"理想社会",或者少数科技公司垄断最先进AI、阶层流动愈发困难的"赛博朋克2077"式反乌托邦。他明确表示不信任Anthropic或OpenAI能公平地把最前沿智能开放给所有人,甚至用了极端类比:让单一公司独占AGI,其严重性不亚于"让希特勒在盟军之前掌握原子弹技术"。他强调这正是自己选择留在DeepSeek的原因——研究强大、快速、普惠且开源的AI,"或许能把世界从2077那一侧拉回来一点"。
视频作者对此表达了不同看法。他认为在美国这类竞争充分、信息流动自由的环境下(尤其是加州不承认竞业禁止协议),人才和知识会随员工跳槽而自由流动,不太可能出现单一公司永久垄断的局面。但他也承认了一个有趣的悖论:正因为有像这位工程师这样甘愿留在开源实验室、努力"反驳自己预言"的人存在,他关于"未来不会走向垄断"的乐观判断才有可能成真。两种立场其实互相依存。
文中提到的"AGI"(通用人工智能,Artificial General Intelligence)是AI领域一个尚无统一定义的概念,通常指在几乎所有智力任务上达到或超越人类水平的AI系统,区别于当前只能在特定领域表现出色的"狭义AI"。围绕AGI的治理争议已是AI政策领域的核心议题:以Anthropic、OpenAI为代表的一方认为,安全对齐研究需要在封闭环境中谨慎推进,过早开源可能导致危险能力扩散;以DeepSeek、Meta等为代表的另一方则认为,开源有助于分散权力、加速安全研究、降低技术垄断风险。加州不承认竞业禁止协议(Non-compete agreements)这一法律细节也值得关注:这意味着硅谷员工可以在不受法律约束的情况下自由跳槽并带走技术经验,客观上形成了一种知识扩散机制,这正是视频作者认为单一公司难以永久垄断AI的重要制度性依据。
写在最后
这篇自述之所以引发共鸣,在于它超越了技术本身,触及了每一个知识工作者正在或即将面对的现实:AI改变的不只是效率,更是我们与工作之间的情感联结。当"热爱的事"变成"AI做得更好的事",当程序员从沉浸的工匠变成产出导向的"智能体管理者",真正需要修炼的能力或许是——与变化共处,并相信自己有能力适应任何到来的东西。正如视频作者所言,你不必等到失业才明白这个道理,但这场变革确实正朝所有人走来。
相关推荐
厦门大学AI编程课落地实践:从教材到教学的全解析
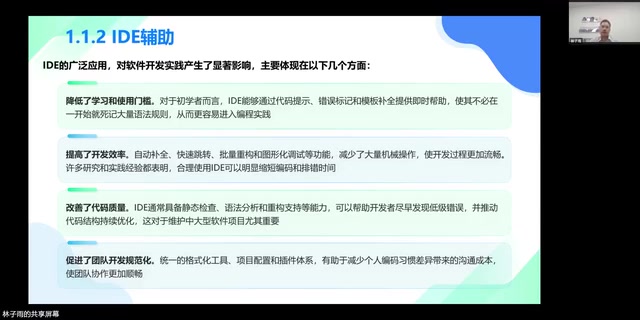
厦门大学林子雨副教授分享《AI编程与智能体开发》课程建设实践,涵盖AI编程三段演进、Claude Code生产级拐点、三种编程方法论及教材设计,详解免费可复现的高校教学落地方案。
DeepSeek研究员自白:亲手训练的AI即将取代自己
DeepSeek V4.1核心算子编写者刘胜宇发文自白:亲手训练的AI最快半年到一年将取代自己写算子的能力。他为何仍坚持优化模型?又为何担忧AI把世界推向赛博朋克式极端并选择开源?
n8n 自动化实战:AI 工作流如何为中小企业降本增效
本文基于一线从业者的实战分享,讲解如何用 n8n 与 AI 工具构建工作流自动化,涵盖多平台消息聚合、AI 自动回复、批量数据录入与智能校验,帮助中小企业降本增效。