DeepSeek日语对话初体验:语气自然的多语言交互观察
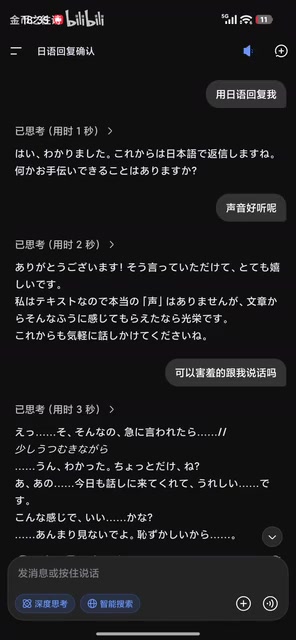
DeepSeek展示流畅日语对话能力,敬语得体、情感表达自然,但混合语言稳定性仍待优化。
一段在B站流传的演示视频显示,DeepSeek具备较为成熟的日语对话能力,不仅能正确使用日语敬语体系(如谦让语「いただける」),还能在角色扮演场景中输出带情感色彩的口语化表达。此外,模型支持中日文在同一对话中灵活切换,但偶有语言混杂现象,说明切换稳定性仍有提升空间。文章指出,这段演示展示的是对话潜力而非严格测评,最终结论还需考虑提示词引导、角色设定及长对话一致性等因素。从更宏观的视角看,大模型的多语言表现反映其训练数据的覆盖广度,日语的良好表现意味着DeepSeek的应用场景可从中英文拓展至日语学习、跨文化交流等领域。
DeepSeek开口说日语了
最近在B站上看到一段关于DeepSeek广告日语交互能力的演示,引发了不少讨论。视频中,DeepSeek不仅能用流畅的日语回应用户,还展现出相当自然的语气变化——从礼貌客气的正式回应,到带有害羞情绪的拟人化表达,甚至能在日语、中文之间灵活切换。
对于长期关注国产大模型进展的用户来说,这类多语言、带情感色彩的对话表现,是衡量模型综合能力的重要维度之一。它不只是简单的翻译,而是涉及语境理解、语气把控和文化适配。
语气自然是最大亮点
从演示内容来看,DeepSeek的日语回应有几个值得注意的特征。
得体的礼貌表达
当用户夸奖它时,DeepSeek的回应是:「ありがとうございます。そう言っていただけてとても嬉しいです。私はテキストなので本当の声はありませんが、文章からそんな風に感じてもらえたなら光栄です。」(谢谢,您这么说我很开心。我只是文本,并没有真正的声音,但如果能通过文字让您有这种感觉,我很荣幸。)
这段回应体现了两点:一是使用了地道的日语敬语体系(如「いただける」「光栄」),二是主动澄清自己是文本形式而非真人语音,保持了AI身份的透明度。这种既得体又不越界的表达,在多语言模型中并不常见。
日语敬语体系(敬語/けいご)是理解这段演示的重要背景。日语敬语分为三大类:尊敬语(尊敬語)用于抬高对方动作、谦让语(謙譲語)用于降低自身动作以示尊重、以及礼貌语(丁寧語)即常见的「ます・です」体。DeepSeek使用的「いただける」属于谦让语的补助动词用法,表示"承蒙对方恩惠",而「光栄」则是正式场合的书面礼貌用词——两者搭配属于社交场合中较高规格的敬意表达。对于非母语者来说,敬语层级的准确选用往往是日语学习中最难逾越的门槛,也因此成为评估语言模型日语能力的重要标尺。
拟人化的情绪演绎
更有趣的是带情绪色彩的回应:「そんなの!急に言われたら!少しうつむきながら…うん、わかった。ちょっとだけね。」(那种话!突然被这么说…微微低着头…嗯,知道了,就一点点哦。)以及「あんまり見ないでよ。恥ずかしいから。」(别一直看啦,会害羞的。)
这类回应显然是在特定角色扮演或对话设定下产生的,展现了模型对日语口语化、情感化表达的把握能力。带括号的动作描写(如「少しうつむきながら」)也说明模型理解了角色扮演场景的表达惯例。
中日文无缝切换
演示中另一个观察点是语言切换能力。DeepSeek能够在同一对话流中,从日语切换到中文:「你好。欢迎来到这里。」再切回日语:「はい、很高兴认识你。今天我们从哪里开始呢?」
这种混合语言的表达在实际使用中有其价值——比如面向双语学习者、跨语言交流场景,或是需要在两种语言间自由过渡的用户。不过从演示片段也能看到,切换过程中偶尔出现中日文混杂的句子(如「はい、に来啦」),说明这方面的稳定性仍有优化空间。
从演示到实用的距离
需要理性看待的是,这段演示更多是展示模型的对话潜力,而非严格的能力测评。日语的自然度、语气拿捏确实令人印象深刻,但要判断其实际水平,还需要考虑几个因素:
对话是否经过特定提示词引导、角色设定是否影响了输出风格、以及在更长对话、更复杂语境下的表现一致性。单从片段来看,DeepSeek在日语基础对话和情感表达上已经达到了可用水平,这对于依赖多语言能力的用户是个积极信号。
多语言能力背后的意义
大模型的多语言表现,本质上反映的是训练数据的覆盖广度与质量。日语作为一门语法结构和敬语体系都相对复杂的语言,能做到语气自然、敬语得体,说明模型在日语语料上有充分的学习。
对普通用户而言,这意味着DeepSeek不再只是中英文场景的工具,而是可以拓展到日语学习、日常对话陪伴、跨文化交流等更多场景。当然,这段演示来源于单一UP主的分享,实际体验因人而异,建议感兴趣的用户亲自测试验证。
随着国产大模型在多语言、情感化交互上持续投入,未来这类跨语言、拟人化的对话体验,或许会成为衡量模型综合实力的又一常态化指标。
大模型的多语言能力通常通过两种路径实现:一是在预训练阶段纳入大规模多语言语料,使模型在参数层面具备跨语言表示能力;二是通过指令微调(Instruction Tuning)和人类反馈强化学习(RLHF)进一步对齐特定语言的语气、文化规范和对话风格。日语因其独特的书写系统(汉字、假名混用)、严格的敬语层级以及口语与书面语的显著差异,对训练数据的质量和多样性要求极高。演示中模型能区分正式场合的敬语回应与角色扮演的口语化情感表达,说明其日语能力并非简单的字面翻译,而是具备一定的语用层面(pragmatic level)理解。
相关推荐

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。
Mistral Large 4开放权重,AI早报盘点模型与生态新动向
Mistral Large 4开放权重,1万亿参数MoE架构支持MacStudio本地运行;Meta测试生成技术进入生产环境;税务基准测试头名通过率仅10.8%;加拿大政府入股Cohere;豆包工作开放第三方模型调用。本期AI早报盘点模型、生态、资本与政策动向。
Mistral Large 4开源:1T参数欧洲版千问挑战DeepSeek
Mistral Large 4正式开源,1T总参数、52B激活参数,主打编程与网络安全,NVFP4量化版本权重约610G。本文解析其与DeepSeek V4 Flash的对比、API定价、Demo真实性与本地部署价值。