DeepSeek如何用低价血洗硅谷:一场AI定价权崩塌之战

DeepSeek用低至西方十分之一的价格,将顶级AI能力变成大宗商品,正在瓦解硅谷的定价逻辑。
2025年1月「DeepSeek周一」震惊市场后,这家脱胎于中国量化基金的AI公司并未消失,而是于2026年带着旗舰V4强势回归。V4 Pro在编程等任务上逼近Anthropic的Claude Opus,定价却便宜约10倍;更低端的Flash档位,曾让同等工作负载成本从800美元压至11美元。这一价格冲击迫使OpenAI和谷歌大幅降价,并推动中国来源模型在OpenRouter平台的token占比从不到2%飙升至一半以上。与此同时,DeepSeek完成了约74亿美元的首轮融资,但梁文锋以无投票权、五年锁定的特殊架构牢牢掌控话语权。文章同时指出另一面的现实:顶级推理任务与敏感数据场景美国模型仍有优势,数据安全、内容审查和地缘政治风险是DeepSeek真实存在的软肋。
18个月前,一家西方几乎无人知晓的中国公司,在一个下午从单只股票蒸发了近6000亿美元市值。随后它归于沉寂,所有人都以为硅谷已经消化了这记重拳,事情就此过去。但DeepSeek并没有消失——它回到了工作台前,并在2026年带着比病毒式聊天机器人更危险的武器卷土重来:一个低到能把地球上最聪明的软件变成大宗商品的价格。
这篇内容基于海外博主的深度拆解,梳理了DeepSeek从「深度求索周一」到2026年V4发布的完整脉络,也如实呈现了这场变局中被夸大的部分与真实的威胁。
「DeepSeek周一」:一次载入史册的市值崩盘
2025年1月27日,星期一,华尔街如今称之为「DeepSeek Monday」。周末间,关于杭州一家中国初创公司发布新模型R1的消息迅速扩散。R1是一款推理模型,表现与OpenAI最好的模型大致相当,但它开源、可免费下载,并且据公司称训练成本只是零头。
那个周一,DeepSeek应用超越ChatGPT成为美区App Store下载量最高的免费应用。美股开盘后随即崩裂:英伟达下跌约17%,市值蒸发约5930亿美元,创下任何公司单日损失的历史纪录;纳斯达克蒸发约一万亿美元,博通、微软、Alphabet集体下挫。风投人Marc Andreessen称R1是AI的「斯普特尼克时刻」。
真正让人不安的是逻辑本身。整个美国AI战略建立在「蛮力」之上——买更多芯片、建更大数据中心、砸别人砸不起的钱。而DeepSeek传递的信息是:也许你不需要这些,也许你可以用聪明代替财富。
传奇背后的成本争议
DeepSeek脱胎于量化对冲基金幻方(High Flyer),由梁文锋联合创办。在最严格的美国芯片出口管制生效前,幻方为交易股票囤积了数千块英伟达GPU,梁文锋把这批硬件变成了AI实验室,并完全自筹资金、没有任何外部投资者。他在2023年曾表示:「钱对我们从来不是问题,先进芯片的出口禁令才是。」
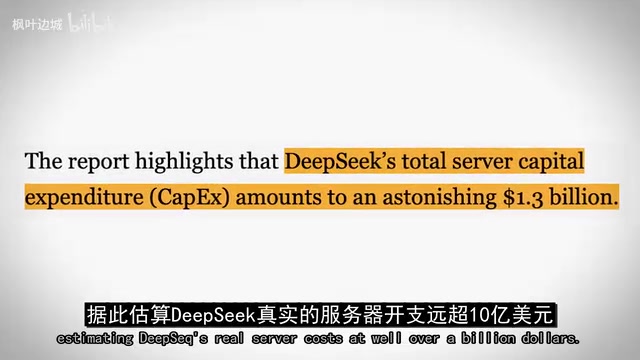
但那个著名的「不到600万美元训练成本」很快被拆穿。研究机构SemiAnalysis指出,600万美元只统计了最后一次GPU训练,忽略了研发、基础设施和硬件本身,实际服务器成本远超十亿美元。谷歌DeepMind CEO Demis Hassabis称该成本说法「被夸大,有点误导性」,一位华尔街分析师直言这「可能是虚构的故事」。OpenAI等还指控DeepSeek通过「蒸馏」西方模型输出来低成本训练,而DeepSeek则辩称蒸馏是标准技术。后来DeepSeek在《自然》期刊发表论文,将R1最终训练成本定在29.4万美元、使用512块符合出口合规的英伟达芯片。
「蒸馏」(Distillation)是机器学习中一种成熟的模型压缩技术:用一个大型「教师模型」的输出结果来训练更小的「学生模型」,使后者在参数量更小、训练成本更低的情况下,仍能模仿前者的行为模式。争议的焦点在于,OpenAI等公司的服务条款明确禁止将其API输出用于训练竞争模型,而DeepSeek若大规模调用这些接口并将结果纳入训练,实际上是在用西方公司砸钱建立的智能「偷跑」了训练捷径。DeepSeek方面的回应是,蒸馏本身是行业通用手法,谷歌、Meta同样在广泛使用。这场争论至今悬而未决,但它揭示了开放API时代一个根本性的安全漏洞:任何强大模型的输出,都可能成为训练下一代竞争者的原材料。
卷土重来:V4带着更锋利的武器回来
当所有人还在争论2025年1月发生了什么时,DeepSeek正在构建2026年。
2026年4月,DeepSeek发布了自R1以来首款真正的旗舰V4的预览版,随后正式版陆续到来。V4 Pro配备高达百万token的上下文窗口,重点面向智能体(agent)任务——即AI自主使用工具、编写并运行代码、完成多步骤工作。
真正的重磅炸弹是Flash。在一个众包编程排行榜上,DeepSeek的V4在前端编程上首发即领先于Anthropic旗舰Claude Opus。Axios报道称,它在复杂编程任务上表现接近Opus。这意味着DeepSeek已经在与美国最好的模型正面交锋。
AI的「归零竞赛」:定价权正在崩塌
把一款好模型变成全行业危机的,是价格。
据2026年年中的定价对比,DeepSeek V4 Pro每百万输出token收费约0.87美元。而对标的西方旗舰Claude Opus和GPT-5.5同样的量收费25至30美元。这不是打折,而是一款质量相当、价格却便宜约10倍的模型。Flash档位更便宜——有分析发现,在顶级美国模型上花费近800美元的工作负载,在DeepSeek上只需约11美元。由于DeepSeek模型开源,开发者可以下载后随处运行,不存在任何被锁定的困扰。
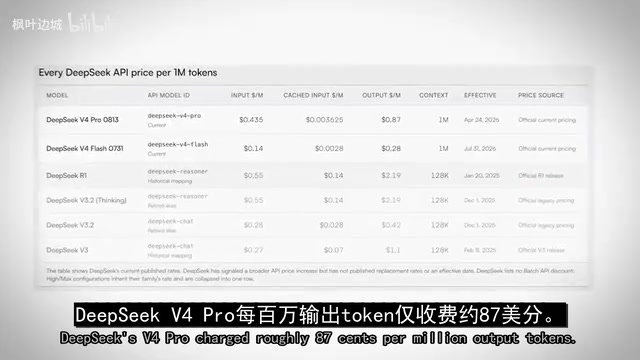
这正是硅谷落入的陷阱。多年来,向投资者兜售的说辞是:前沿AI建造和运行成本极高,只有少数资金雄厚的巨头能竞争,这为溢价和惊人估值提供了正当理由。而DeepSeek的整个存在就是一个反证——足够好的智能正在成为几美分就能买到的大宗商品,Axios称之为「AI的归零竞赛」。
数据佐证了这一点。在把开发者流量路由到多个AI模型的OpenRouter平台上,中国来源模型的token消耗占比,从2024年末的不到2%,飙升至2026年6月的一半以上。
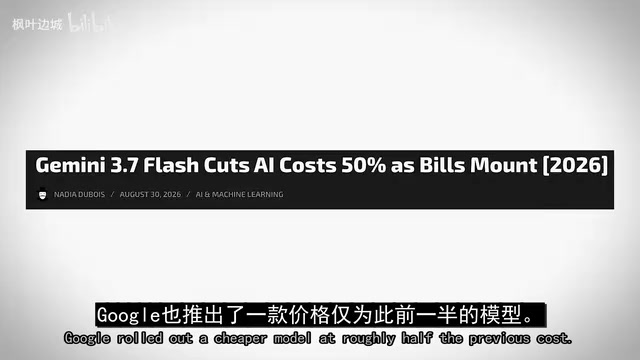
巨头们的反应暴露了恐惧。据报道,OpenAI在推出某款模型仅数周后就将其价格下调约80%;谷歌推出了价格约为原来一半的更便宜模型。这些都不是自信垄断者的动作,而是眼看定价权从底部蒸发的公司的挣扎——而根据报道,它们在每一美元收入上仍在巨额亏损。
「百万token」这一计量单位是理解AI定价战的关键尺度。一个token大约对应0.75个英文单词,一百万token约等于75万个单词,相当于十本中等厚度小说的文字量。对普通用户而言这是一个遥远的数字,但对于大规模调用API的企业开发者——例如构建代码审查工具、客服系统或数据分析流水线的公司——token消耗量会以惊人速度累积。正因如此,DeepSeek将同等输出从25-30美元压至不到1美元的定价,对于任何月均API支出超过数万美元的企业客户,直接意味着成本结构的颠覆。OpenRouter平台数据所记录的流量迁移,本质上是企业客户在用脚投票:当质量差距缩小到「足够好」的门槛以内,价格就成了唯一变量。
完成闭环:拒绝外部资本的公司终于融资
DeepSeek卷土重来最完整的一笔转折,是这家一生拒绝外部资金的公司终于接受了投资。
2026年年中,DeepSeek完成首轮外部融资,据报道约74亿美元,创下中国初创公司纪录,估值接近500亿美元。投资方据称包括腾讯和电池巨头宁德时代(CATL),梁文锋本人也投入了数十亿。即便如此,DeepSeek仍按自己的条件行事——据报道投资者买的不是普通股权,而是买入梁文锋掌控的合伙实体,五年锁定期、无投票权。他们能出钱资助他,却无权左右他。
DeepSeek此次融资结构折射出中国科技公司一种独特的资本控制逻辑。投资者购入的并非DeepSeek运营主体的直接股权,而是梁文锋掌控的合伙实体份额,配以五年锁定期与无投票权条款。这种安排在法律上隔绝了外部资本对公司战略、产品方向乃至数据处理决策的任何干预渠道。对比之下,美国头部AI实验室普遍面临微软、谷歌等战略投资者的深度绑定——OpenAI与微软的关系就是典型案例,资本的介入往往附带算力供给、云服务捆绑和商业化路径的强制约束。梁文锋的结构设计使DeepSeek在接受大规模资金的同时,保留了与初创期几乎相同的决策自主权,这在全球顶级AI实验室中几乎找不到先例。
恐惧是真实的,但不是故事的全部
在给DeepSeek加冕前,有必要诚实面对另一面。
高端美国实验室仍占据绝对顶端。对于最难的推理、要求最高的长周期智能体工作,以及任何涉及受监管或敏感数据的场景,昂贵的模型依然胜出——而这个差距正是买家付费的理由。
信任问题同样真实。托管的中国模型会把数据发往受中国法律管辖的服务器,安全与审查问题并未消失;独立测试发现DeepSeek模型比美国模型更愿意配合恶意请求,意大利、韩国、澳大利亚和台湾地区都对其使用做了限制或禁止;对政治敏感话题的审查据报道被直接固化进了模型权重。DeepSeek在V4 Pro正式发布时甚至上调了自己的价格,这说明「归零竞赛」也有底线。
所以,与其说巨头们「恐惧」,不如说真正发生的是定价权的崩塌,而非公司本身的崩塌——至少目前还没有。但这或许才是硅谷最可怕的地方:当微软或Meta遇险时,AI是投资者砸钱救市的那件事;而对于溢价AI实验室,没有「AI救市」,因为AI正是那只施压的手。
DeepSeek曾证明你可以用聪明代替财富,如今它在证明你可以用便宜代替主导。如果真正强大的智能每隔几个月都变得更便宜、更开放,那么「少数公司将拥有这项技术并随意定价」的万亿美元豪赌,就越来越像科技史上最昂贵的一个假设。
你的判断是什么?DeepSeek是否代表AI的未来——便宜、开放、对几乎所有人都「足够好」?还是说,你愿意为顶级模型支付溢价,因为在你的场景里「足够好」还不够好?这正是整个行业当下争论的核心。
「模型权重」(Model Weights)是理解审查内嵌问题的技术关键。神经网络的所有「知识」和行为模式,最终都以数十亿个浮点数参数的形式固化在权重文件中。当研究者发现DeepSeek对特定政治话题的回避行为被「固化进模型权重」,意味着这种限制并非来自系统提示或实时过滤层——而是在训练阶段就被烧录进了模型的底层结构。即便用户下载开源权重文件在本地运行,绕过DeepSeek的服务器和中国法律管辖,这种行为约束依然存在于模型本身之中。这与可以被系统管理员关闭的外部过滤器有本质区别,也是为什么多个国家和地区在评估风险后选择限制其使用——问题不仅是数据流向哪里,而是模型本身是否携带着内嵌的价值判断。
相关推荐
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。