DeepSeek识图模式实测:截图转代码还原度高达80%

识图模式全面开放:真正价值不在人脸识别
DeepSeek广告 近期将此前仅对少部分用户开放的「识图模式」正式面向所有用户开放。不少博主第一时间进行了测评,但很多人将测试重点放在了人物识别上——结果自然不尽如人意。B站UP主小游通过一系列实际案例告诉我们:DeepSeek识图模式的真正价值不在于识别人脸,而在于根据截图生成界面原型代码。
人物识别并非它的主场
很多博主的测评思路是:给 DeepSeek 一张人物照片,看它能否正确识别。结果发现,即便是其他模型能轻松识别的公众人物(比如梁文峰本人),DeepSeek 的识图模式也会给出错误答案。
这其实并不意外。当前主流多模态大模型(如 GPT-4o、Claude、Gemini 等)普遍对人脸识别功能进行了主动限制,这涉及隐私保护、肖像权和潜在的滥用风险等多重考量。这背后有深刻的行业教训:2023年 Clearview AI 因未经同意抓取数十亿张人脸照片构建识别数据库,被多国监管机构处以巨额罚款,成为 AI 人脸识别滥用的标志性案件。此后,OpenAI 在 GPT-4V 发布时明确表示模型经过专门训练以拒绝识别真实人物身份,Google 的 Gemini 同样内置了人脸识别的安全护栏。欧盟《人工智能法案》(AI Act)已明确将实时远程生物识别列为高风险应用,中国的《个人信息保护法》也对人脸信息的处理设定了严格的合规要求。因此,DeepSeek 在识图模式中弱化人物识别能力,既是合规层面的必要措施,也是将有限的模型能力集中在更具生产力价值的场景上的战略选择。
DeepSeek 的识图功能在设计定位上并非面向人像识别场景,它更侧重于理解界面截图的结构和样式,进而生成对应的前端代码。明确了这一点,我们才能正确评估它的能力边界。
界面复刻实测:从简单到复杂
Ant Design 官网复刻
第一个测试案例是将 Ant Design 官网截图丢给 DeepSeek,要求它复刻图片中的效果。
Ant Design(简称 antd)是由蚂蚁集团开源的企业级 UI 设计语言和 React 组件库,是中国乃至全球使用最广泛的前端组件库之一,GitHub 星标超过 9 万。它不仅是一个组件库,更代表了一套完整的企业级设计体系——基于「自然」「确定性」「意义感」「生长性」四大设计价值观,提供了从设计原则、视觉规范到交互模式的全套解决方案。其背后的 Design Token(设计令牌)系统允许通过修改一组变量来全局调整主题风格,这种系统化的设计语言使得 AI 模型更容易学习和识别其视觉特征——因为组件之间遵循一致的间距、色彩和排版规则。选择它作为测试对象具有代表性意义:其页面结构规范、设计语言统一,且组件样式在前端社区中广为人知,便于评估 AI 生成代码的准确性。
结果令人惊喜:DeepSeek 准确识别出这是 Ant Design 官网,并生成了对应的静态页面代码。按钮样式、整体风格都与原图高度接近,左上角的导航区域虽然缺少 icon 图标,但整体布局还原度相当高。DeepSeek 能够识别出这是 Ant Design 官网,说明模型在训练过程中已经学习了大量主流前端框架和设计系统的视觉特征。
百度首页与B站首页
接下来是两个国民级产品的首页复刻。百度首页的还原效果不错,DeepSeek 甚至用 emoji 表情来替代部分图标元素,虽然不够精确,但思路颇为巧妙。
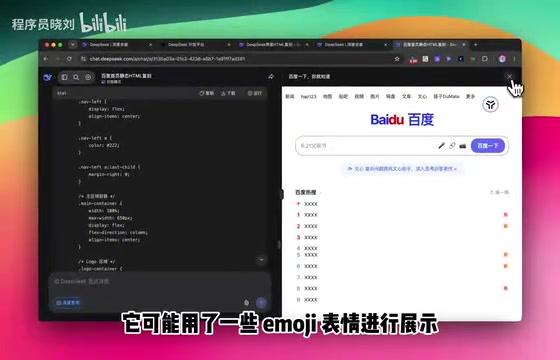
B站首页的复刻同样令人满意——虽然生成的页面无法实现点击交互,但静态布局的还原度已经相当可观。这说明 DeepSeek 的识图模式能够准确提取页面中的布局结构、色彩风格和元素层级关系。
iPhone 官网:挑战高设计感页面
苹果官网以其极简而精致的设计著称,这对 AI 截图转代码能力是一个更高的挑战。
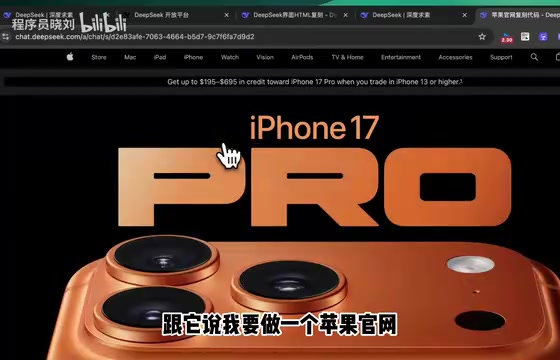
测试结果显示,DeepSeek 不仅识别出了「iPhone 17 Pro」的产品标题,还尝试用 SVG 绘制产品轮廓,用 div 布局还原页面结构。SVG(Scalable Vector Graphics,可缩放矢量图形)是一种基于 XML 的矢量图像格式,可以直接嵌入 HTML 代码中。与 PNG、JPEG 等位图格式不同,SVG 使用数学公式描述图形,因此可以无损缩放且文件体积极小。更重要的是,SVG 代码本质上是文本(XML 格式),这意味着大语言模型可以像生成 HTML/CSS 一样直接生成 SVG 代码,无需调用图像生成模型。一个简单的 SVG 圆形只需要一行代码:<circle cx='50' cy='50' r='40'/>。这种文本可描述的特性使 SVG 成为 AI 在无法获取原始图片资源时的最佳替代方案——它比使用空白占位符更有信息量,因为 SVG 能保留物体的基本形状和比例关系。不过,目前大多数模型生成的 SVG 仍停留在简笔画水平,距离真实产品渲染图还有很大差距。
虽然无法完美再现苹果官网那种像素级的视觉效果(毕竟原图中大量依赖高质量产品摄影),但从前端开发的角度来看,生成的代码框架已经具备了相当的参考价值。
DeepSeek 自家界面复刻
最有趣的测试或许是让 DeepSeek 复刻自己的界面。UP主截取了 DeepSeek 带有三个标签切换的界面,要求它进行还原。
结果同样令人满意,标签切换的布局、整体配色和元素排列都得到了较好的还原。这个「自我复刻」的测试也从侧面证明了识图模式在理解 UI 组件方面的通用能力。
核心价值:快速生成界面原型
通过以上多个案例,我们可以总结出 DeepSeek 识图模式的三大核心应用场景:
截图转代码(Screenshot-to-Code)
这是目前最实用的场景。Screenshot-to-Code 是近两年 AI 前端开发领域最热门的方向之一,其核心原理是利用多模态大模型(Vision-Language Model)同时理解图像的视觉信息和代码的语义结构,将 UI 截图中的布局、颜色、字体、间距等视觉元素映射为对应的 HTML/CSS 代码。
这一方向并非凭空出现,而是经历了多年的技术积累。早在 2017 年,丹麦开发者 Tony Beltramelli 就发表了论文 pix2code,使用 CNN+LSTM 架构将 GUI 截图转换为代码,但当时的效果非常有限——模型只能处理简单的移动端界面,且生成的是领域特定语言(DSL)而非真正的前端代码。此后几年间,虽然有 Sketch2Code(微软)、Teleportation(Teleporthq)等项目持续探索,但受限于计算机视觉模型对复杂 UI 布局理解能力的不足,实用性始终有限。真正的突破来自 2023 年多模态大模型的成熟:GPT-4V 的发布让模型首次具备了同时理解复杂 UI 布局和生成结构化代码的能力。开源项目 screenshot-to-code 在 GitHub 上迅速获得超过 6 万星标,验证了市场需求的真实性。目前该领域的技术路线主要分为两派:一是直接利用通用多模态模型(如 DeepSeek 的方案),优势在于模型具备广泛的代码知识和设计理解能力;二是训练专用的 UI 理解模型(如微软的 Design2Code 基准测试所推动的方向),优势在于可以针对 UI 元素检测和布局分析进行专项优化。
无论是竞品分析、设计参考还是快速原型开发,只需要一张截图就能获得一个 80% 还原度的前端代码框架,大幅缩短从设计到开发的转化时间。
样式风格提取
DeepSeek 能够分析截图中的配色方案、字体层级、间距比例等设计要素,并在生成的代码中加以体现。这对于需要快速理解和复用某种设计风格的开发者来说非常有价值。在实际工作中,设计师和开发者经常需要参考竞品或优秀案例的视觉风格,传统做法是手动使用取色器逐一提取颜色值、用标尺测量间距、通过浏览器开发者工具检查字体属性——这个过程繁琐且容易遗漏细节。DeepSeek 的识图模式可以一次性将这些视觉属性编码到 CSS 中,相当于自动完成了一次「设计审计」(Design Audit),将原本需要数小时的手工分析压缩到几秒钟。
低门槛的UI原型搭建
对于不熟悉前端开发的产品经理或设计师,只需截取一张参考界面的图片,就能获得一个可运行的 HTML 原型,用于内部沟通和方案验证。
传统的前端开发工作流通常是:设计师在 Figma/Sketch 中完成设计稿→开发者手动将设计稿翻译为 HTML/CSS 代码→反复对照设计稿进行像素级调整。这个「设计到代码」(Design-to-Code)的过程往往占据前端开发 30%-50% 的工作量,且容易出现设计还原度不足的问题。之所以如此耗时,根本原因在于设计工具和代码之间存在语义鸿沟:Figma 中的一个「自动布局」(Auto Layout)在 CSS 中可能对应 Flexbox 或 Grid 的多种实现方式,开发者需要根据具体场景判断哪种方案更合适;设计稿中的一个阴影效果需要开发者手动测量模糊半径、偏移量和颜色值,而 Figma 的阴影参数与 CSS 的 box-shadow 属性并非一一对应。即使 Figma 提供了 Dev Mode(开发者模式)来导出 CSS 属性,导出的代码往往是绝对定位的、不具备响应式能力的片段,开发者仍需大量重构才能用于生产环境。据 2024 年 Retool 的开发者调查报告,前端工程师平均花费约 40% 的时间在 UI 还原和样式调整上,这部分工作技术含量不高但极其耗时,是开发效率的主要瓶颈之一。
DeepSeek 识图模式的出现,为这一流程提供了一条新的捷径:即使没有 Figma 源文件,仅凭一张截图就能生成 80% 还原度的代码框架,开发者只需在此基础上进行微调和交互补充。这与 Vercel 推出的 v0.dev、Bolt.new 等 AI 前端生成工具形成了同一赛道的竞争格局。其中,v0.dev 于 2023 年底由 Next.js 背后的 Vercel 公司推出,允许用户通过自然语言描述或上传截图生成基于 shadcn/ui 和 Tailwind CSS 的 React 组件,目前已积累数十万开发者用户,其优势在于生成的组件可以直接集成到 Next.js 项目中;Bolt.new 则由 StackBlitz 团队打造,基于 WebContainers 技术支持在浏览器中直接生成、运行和部署全栈应用,用户无需本地安装任何开发环境;此外还有 Galileo AI(专注从文本描述生成高保真设计稿)、Locofy(将 Figma/Adobe XD 设计稿一键转换为 React/Vue/HTML 代码)等垂直工具。但 DeepSeek 的差异化优势在于它作为通用对话模型的一项内置能力,用户无需注册新工具、支付额外费用或切换工作环境——在日常对话中随手上传一张截图即可获得代码输出,使用门槛几乎为零。
局限性与展望
当然,DeepSeek 识图模式目前也存在一些明显的局限:
- 无法处理交互逻辑:生成的是静态页面,点击、动画等交互行为需要手动补充。现代 Web 应用中大量使用 JavaScript 驱动的交互效果——从简单的下拉菜单、模态弹窗到复杂的拖拽排序、无限滚动加载,这些行为逻辑无法仅从静态截图中推断,需要开发者根据产品需求手动编写事件处理和状态管理代码。
- 图片资源无法还原:产品图、背景图等只能用占位符或 SVG 简笔画替代。这是所有截图转代码工具的共同局限——模型能理解图片在布局中的位置和尺寸,但无法从截图中「提取」出原始的高清图片文件。
- 复杂组件的精度有限:对于高度定制化的 UI 组件,还原精度会有所下降。例如带有复杂数据可视化的仪表盘、自定义的富文本编辑器、或深度嵌套的表单组件,这些场景下模型可能无法准确识别组件的层级关系和交互状态。
- 人物与物体识别能力弱:不适合用于通用的图像识别任务
但从「第一版全面开放」的角度来看,这个能力已经展现出了相当的实用性。随着模型的持续迭代,我们有理由期待它在交互还原、组件识别精度等方面的进一步提升。值得关注的是,未来的迭代方向可能包括:支持多张截图输入以理解页面间的导航关系和交互流程;结合设计系统知识自动使用对应的组件库(如识别出 Ant Design 风格后直接生成 antd 组件代码而非原生 HTML);以及与 Figma 等设计工具的深度集成,实现从设计稿到可部署代码的端到端自动化。
总结
DeepSeek 的识图模式并非一个通用的「看图说话」工具,而是一个面向开发者和设计师的截图转代码利器。如果你还在用它测试人脸识别,那确实会感到失望;但如果你把它用在界面原型生成的场景中,80% 的还原度足以让它成为日常工作流中的高效助手。找对了使用场景,DeepSeek 识图功能确实能打。
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。