DeepSeek手机端限额、Gemini 4登顶数学榜与阿里开源编程工具
DeepSeek手机端限额、Gemini 4登顶数学榜、智能体工程与开源编程工具密集更新。
本期 AI 动态聚焦算力成本与服务调整:DeepSeek 手机端启用额度限制,超 72 小时长对话被停用,用户需尽早备份。谷歌 Gemini 4 Carbon 以 85.4% 登顶 Mafurina 数学基准,但单体成本约为开源模型的 15 倍,评测体系本身也面临基准被快速攻破的挑战。Anthropic 提出事件驱动智能体范式,并发现统一协调者比每人独立智能体表现高出 10 到 45 个百分点。阿里 OpenCodeReview 与腾讯 LoopForge 同日开源,推动 AI 编程进入标准化流水线与角色隔离。Meta 证明模型可跳过分词直接读取原始字节,存储成本降低约 80%,为端侧小模型打开空间。此外还有 Perplexity 智能体 ROI 数据、Verso 提升开发者额度及 Grok 灰度推送等动向。
DeepSeek手机端启用限额,长对话用户需尽早备份
继网页端此前调整代码生成与长文本处理逻辑后,DeepSeek广告 手机端也正式启用了额度限制。据 B 站博主晒图证实,大量用户遭遇内容超长和修改次数超限拦截,超过 72 小时的长对话因算力不足被停用并提示导出。官方尚未说明是否会推出包月套餐,常用长对话的用户建议尽早备份记录。
这一变化折射出大模型服务在算力成本与用户体验之间的持续博弈。当免费额度收紧,用户需要重新评估自己的使用习惯,尤其是依赖长上下文进行连续创作或深度分析的场景。
Gemini 4 登顶数学基准,高分背后的算力账单
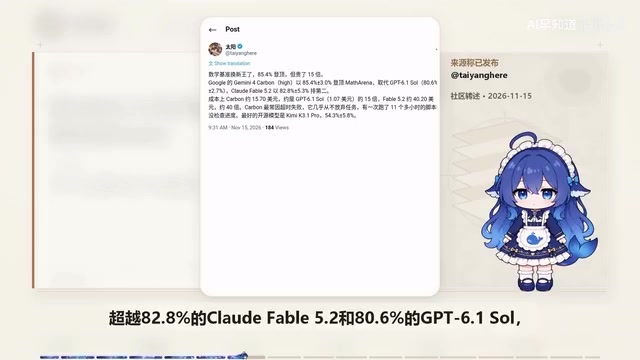
数学权威基准 Mafurina 迎来新榜首:谷歌 Gemini 4 Carbon 高档位以 85.4% 的成绩登顶,超越 Claude 的 82.8% 和 GPT 的 80.6%。开源阵营表现最好的是 Pimi K3.1 Pro 的 54.3%,差距依然明显。
高分代价同样惊人。Carbon 单体成本约 15.70 美元,是后者的 15 倍,高强度推理的算力账单悬殊。
更值得关注的是评测体系本身。沃顿教授伊桑·莫利克推出新指标 SatBench,统计发现基准一年内被攻破的比例逐年飙升。AI 进化速度正在甩开现有题库,行业急需更贴近真实生产力的测试体系。
Mafurina 是数学推理评测领域近年崛起的基准之一,题型覆盖竞赛级代数、数论与几何证明,强调多步推导而非模式匹配,因此常被用来区分模型的真实推理能力与记忆能力。与 GSM8K 等偏基础算术的题库相比,Mafurina 的题目更接近奥赛难度,分数差距往往在几个百分点之间拉锯,这也使得榜首争夺格外敏感。正因其难度高、答案可自动校验,Mafurina 成为厂商发布新模型时最常引用的成绩单之一,但同样面临题库泄露与被针对性训练的风险。
智能体工程:事件驱动与统一协调成共识
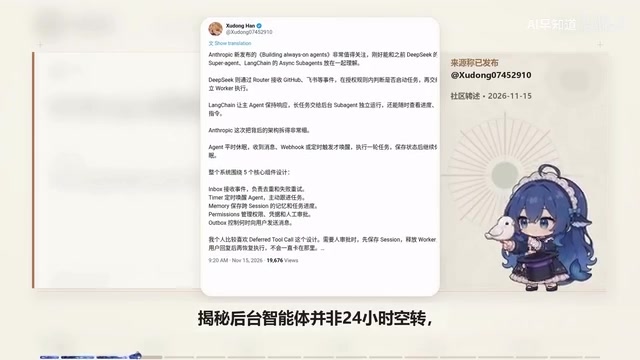
Anthropic 发布构建始终在线的智能体工程指南,揭示后台智能体并非 24 小时空转,而是平时休眠、收到事件或定时再唤醒执行。整套系统拆解为收件箱、定时器、记忆、权限与发件箱五大组件,遇到人工审批会先保存状态、释放执行器。这种事件驱动范式正成为行业标配。
企业铺开智能体也并非人数越多越好。Anthropic 研究显示,在共用预算、日程调度和代码合并等资源争抢场景中,由一个统一协调者服务全队,表现比每人配一个独立智能体高出 10 到 45 个百分点。各自为战容易内耗,共享上下文才是协作关键。
事件驱动架构(Event-Driven Architecture)是软件工程中的经典范式,核心是把系统行为拆成“事件产生—事件分发—事件消费”三段,组件之间不直接调用,而是通过消息队列或收件箱解耦。智能体沿用这一思路后,后台任务不再依赖常驻进程轮询,而是由定时器、外部消息或人工审批触发唤醒,执行完毕即释放计算资源。这样做的好处是并发规模可以弹性扩展、单个任务失败不影响全局,也便于把长耗时任务的状态持久化到存储层,实现断点续跑与审计留痕。
阿里腾讯同日开源编程工具,AI 编程进入流水线时代
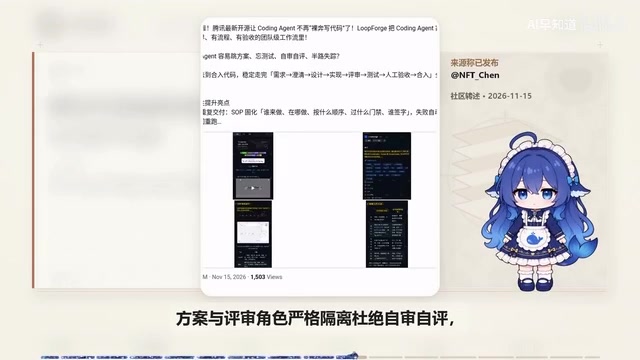
腾讯以 MIT 协议开源自托管编程工作台 LoopForge,把智能体写代码纳入标准化流水线,覆盖需求、设计、评审、测试到人工验收。写入方案与评审角色严格隔离,杜绝自审自评,全程跑在 Docker 沙箱并支持十多种命令型工具。
同日,阿里把内部打磨两年的代码审查工具 OpenCodeReview 开源,已在 GitHub 突破五万星并冲上日榜第一。它采用确定性工程加智能体的混合架构,选文件与定位规则用代码硬控,模型专注动态判断,评论精确到具体行,只用一条 NPM 命令就能接入主流编程工具,为团队提供免费高效的审查替代方案。
分词器迎来洗牌,端侧小模型打开新空间
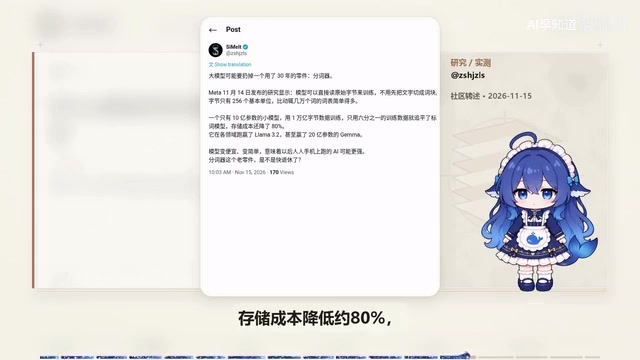
大模型沿用多年的分词器可能迎来洗牌。Meta 发布的新研究证明,模型可以跳过分词直接读取原始字节训练,把动辄几万词的词表简化成 256 个基础单位。十亿参数模型仅用约六分之一的训练数据就追平传统分词模型,存储成本降低约 80%,甚至跑赢了 20 亿参数的 Gemma,为端侧小模型打开新空间。
本地推理方面,博科利与 MIT 联合推出开源引擎 Free Token,通过动态调度 CPU 与 GPU 算力以及智能专家缓存,让 RTX5090 搭配大内存运行 DeepSeek 达到每秒 22 到 25 个 token 的吞吐,比现有引擎快 1.3 到 2.1 倍,还能直接作为 Cloud Code 的本地免费后端。
分词器(Tokenizer)是把文本切分成模型可处理单元的前置组件,主流做法是 BPE 或 SentencePiece,词表规模通常在数万到十几万之间。词表越大,单个 token 承载的语义越多、序列越短,但嵌入矩阵和输出层参数随之膨胀,且对拼写错误、罕见语言和代码符号的覆盖容易出现盲区。字节级建模则绕过词表,直接把原始 UTF-8 字节作为输入,词表可压缩到 256 个基础单位,天然具备多语言与抗噪声能力,代价是序列变长、训练与推理效率需要额外优化。Meta 的研究正是在这一权衡上取得突破,使无分词器方案在小参数规模下具备实用价值。
智能体投资回报与开发者福利
Perplexity 公布内部账单:上线一周后,队友智能体周工时已达 9 月的 11 倍,省出整天或整周工时的员工翻了 3 倍多。按全年估算,约 1000 万美元的投入换回 8000 万到 1.8 亿美元的劳动价值,回报率达到 9 到 19 倍。
开发者算力福利方面,Verso 宣布将每月额度从 80 美元提到 150 美元,团队月费保持 30 美元不变,额度覆盖 Pimi K3.1 Pro、GLM5.3 和 DeepSeek V4.1 Flash 等开放权重模型,使用专用密钥用完即停且不产生超额账单。
智能体投资回报率(ROI)的测算通常把订阅或算力成本与节省的人力工时折算成货币价值对比,但这类口径需要注意两点:一是节省的工时未必全部转化为产出,二是智能体的产出仍需人工复核。Perplexity 公布的 9 到 19 倍回报属于厂商自报数据,样本局限于内部团队,外推到其他组织时应保持谨慎。更稳妥的评估方式是先在单一高频、低风险流程中小规模试点,记录任务完成率、返工率与人工介入次数,再决定是否扩大部署。
其他动向:Grok 灰度推送与安全模型门槛降低
海外博主 Mark 称,不少用户反馈 Grok 4.8 正面向 GrokBot 灰度推送,背后强化学习与推理系统已由 C 与 C++ 从零重写。但官网仍未发布公告,接口停留在 4.7 版本,该推送尚未被独立证实。
Anthropic 则放宽了 Cloud Mephos 的申请条件,个人安全研究员无需漏洞编号或企业认证,只需拥有 Cloud 付费订阅或接口账户并通过身份核验即可申请,有测试者称一小时内就获批,但攻击性用途依然受限。
开源模型的科研价值也获得对手研究员罕见点赞。OpenAI 研究员公开感谢开源生态,直言没有现代开放权重模型,学者们很难做出优秀的机理可解释性研究,期盼技术生态能长期保留开源空间。
相关推荐
戈登·拉姆齐对决米其林父子:加利西亚美食寻味记
戈登·拉姆齐深入西班牙加利西亚,与米其林两星主厨佩佩·维埃拉展开美食对决。从死亡海岸的鹅颈藤壶到传统石炉面包,探索加利西亚独特的饮食文化与食材故事。

Soundcore Liberty 5 Pro降至历史低价:通勤通话首选真无线耳机
Soundcore Liberty 5 Pro真无线耳机降至129.99美元历史低价,原价169.99美元。这款Anker旗下声阔耳机以通话质量见长,在Amazon、Best Buy和Walmart同步促销,提供四种配色,适合通勤和线上会议用户。

15年经验程序员失业两年:AI时代的技术人困境
一位15年经验的美国高级软件工程师失业两年,积蓄耗尽,求助Hacker News。本文分析技术人长期失业的结构性原因、简历空窗期的应对策略,以及AI时代经验价值的重新定义。